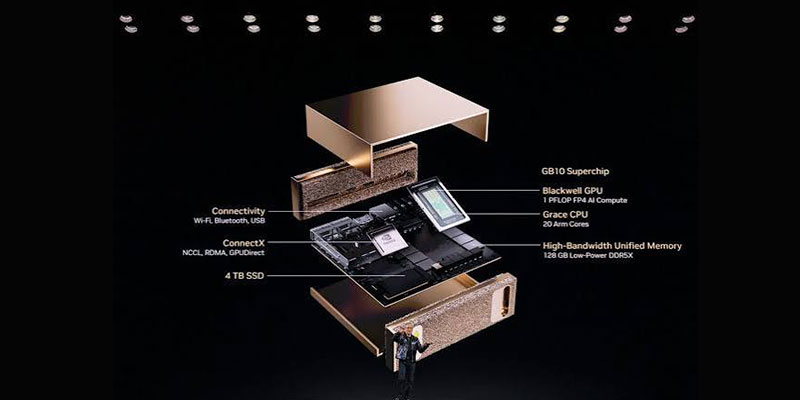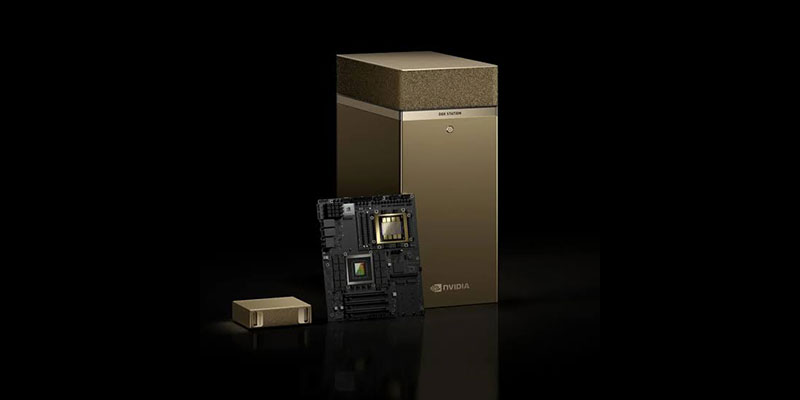
Nvidia DGX Station

معرفی سوپر کامپیوتر هوش مصنوعی Nvidia DGX Station

Nvidia DGX Station یکی از پیشرفته‌ترین سوپرکامپیوترهای رومیزی جهان است که شرکت NVIDIA آن را برای توسعه، آموزش و اجرای مدل‌های هوش مصنوعی، یادگیری عمیق و مدل‌های زبانی بزرگ طراحی کرده است. در سال‌های اخیر با رشد سریع فناوری هوش مصنوعی و افزایش حجم داده‌ها، نیاز به سخت‌افزارهایی که بتوانند پردازش‌های سنگین را در مدت‌زمان کوتاه انجام دهند بیش از هر زمان دیگری احساس می‌شود. خانواده Nvidia DGX Station  دقیقاً با همین هدف توسعه پیدا کرده تا قدرت پردازشی در سطح دیتاسنتر را در قالب یک سیستم مستقل و قابل استفاده در محیط‌های کاری، آزمایشگاهی و تحقیقاتی ارائه دهد.


برخلاف ورک‌استیشن‌های معمولی، این سیستم تنها به سخت‌افزار قدرتمند محدود نمی‌شود. انویدیا مجموعه‌ای از نرم‌افزارها، کتابخانه‌ها و ابزارهای تخصصی مانند CUDA، TensorRT، NCCL، NVIDIA AI Enterprise  و NVIDIA NGC را نیز در اختیار کاربران قرار می‌دهد تا فرآیند توسعه مدل‌های هوش مصنوعی سریع‌تر، پایدارتر و بهینه‌تر انجام شود.

در ادامه این مقاله با معماری، ویژگی‌ها، مشخصات فنی، کاربردها، مزایا و دلایل محبوبیت . Nvidia DGX Station آشنا خواهیم شد.

Nvidia DGX Station چیست؟

سیستم Nvidia DGX Station  یک سوپرکامپیوتر هوش مصنوعی رومیزی (Desktop A Supercomputer) است که برای اجرای پروژه‌های سنگین هوش مصنوعی، یادگیری ماشین (Machine Learning)،  یادگیری عمیق (Deep Learning) ، پردازش تصویر، تحلیل داده و مدل‌های مولد طراحی شده است.

هدف اصلی انویدیا از تولید این محصول، فراهم کردن توان پردازشی بسیار بالا بدون نیاز به راه‌اندازی یک دیتاسنتر کامل بوده است. به همین دلیل، کاربران می‌توانند از قدرت چندین پردازنده گرافیکی حرفه‌ای در یک سیستم یکپارچه استفاده کنند.

این دستگاه‌ها برای افراد و سازمان‌هایی مناسب هستند که روی پروژه‌های پیشرفته AI کار می‌کنند و به توان پردازشی بالا، حافظه گرافیکی زیاد و پهنای باند بسیار سریع نیاز دارند.
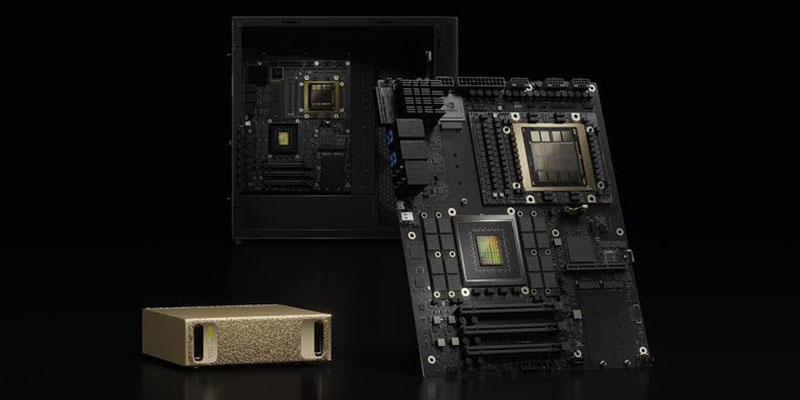
Nvidia DGX Station

از مهم‌ترین کاربران این محصول می‌توان به موارد زیر اشاره کرد:

  • شرکت‌های فعال در حوزه هوش مصنوعی
  • دانشگاه‌ها و مراکز تحقیقاتی
  • آزمایشگاه‌های پزشکی
  • شرکت‌های خودروسازی
  • مراکز پردازش تصویر
  • سازمان‌های مالی
  • شرکت‌های توسعه مدل‌های زبانی بزرگ (LLM)

ویژگی‌های سخت‌افزاری Nvidia DGX Station

یکی از مهم‌ترین دلایل محبوبیت Nvidia DGX Station  سخت‌افزار قدرتمند آن است. این سیستم از ابتدا برای اجرای مدل‌های بسیار بزرگ طراحی شده و تقریباً تمام اجزای آن با هدف افزایش سرعت پردازش انتخاب شده‌اند.

مهم‌ترین مشخصات سخت‌افزاری عبارت‌اند از:

  • پردازنده‌های گرافیکی حرفه‌ای NVIDIA
  • Tensor Core برای پردازش هوش مصنوعی
  • حافظه گرافیکی HBM با ظرفیت بالا
  • پردازنده مرکزی قدرتمند
  • حافظه رم ECC با ظرفیت بالا
  • حافظه SSD NVMe پرسرعت
  • ارتباط NVLink بین GPU ها
  • شبکه پرسرعت برای اتصال به زیرساخت‌های سازمانی
  • سیستم خنک‌کننده مهندسی‌شده برای عملکرد پایدار

ترکیب این تجهیزات باعث می‌شود  Nvidia DGX Station بتواند حجم بسیار زیادی از داده‌ها را بدون افت عملکرد پردازش کند.

مزایای Nvidia DGX Station برای توسعه هوش مصنوعی

یکی از مهم‌ترین مزیت‌های Nvidia DGX Station  این است که تمام ابزارهای موردنیاز توسعه‌دهندگان هوش مصنوعی را در یک پلتفرم یکپارچه ارائه می‌دهد. کاربران پس از راه‌اندازی سیستم می‌توانند به‌سرعت محیط توسعه خود را آماده کرده و آموزش مدل‌ها را آغاز کنند.

Nvidia DGX Station

مهم‌ترین مزایا عبارت‌اند از:

  • آموزش سریع مدل‌های     Deep Learning
  • اجرای مدل‌های زبانی بزرگ (LLM)
  • مناسب برای مدل‌های مولد مانند GPT و Stable Diffusion
  • پشتیبانی از CUDA و TensorRT
  • امکان اجرای هم‌زمان چندین پروژه
  • کاهش زمان آموزش مدل
  • قابلیت توسعه در محیط‌های سازمانی
  • امنیت و پایداری بالا
  • مدیریت آسان منابع پردازشی

به لطف این قابلیت‌ها، زمان توسعه پروژه‌ها کاهش پیدا می‌کند و تیم‌های فنی می‌توانند تمرکز خود را روی بهبود مدل‌ها قرار دهند.

Nvidia DGX Station  و معماری پیشرفته  Blackwell

نسل جدید Nvidia DGX Station  بر پایه معماری Blackwell توسعه یافته است. این معماری نسبت به نسل‌های قبلی، عملکرد بالاتر و مصرف انرژی بهینه‌تری ارائه می‌دهد و برای اجرای مدل‌های هوش مصنوعی نسل جدید طراحی شده است.

در این نسل از پردازنده‌های گرافیکی جدید، تعداد  Tensor Coreها افزایش یافته و سرعت پردازش عملیات ماتریسی نیز بیشتر شده است. همچنین استفاده از فناوری NVLink  با پهنای باند بسیار بالا، ارتباط میان پردازنده‌های گرافیکی را سریع‌تر کرده و گلوگاه انتقال داده را به حداقل رسانده است.

ترکیب معماری Blackwell با پردازنده Grace در برخی مدل‌ها باعث می‌شود پردازش‌های CPU و GPU هماهنگی بیشتری داشته باشند. این ویژگی به‌ویژه هنگام آموزش مدل‌های چندصد میلیارد پارامتری اهمیت زیادی دارد.

کاربردهای Nvidia DGX Station در صنایع مختلف

کاربرد Nvidia DGX Station  تنها به توسعه مدل‌های هوش مصنوعی محدود نمی‌شود. بسیاری از صنایع از این سیستم برای انجام پردازش‌های سنگین استفاده می‌کنند.

از مهم‌ترین کاربردها می‌توان به موارد زیر اشاره کرد:

پزشکی

تحلیل تصاویر پزشکی، تشخیص بیماری، پردازش MRI و توسعه مدل‌های تشخیص هوشمند.

خودروسازی

آموزش مدل‌های خودروهای خودران، پردازش داده‌های سنسورها و توسعه سیستم‌های کمک‌راننده.

بانکداری

تحلیل ریسک، کشف تقلب، تحلیل رفتار مشتریان و پیش‌بینی بازار.

دانشگاه‌ها

تحقیقات علمی، آموزش مدل‌های تحقیقاتی و توسعه پروژه‌های پردازش زبان طبیعی.

صنایع تولیدی

کنترل کیفیت مبتنی بر بینایی ماشین، پیش‌بینی خرابی تجهیزات و بهینه‌سازی خطوط تولید.

Nvidia DGX Station  برای مدل‌های زبانی بزرگ (LLM)

در سال‌های اخیر مدل‌های زبانی بزرگ مانند  GPT،  Llama و سایر مدل‌های متن‌محور به حافظه و توان پردازشی بسیار زیادی نیاز پیدا کرده‌اند . Nvidia DGX Station  دقیقاً برای پاسخ به چنین نیازهایی طراحی شده است.

حافظه گرافیکی بالا، پردازنده‌های گرافیکی قدرتمند و ارتباط سریع میان GPU ها باعث می‌شود آموزش، Fine-tuning  و اجرای مدل‌های LLM با سرعت بیشتری انجام شود. همچنین این سیستم از کتابخانه‌ها و فریم‌ورک‌های محبوب مانند PyTorch ، TensorFlow و JAX به‌صورت کامل پشتیبانی می‌کند.

برای تیم‌هایی که قصد توسعه مدل اختصاصی هوش مصنوعی دارند، استفاده از این سیستم می‌تواند زمان توسعه را به شکل قابل‌توجهی کاهش دهد.

Nvidia DGX Station

چرا Nvidia DGX Station انتخاب مناسبی برای سازمان‌ها است؟

سازمان‌های بزرگ معمولاً به زیرساختی نیاز دارند که علاوه بر قدرت پردازشی، قابلیت اطمینان و مدیریت آسان نیز داشته باشد. Nvidia DGX Station به دلیل طراحی یکپارچه، نرم‌افزارهای آماده و اکوسیستم کامل انویدیا، این نیاز را به‌خوبی برطرف می‌کند.

مزایای سازمانی این سیستم شامل موارد زیر است:

  • کاهش هزینه راه‌اندازی نسبت به ساخت کلاستر اختصاصی
  • استقرار سریع در محیط کاری
  • مدیریت ساده منابع
  • پشتیبانی از NVIDIA AI Enterprise
  • امکان توسعه زیرساخت در آینده
  • امنیت بالا
  • پایداری در پردازش‌های طولانی‌مدت

این ویژگی‌ها باعث شده‌اند که بسیاری از شرکت‌های فناوری، استارتاپ‌های AI و مراکز تحقیقاتی، Nvidia DGX Station  را به‌عنوان هسته اصلی زیرساخت پردازشی خود انتخاب کنند.

آینده Nvidia DGX Station

روند توسعه هوش مصنوعی نشان می‌دهد که مدل‌ها هر سال بزرگ‌تر و پیچیده‌تر می‌شوند. بنابراین نیاز به سیستم‌هایی با حافظه بیشتر، پهنای باند بالاتر و توان پردازشی قوی‌تر نیز افزایش خواهد یافت.

انویدیا با توسعه نسل‌های جدید DGX Station و استفاده از معماری‌های نوین مانند Grace Blackwell، تلاش کرده است محصولی ارائه دهد که علاوه بر پاسخ‌گویی به نیازهای امروز، برای پروژه‌های آینده نیز آماده باشد. انتظار می‌رود نسل‌های بعدی این خانواده از حافظه سریع‌تر، ارتباط داخلی قدرتمندتر و قابلیت‌های پیشرفته‌تر برای اجرای مدل‌های چندوجهی و عامل‌های هوش مصنوعی (AI Agents) بهره‌مند شوند.

سخن آخر

اگر به دنبال یک سیستم حرفه‌ای برای توسعه، آموزش و اجرای مدل‌های هوش مصنوعی هستید، Nvidia DGX Station  یکی از بهترین گزینه‌های موجود در بازار به شمار می‌رود. این سوپرکامپیوتر رومیزی با بهره‌گیری از پردازنده‌های گرافیکی پیشرفته، حافظه پرسرعت، فناوری NVLink و اکوسیستم نرم‌افزاری کامل  NVIDIA، محیطی ایده‌آل برای اجرای پروژه‌های سنگین AI فراهم می‌کند.

چه یک شرکت فعال در حوزه هوش مصنوعی باشید، چه یک مرکز تحقیقاتی یا یک تیم توسعه نرم‌افزار، Nvidia DGX Station  می‌تواند سرعت توسعه مدل‌ها، کیفیت پردازش و بهره‌وری تیم شما را به شکل محسوسی افزایش دهد. سرمایه‌گذاری روی چنین زیرساختی، تنها خرید یک سیستم قدرتمند نیست؛ بلکه گامی مهم برای ورود به نسل جدید محاسبات هوش مصنوعی و آماده شدن برای آینده فناوری است.
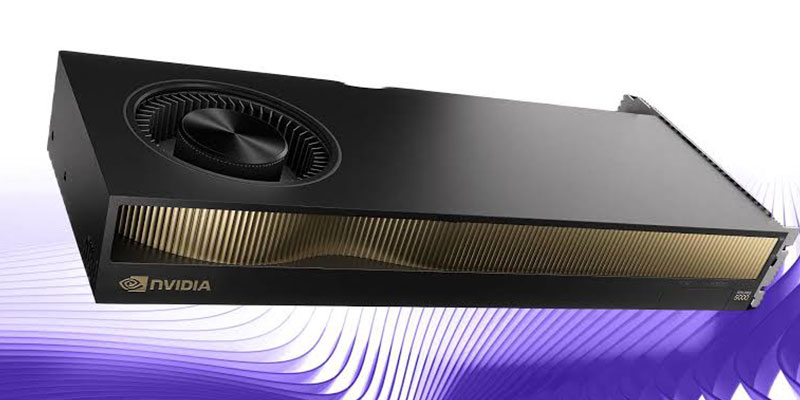
RTX Pro Desktop

مقایسه کارت گرافیک های RTX pro desktop

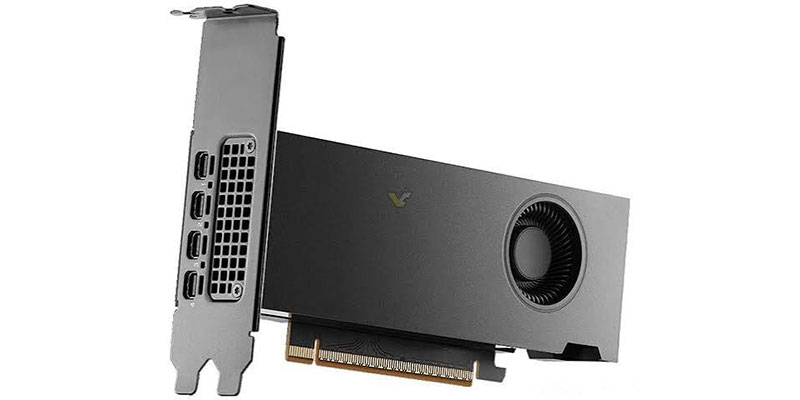
RTX pro desktop نسل جدید کارت‌های گرافیک حرفه‌ای انویدیا است که برای پردازش‌های مهندسی، طراحی سه‌بعدی، هوش مصنوعی، شبیه‌سازی، رندرینگ و تولید محتوا توسعه یافته است. برخلاف کارت‌های گیمینگ که تمرکز اصلی آن‌ها اجرای بازی‌ها است، سری RTX Pro Desktop برای پایداری، دقت محاسبات، درایورهای حرفه‌ای و سازگاری با نرم‌افزارهای تخصصی طراحی شده‌اند. اگر قصد خرید یک ورک‌استیشن قدرتمند دارید، شناخت تفاوت مدل‌های مختلف این خانواده اهمیت زیادی دارد.

RTX pro desktop

در این مقاله به مقایسه کامل مدل‌های مختلف  RTX pro desktop می‌پردازیم، مزایا و معایب هر مدل را بررسی می‌کنیم و در نهایت به شما کمک خواهیم کرد مناسب‌ترین گزینه را بر اساس نوع پروژه و بودجه انتخاب کنید.

چرا RTX pro desktop نسبت به کارت‌های گیمینگ انتخاب بهتری است؟

بسیاری از کاربران تصور می‌کنند خرید یک کارت گرافیک گیمینگ پرقدرت می‌تواند جایگزین مناسبی برای کارت‌های حرفه‌ای باشد؛ اما در پروژه‌های صنعتی، مهندسی و هوش مصنوعی شرایط متفاوت است.

کارت‌های RTX pro desktop  علاوه بر قدرت پردازشی بالا، از درایورهای NVIDIA Studio و Enterprise بهره می‌برند که برای نرم‌افزارهایی مانند:

بهینه‌سازی شده‌اند.

همچنین این کارت‌ها دارای قابلیت‌هایی مانند ECC Memory، دقت بالاتر در محاسبات، پایداری طولانی‌مدت، پشتیبانی بهتر از Virtualization، پردازش‌های AI و مدیریت حافظه حرفه‌ای هستند.

مدل‌های مختلف RTX pro desktop

انویدیا خانواده RTX Pro Desktop را برای کاربران مختلف طراحی کرده است. هر مدل برای سطح مشخصی از پردازش مناسب است.

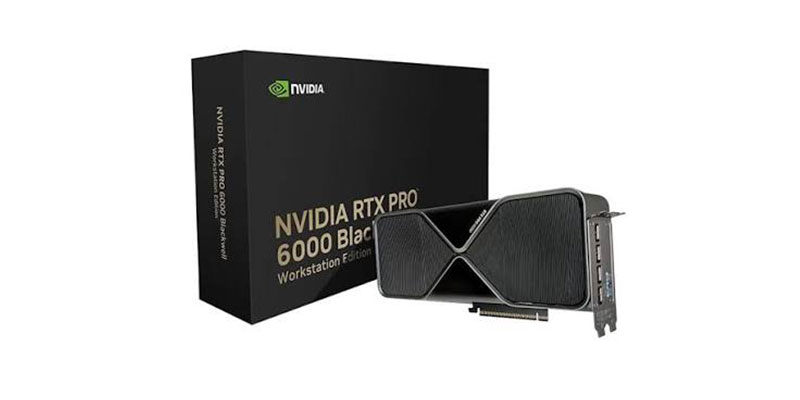
RTX PRO 6000

این مدل قدرتمندترین عضو خانواده محسوب می‌شود.

ویژگی‌های اصلی:

  • حافظه گرافیکی بسیار بالا
  • تعداد زیاد CUDA Core
  • Tensor Core نسل جدید
  • Ray Tracing Core  پیشرفته
  • مناسب آموزش مدل‌های   AI
  • مناسب پردازش‌های سنگین CAD
  • مناسب شبیه‌سازی صنعتی
  • مناسب رندرینگ سینمایی
  • عملکرد فوق‌العاده در پردازش‌های چند  GPU

این کارت بیشتر برای شرکت‌های بزرگ، مراکز تحقیقاتی و تیم‌های تولید محتوای حرفه‌ای پیشنهاد می‌شود.

RTX PRO 5000

مدل RTX PRO 5000 تعادل بسیار خوبی میان قیمت و عملکرد ایجاد می‌کند.

این کارت برای پروژه‌های:

  • BIM
  • معماری
  • طراحی صنعتی
  • طراحی محصول
  • انیمیشن
  • تدوین ویدئو
  • پروژه‌های AI متوسط
  • پردازش تصویر

کاملاً مناسب است.

بسیاری از شرکت‌های طراحی، این مدل را بهترین نقطه تعادل میان هزینه و قدرت می‌دانند.

RTX PRO 4500

این مدل بیشتر برای شرکت‌های متوسط طراحی شده است.

کاربردهای آن شامل:

  • طراحی CAD
  • مدل‌سازی سه‌بعدی
  • تدوین حرفه‌ای
  • ساخت انیمیشن
  • طراحی کارخانه
  • مهندسی مکانیک
  • مهندسی برق

در مقایسه با مدل‌های بالاتر، مصرف انرژی پایین‌تر و قیمت اقتصادی‌تری دارد.

RTX PRO 4000

RTX PRO 4000 یکی از محبوب‌ترین اعضای خانواده محسوب می‌شود.

این کارت برای کاربران زیر مناسب است:

  • مهندسین عمران
  • معماران
  • طراحان داخلی
  • گرافیست‌ها
  • تدوین‌گران
  • کاربران Blender
  • کاربران Adobe

در بسیاری از پروژه‌های روزمره عملکردی کاملاً روان ارائه می‌دهد.

مقایسه RTX pro desktop از نظر قدرت پردازشی

قدرت پردازشی مهم‌ترین معیار انتخاب کارت گرافیک حرفه‌ای است.هرچه تعداد CUDA Core بیشتر باشد، سرعت انجام محاسبات نیز افزایش پیدا می‌کند.

از طرف دیگر Tensor Core نقش مهمی در پردازش‌های هوش مصنوعی دارد. Ray Tracing Core نیز کیفیت نورپردازی و رندرهای Real-Time را افزایش می‌دهد.

RTX pro desktop

به طور کلی ترتیب قدرت پردازشی به شکل زیر است:

  1. RTX PRO 6000
  2. RTX PRO 5000
  3. RTX PRO 4500
  4. RTX PRO 4000

البته انتخاب بهترین گزینه کاملاً به نوع پروژه بستگی دارد و همیشه خرید قوی‌ترین مدل بهترین تصمیم نیست.

مقایسه RTX pro desktop از نظر حافظه گرافیکی

یکی از مهم‌ترین تفاوت‌های مدل‌های مختلف، میزان VRAM است. هرچه پروژه بزرگ‌تر باشد، حافظه بیشتری نیاز خواهید داشت.

برای مثال:

  • پروژه‌های معماری بزرگ
  • مدل‌های هوش مصنوعی
  • پردازش تصاویر پزشکی
  • رندرهای 8K
  • شبیه‌سازی‌های CFD
  • پروژه‌های دیجیتال تویین

همگی به حافظه بالاتری نیاز دارند. اگر حجم پروژه‌های شما محدود است، خرید مدل‌های اقتصادی‌تر منطقی‌تر خواهد بود.

مقایسه RTX pro desktop برای هوش مصنوعی

در سال‌های اخیر استفاده از کارت‌های گرافیک حرفه‌ای برای آموزش مدل‌های AI رشد چشمگیری داشته است.

سری  RTX pro desktop به دلیل برخورداری از Tensor Core نسل جدید، عملکرد بسیار مناسبی در اجرای مدل‌های زیر دارد:

  • Llama
  • Stable Diffusion
  • TensorFlow
  • PyTorch
  • NVIDIA NIM
  • CUDA
  • RAPIDS

برای پروژه‌های تحقیقاتی بزرگ معمولاً RTX PRO 6000 انتخاب اول است، اما برای توسعه مدل‌های متوسط، RTX PRO 5000 نیز عملکرد بسیار مطلوبی ارائه می‌دهد.

مقایسه RTX pro desktop برای رندرینگ

اگر با موتورهای رندر مانند:

کار می‌کنید، قدرت GPU اهمیت بسیار زیادی پیدا می‌کند.

مدل‌های بالاتر زمان رندر را به شکل محسوسی کاهش می‌دهند و امکان پردازش پروژه‌های سنگین را بدون افت عملکرد فراهم می‌کنند.

در استودیوهای تولید انیمیشن معمولاً از چند کارت RTX Pro به صورت هم‌زمان استفاده می‌شود.

مقایسه RTX pro desktop از نظر مصرف انرژی

یکی از مزایای مهم این خانواده، بهره‌وری انرژی مناسب است.هرچند مدل RTX PRO 6000 بیشترین مصرف را دارد، اما نسبت عملکرد به مصرف انرژی آن همچنان بسیار مطلوب است.مدل‌های RTX PRO 4000 و RTX PRO 4500 برای ورک‌استیشن‌هایی با توان مصرفی محدود گزینه‌های مناسبی هستند.

همچنین سیستم خنک‌کننده حرفه‌ای این کارت‌ها باعث می‌شود عملکرد آن‌ها حتی در بار کاری طولانی نیز پایدار باقی بماند.

RTX pro desktop

چه کسانی باید RTX PRO 4000 بخرند؟

این مدل برای افراد زیر مناسب است:

  • دفاتر معماری
  • شرکت‌های طراحی
  • گرافیست‌ها
  • کاربران Adobe
  • پروژه‌های CAD
  • طراحی سه‌بعدی سبک
  • کاربران Blender

اگر حجم پروژه‌های شما متوسط است، این مدل ارزش خرید بالایی دارد.

چه کسانی باید RTX PRO 5000 را انتخاب کنند؟

اگر روزانه با پروژه‌های سنگین سروکار دارید،  RTX PRO 5000 انتخاب هوشمندانه‌ای است.

این کارت برای:

  • شرکت‌های مهندسی
  • طراحی صنعتی
  • BIM
  • کارخانه‌ها
  • انیمیشن‌سازی
  • تدوین 8K
  • پروژه‌های AI

عملکرد بسیار مناسبی ارائه می‌دهد.

چه کسانی به RTX PRO 6000 نیاز دارند؟

قوی‌ترین مدل این خانواده بیشتر برای سازمان‌ها طراحی شده است. و برای سیستم های هوش مصنوعی و پیاده سازی مدل های هوش مصنوعی گزینه مناسبی می باشد.

کاربردهای اصلی آن عبارت‌اند از:

  • آموزش مدل‌های بزرگ هوش مصنوعی
  • Digital Twin
  • پردازش داده‌های عظیم
  • مراکز تحقیقاتی
  • رندرینگ سینمایی
  • پزشکی
  • نفت و گاز
  • شبیه‌سازی‌های مهندسی

اگر پروژه‌های شما بسیار سنگین هستند، سرمایه‌گذاری روی این مدل در بلندمدت کاملاً منطقی خواهد بود.

هنگام خرید RTX pro desktop به چه نکاتی توجه کنیم؟

پیش از خرید بهتر است موارد زیر را بررسی کنید:

  • میزان حافظه مورد نیاز پروژه‌ها
  • نوع نرم‌افزارهای مورد استفاده
  • توان منبع تغذیه سیستم
  • فضای داخلی کیس
  • امکان ارتقای آینده
  • بودجه
  • نیاز به چند GPU
  • سازگاری با پردازنده و مادربرد
  • ظرفیت رم سیستم
  • نوع سیستم خنک‌کننده

توجه به این موارد باعث می‌شود بهترین بازدهی را از کارت گرافیک حرفه‌ای خود دریافت کنید.

سخن آخر

انتخاب یک کارت گرافیک حرفه‌ای تنها به مشخصات سخت‌افزاری محدود نمی‌شود؛ بلکه باید نوع پروژه، نرم‌افزارهای مورد استفاده، حجم پردازش، بودجه و برنامه توسعه آینده را نیز در نظر بگیرید. خانواده RTX pro desktop  با ارائه مدل‌های متنوع، نیاز کاربران مختلف از طراحان و مهندسان گرفته تا پژوهشگران هوش مصنوعی و استودیوهای تولید محتوا را پوشش می‌دهد.

اگر بیشتر روی پروژه‌های  CAD، طراحی سه‌بعدی و تدوین ویدئو کار می‌کنید، مدل‌های RTX PRO 4000 و RTX PRO 4500 انتخاب‌های مقرون‌به‌صرفه‌ای هستند. برای پروژه‌های سنگین‌تر،  RTX PRO 5000 تعادل بسیار خوبی میان قیمت و توان پردازشی ایجاد می‌کند. در نهایت، اگر با مدل‌های بزرگ هوش مصنوعی، شبیه‌سازی‌های پیچیده یا رندرینگ حرفه‌ای سروکار دارید،  RTX PRO 6000 بهترین گزینه خواهد بود.

در نهایت، بررسی دقیق نیازهای کاری و انتخاب متناسب با آن، مهم‌ترین عامل برای داشتن یک ورک‌استیشن قدرتمند، پایدار و آینده‌نگر است.

معرفی سوپر تراشه RTX SPARK

معرفی سوپر تراشه RTX SPARK

انقلابی جدید در دنیای پردازش هوش مصنوعی سوپر تراشه RTX SPARK یکی از جدیدترین دستاوردهای شرکت انویدیا در حوزه پردازش هوش مصنوعی و رایانش پیشرفته است که توجه بسیاری از متخصصان فناوری را به خود جلب کرده است. در سال‌های اخیر نیاز به سخت‌افزارهای قدرتمند برای اجرای مدل‌های هوش مصنوعی، پردازش داده‌های حجیم و تولید محتوا به شدت افزایش یافته و شرکت‌های بزرگ فناوری تلاش کرده‌اند محصولاتی متناسب با این نیازها توسعه دهند. در همین راستا، انویدیا با معرفی سوپر تراشه RTX SPARK قدم مهمی در مسیر آینده رایانش شخصی و حرفه‌ای برداشته است.

این تراشه تنها یک پردازنده معمولی نیست؛ بلکه یک پلتفرم کامل محسوب می‌شود که پردازنده مرکزی، پردازنده گرافیکی و قابلیت‌های پیشرفته هوش مصنوعی را در یک مجموعه قدرتمند ترکیب می‌کند. به همین دلیل بسیاری از کارشناسان معتقدند سوپر تراشه RTX SPARK می‌تواند نقش مهمی در نسل بعدی کامپیوترهای هوشمند ایفا کند.

سوپر تراشه RTX SPARK چیست؟

سوپر تراشه RTX SPARK یک پردازنده پیشرفته مبتنی بر فناوری‌های جدید انویدیا است که برای اجرای پردازش‌های سنگین، مدل‌های هوش مصنوعی و نرم‌افزارهای حرفه‌ای طراحی شده است. این تراشه از ترکیب پردازنده مرکزی مبتنی بر معماری Grace و پردازنده گرافیکی Blackwell RTX بهره می‌برد و به لطف طراحی یکپارچه خود، عملکرد بسیار بالایی را در اختیار کاربران قرار می‌دهد.

برخلاف سیستم‌های سنتی که در آن پردازنده مرکزی و گرافیکی به صورت جداگانه فعالیت می‌کنند، در این معماری ارتباط میان بخش‌های مختلف با سرعت بسیار بیشتری انجام می‌شود. نتیجه این طراحی، کاهش تأخیر و افزایش چشمگیر سرعت پردازش داده‌ها است.

یکی از مهم‌ترین اهداف طراحی سوپر تراشه RTX SPARK، فراهم کردن امکان اجرای مدل‌های هوش مصنوعی به صورت محلی است. در گذشته بسیاری از کاربران برای اجرای مدل‌های بزرگ هوش مصنوعی مجبور بودند از سرورهای ابری استفاده کنند، اما اکنون این قابلیت روی یک کامپیوتر شخصی نیز قابل دسترس است.

علاوه بر این، پشتیبانی از حافظه یکپارچه با ظرفیت بالا باعث می‌شود حجم زیادی از داده‌ها بدون ایجاد گلوگاه پردازشی مدیریت شوند. این موضوع برای توسعه‌دهندگان، پژوهشگران و تولیدکنندگان محتوا اهمیت زیادی دارد.

مشخصات فنی سوپر تراشه RTX SPARK

وقتی صحبت از سوپر تراشه RTX SPARK می‌شود، مشخصات فنی آن یکی از مهم‌ترین بخش‌هایی است که توجه کاربران حرفه‌ای را جلب می‌کند. انویدیا در طراحی این محصول از جدیدترین فناوری‌های خود استفاده کرده تا بتواند نیازهای نسل جدید نرم‌افزارها را پاسخ دهد.

معرفی سوپر تراشه  RTX SPARK

مهم‌ترین مشخصات این تراشه عبارت‌اند از:

  • پردازنده مرکزی NVIDIA Grace
  • پردازنده گرافیکی Blackwell RTX
  • بیش از 6000 هسته CUDA
  • نسل پنجم Tensor Core
  • پشتیبانی از رهگیری پرتو (Ray Tracing)
  • حافظه یکپارچه با ظرفیت بالا
  • فناوری NVLink-C2C
  • توان پردازش هوش مصنوعی در سطح بسیار بالا
  • پشتیبانی کامل از CUDA و TensorRT
  • بهینه‌سازی برای سیستم‌های مبتنی بر هوش مصنوعی

این مشخصات نشان می‌دهد که سوپر تراشه RTX SPARK صرفاً برای کاربران عادی طراحی نشده است، بلکه توسعه‌دهندگان هوش مصنوعی، طراحان سه‌بعدی، مهندسان و تولیدکنندگان محتوا نیز جزو مخاطبان اصلی آن محسوب می‌شوند.

قدرت پردازشی بالا در کنار مصرف انرژی بهینه باعث شده این تراشه بتواند عملکردی فراتر از بسیاری از سیستم‌های فعلی بازار ارائه دهد.

معماری Blackwell در سوپر تراشه RTX SPARK

یکی از مهم‌ترین فناوری‌های به‌کاررفته در سوپر تراشه RTX SPARK معماری Blackwell است. این معماری جدیدترین نسل پردازنده‌های گرافیکی انویدیا محسوب می‌شود و نسبت به نسل‌های قبلی بهبودهای چشمگیری را ارائه می‌دهد.

Blackwell برای پردازش‌های هوش مصنوعی طراحی شده و عملکرد بسیار بالایی در اجرای مدل‌های زبانی بزرگ، تولید تصویر، پردازش ویدئو و یادگیری ماشین دارد. هسته‌های Tensor جدید می‌توانند عملیات مرتبط با هوش مصنوعی را با سرعت بسیار بیشتری نسبت به نسل‌های قبل انجام دهند.

از طرف دیگر، فناوری Ray Tracing نیز در این معماری ارتقا یافته است. این ویژگی به بازی‌سازان و طراحان گرافیکی اجازه می‌دهد تصاویر واقع‌گرایانه‌تری تولید کنند.

وجود معماری Blackwell در سوپر تراشه RTX SPARK باعث شده این محصول علاوه بر کاربردهای حرفه‌ای، برای اجرای بازی‌های نسل جدید نیز گزینه‌ای قدرتمند باشد.

همچنین بهینه‌سازی‌های انجام‌شده در مصرف انرژی موجب شده کاربران بتوانند بدون نگرانی از افزایش مصرف برق، از حداکثر توان سخت‌افزار استفاده کنند.

کاربردهای سوپر تراشه RTX SPARK در هوش مصنوعی

امروزه هوش مصنوعی به بخش مهمی از دنیای فناوری تبدیل شده است و بسیاری از کسب‌وکارها برای انجام فعالیت‌های خود به ابزارهای مبتنی بر AI وابسته هستند. در چنین شرایطی سوپر تراشه RTX SPARK می‌تواند نقش بسیار مهمی در توسعه این فناوری ایفا کند.

معرفی سوپر تراشه  RTX SPARK

این تراشه قادر است مدل‌های زبانی بزرگ، سیستم‌های تولید تصویر، نرم‌افزارهای پردازش ویدئو و ابزارهای تحلیل داده را با سرعت بالا اجرا کند. توسعه‌دهندگان می‌توانند مدل‌های خود را بدون نیاز به سرویس‌های ابری آموزش دهند یا آزمایش کنند.

یکی از مزایای مهم اجرای محلی هوش مصنوعی، حفظ امنیت اطلاعات است. بسیاری از شرکت‌ها تمایل ندارند داده‌های حساس خود را روی سرورهای ابری قرار دهند. به همین دلیل سوپر تراشه RTX SPARK می‌تواند راهکاری مناسب برای این دسته از کاربران باشد.

همچنین تولیدکنندگان محتوا می‌توانند از این تراشه برای تولید تصاویر هوش مصنوعی، ویرایش ویدئو، ساخت انیمیشن و پردازش فایل‌های حجیم استفاده کنند. در نتیجه زمان انجام پروژه‌ها به شکل قابل توجهی کاهش پیدا می‌کند.

مقایسه سوپر تراشه RTX SPARK با Apple M4

یکی از مقایسه‌های جذاب در بازار فناوری، مقایسه سوپر تراشه RTX SPARK با تراشه‌های سری Apple Silicon به‌ویژه Apple M4 است.

تراشه M4 عملکرد بسیار خوبی در مصرف انرژی و پردازش‌های روزمره دارد و برای کاربران اکوسیستم اپل گزینه‌ای مناسب محسوب می‌شود. با این حال، زمانی که صحبت از پردازش‌های سنگین هوش مصنوعی، یادگیری ماشین و مدل‌های بزرگ زبانی می‌شود، توان پردازشی گرافیکی RTX SPARK برتری محسوسی پیدا می‌کند.

علاوه بر این، اکوسیستم CUDA که سال‌هاست توسط توسعه‌دهندگان هوش مصنوعی استفاده می‌شود، یک مزیت مهم برای سوپر تراشه RTX SPARK به شمار می‌رود. بسیاری از کتابخانه‌ها و فریم‌ورک‌های هوش مصنوعی برای پردازنده‌های انویدیا بهینه شده‌اند.

البته اپل نیز در زمینه بهینه‌سازی نرم‌افزار و سخت‌افزار عملکرد فوق‌العاده‌ای دارد و انتخاب میان این دو محصول تا حد زیادی به نوع نیاز کاربران بستگی خواهد داشت.

مقایسه سوپر تراشه RTX SPARK با AMD Ryzen AI

شرکت AMD نیز در سال‌های اخیر سرمایه‌گذاری گسترده‌ای روی پردازنده‌های مجهز به هوش مصنوعی انجام داده است. سری Ryzen AI از جمله محصولات مهم این شرکت محسوب می‌شود.

در مقایسه با Ryzen AI، سوپر تراشه RTX SPARK تمرکز بیشتری بر پردازش‌های سنگین هوش مصنوعی و مدل‌های بزرگ دارد. همچنین قدرت پردازش گرافیکی آن در بسیاری از سناریوهای حرفه‌ای بالاتر ارزیابی می‌شود.

معرفی سوپر تراشه  RTX SPARK

از سوی دیگر، AMD در برخی محصولات خود نسبت قیمت به عملکرد مناسبی ارائه می‌دهد که می‌تواند برای کاربران عمومی جذاب باشد. اما در پروژه‌های حرفه‌ای و تخصصی، به ویژه در حوزه هوش مصنوعی، انویدیا همچنان جایگاه قدرتمندی دارد.

مزایا و معایب سوپر تراشه RTX SPARK

هر فناوری جدیدی در کنار مزایا، محدودیت‌هایی نیز دارد و سوپر تراشه RTX SPARK نیز از این قاعده مستثنا نیست.

مزایا

  • قدرت پردازشی بسیار بالا
  • عملکرد عالی در هوش مصنوعی
  • پشتیبانی از CUDA
  • حافظه یکپارچه پرسرعت
  • مصرف انرژی بهینه
  • مناسب برای تولید محتوا و رندرینگ
  • قابلیت اجرای مدل‌های بزرگ AI بر روی سیستم های هوش مصنوعی

معایب

  • احتمال قیمت بالا در زمان عرضه
  • نیاز برخی نرم‌افزارها به بهینه‌سازی بیشتر
  • جدید بودن پلتفرم و محدود بودن تجربه کاربران در ابتدای عرضه

با این حال مزایای این محصول به اندازه‌ای قابل توجه هستند که بسیاری از متخصصان آینده روشنی برای آن پیش‌بینی می‌کنند.

آینده RTX SPARK

با توجه به روند رشد هوش مصنوعی، نیاز به سخت‌افزارهای قدرتمند روزبه‌روز بیشتر می‌شود. بسیاری از تحلیلگران معتقدند سوپر تراشه جدید انویدیا می‌تواند یکی از مهم‌ترین محصولات تأثیرگذار بر بازار کامپیوترهای شخصی در سال‌های آینده باشد.

تمرکز انویدیا بر هوش مصنوعی محلی، پردازش سریع‌تر داده‌ها و کاهش وابستگی به زیرساخت‌های ابری می‌تواند مسیر جدیدی را برای صنعت فناوری ایجاد کند. در صورتی که تولیدکنندگان لپ‌تاپ و کامپیوتر از این پلتفرم استقبال کنند، احتمالاً شاهد گسترش سریع آن در بازار خواهیم بود.

سخن آخر

سوپر تراشه RTX SPARK را می‌توان یکی از مهم‌ترین نوآوری‌های انویدیا در سال‌های اخیر دانست. این محصول با بهره‌گیری از معماری Blackwell، پردازنده Grace، حافظه یکپارچه و قابلیت‌های پیشرفته هوش مصنوعی، بستری قدرتمند برای کاربران حرفه‌ای فراهم کرده است. توان پردازشی بالا، پشتیبانی از اکوسیستم CUDA و امکان اجرای مدل‌های بزرگ هوش مصنوعی از مهم‌ترین ویژگی‌های این تراشه هستند. اگر انویدیا بتواند وعده‌های خود را در محصولات نهایی به‌طور کامل محقق کند، این تراشه می‌تواند آینده رایانش شخصی و هوش مصنوعی را متحول کند و به یکی از تأثیرگذارترین فناوری‌های دهه آینده تبدیل شود.

سیستم هوش مصنوعی اقتصادی

سیستم هوش مصنوعی اقتصادی

سیستم هوش مصنوعی اقتصادی بهترین گزینه برای افرادی است که می‌خواهند بدون پرداخت هزینه‌های سنگین، انواع مدل‌های هوش مصنوعی را اجرا کنند. با گسترش ابزارهای هوش مصنوعی مانند مدل‌های زبانی، تولید تصویر، پردازش داده و تحلیل اطلاعات، بسیاری از کاربران به دنبال سیستمی هستند که بتواند عملکرد مناسبی ارائه دهد و در عین حال هزینه خرید آن منطقی باشد.

برخلاف تصور بسیاری از افراد، اجرای همه مدل‌های هوش مصنوعی به سخت‌افزارهای بسیار گران‌قیمت نیاز ندارد. امروزه مدل‌های متنوعی وجود دارند که روی سیستم‌های میان‌رده نیز اجرا می‌شوند. به همین دلیل انتخاب یک سیستم هوش مصنوعی اقتصادی می‌تواند نیاز طیف گسترده‌ای از کاربران شامل دانشجویان، تولیدکنندگان محتوا، برنامه‌نویسان، پژوهشگران و صاحبان کسب‌وکارهای کوچک را برطرف کند.

در این مقاله حداقل کانفیگ مورد نیاز برای یک سیستم هوش مصنوعی اقتصادی را بررسی می‌کنیم و مدل‌های مختلفی را که روی این سیستم قابل اجرا هستند معرفی خواهیم کرد.

چرا به سیستم هوش مصنوعی اقتصادی نیاز داریم؟

در سال‌های اخیر هوش مصنوعی از یک فناوری تخصصی به ابزاری کاربردی برای عموم کاربران تبدیل شده است. بسیاری از افراد قصد دارند مدل‌های هوش مصنوعی را به‌صورت محلی (Local) اجرا کنند تا به اینترنت وابسته نباشند یا هزینه اشتراک سرویس‌های آنلاین را کاهش دهند.

سیستم هوش مصنوعی اقتصادی

در چنین شرایطی خرید یک سیستم هوش مصنوعی ارزان قیمت اهمیت زیادی پیدا می‌کند. هدف از این سیستم دستیابی به بهترین تعادل میان قیمت و کارایی است. بسیاری از کاربران نیازی به کارت‌های گرافیک حرفه‌ای چند هزار دلاری ندارند و تنها می‌خواهند مدل‌های هوش مصنوعی را برای تولید محتوا، کدنویسی، تحلیل داده یا آموزش اجرا کنند.

یک سیستم اقتصادی باید چند ویژگی مهم داشته باشد:

  • قابلیت اجرای مدل‌های زبانی سبک و متوسط
  • امکان ارتقای رم و فضای ذخیره‌سازی
  • مصرف برق مناسب
  • هزینه خرید منطقی
  • پشتیبانی از پردازش‌های مبتنی بر GPU

خوشبختانه سخت‌افزارهای امروزی امکان اجرای بسیاری از مدل‌های محبوب هوش مصنوعی را بدون نیاز به تجهیزات بسیار گران فراهم کرده‌اند. به همین دلیل کاربران می‌توانند با بودجه متوسط نیز وارد دنیای هوش مصنوعی شوند.

حداقل کانفیگ پیشنهادی برای سیستم هوش مصنوعی ارزان قیمت

برای داشتن یک سیستم هوش مصنوعی اقتصادی که بتواند اکثر مدل‌های سبک و میان‌رده را اجرا کند، کانفیگ زیر پیشنهاد می‌شود:

سیستم هوش مصنوعی اقتصادی

پردازنده (CPU)

این پردازنده‌ها توان پردازشی مناسبی برای مدیریت مدل‌های هوش مصنوعی و پردازش داده دارند.

حافظه رم (RAM)

  • حداقل 32 گیگابایت DDR4 یا DDR5

اگرچه برخی مدل‌ها با 16 گیگابایت رم اجرا می‌شوند، اما برای عملکرد روان‌تر 32 گیگابایت انتخاب بسیار بهتری است.

کارت گرافیک (GPU)

کارت گرافیک مهم‌ترین بخش یک سیستم هوش مصنوعی محسوب می‌شود. حافظه گرافیکی بیشتر باعث اجرای بهتر مدل‌های بزرگ‌تر خواهد شد.

فضای ذخیره‌سازی

  • SSD NVMe با ظرفیت حداقل 1 ترابایت

مدل‌های هوش مصنوعی معمولاً حجم زیادی دارند و استفاده از SSD سرعت بارگذاری آن‌ها را افزایش می‌دهد.

منبع تغذیه

  • پاور 650 وات استاندارد 80 Plus

این ترکیب سخت‌افزاری برای بسیاری از پروژه‌های هوش مصنوعی عملکرد مطلوبی ارائه می‌دهد و همچنان در دسته سیستم‌های اقتصادی قرار می‌گیرد.

مدل‌های قابل اجرا روی سیستم هوش مصنوعی ارزان

یکی از مهم‌ترین مزایای یک سیستم هوش مصنوعی اقتصادی امکان اجرای مدل‌های متنوع است. بسیاری از مدل‌های متن‌باز امروزی برای اجرا روی سخت‌افزارهای میان‌رده بهینه شده‌اند.

مدل‌های زبانی (LLM)

مدل‌های زیر روی سیستم پیشنهادی قابل اجرا هستند:

این مدل‌ها برای تولید محتوا، پاسخ‌گویی به سوالات، ترجمه متن و کمک به برنامه‌نویسی کاربرد دارند.

مدل‌های تولید تصویر

کاربران می‌توانند مدل‌های زیر را نیز اجرا کنند:

این مدل‌ها برای تولید تصاویر تبلیغاتی، طراحی گرافیکی و تولید محتوای بصری مناسب هستند.

مدل‌های برنامه‌نویسی

برای توسعه‌دهندگان نیز گزینه‌های مناسبی وجود دارد:

  • Code Llama
  • DeepSeek Coder
  • Qwen Coder
  • StarCoder

این مدل‌ها می‌توانند در تولید کد، رفع خطا و تکمیل پروژه‌های نرم‌افزاری کمک کنند.

مزایای استفاده از سیستم هوش مصنوعی ارزان قیمت

استفاده از سیستم هوش مصنوعی اقتصادی مزایای متعددی دارد که آن را به انتخابی مناسب برای بسیاری از کاربران تبدیل می‌کند.

نخستین مزیت، کاهش هزینه‌ها است. کاربران به‌جای خرید ورک‌استیشن‌های حرفه‌ای می‌توانند با هزینه بسیار کمتر به امکانات موردنیاز خود دست پیدا کنند.

سیستم هوش مصنوعی اقتصادی

مزیت دوم استقلال از سرویس‌های ابری است. زمانی که مدل‌ها به‌صورت محلی اجرا می‌شوند، اطلاعات کاربران روی سیستم شخصی باقی می‌ماند و نگرانی‌های مربوط به حریم خصوصی کاهش پیدا می‌کند.

سرعت پاسخ‌دهی نیز یکی دیگر از مزایا محسوب می‌شود. در بسیاری از موارد اجرای محلی مدل‌ها سریع‌تر از سرویس‌های آنلاین عمل می‌کند، زیرا وابستگی به اینترنت وجود ندارد.

قابلیت ارتقا نیز اهمیت زیادی دارد. کاربر می‌تواند در آینده با افزایش رم یا تعویض کارت گرافیک، قدرت سیستم خود را افزایش دهد و مدل‌های بزرگ‌تری را اجرا کند.

علاوه بر این، اجرای محلی مدل‌ها برای آموزش و یادگیری هوش مصنوعی بسیار مفید است و امکان آزمایش مستقیم روی مدل‌های مختلف را فراهم می‌کند.

هنگام خرید سیستم هوش مصنوعی اقتصادی به چه نکاتی توجه کنیم؟

برای انتخاب یک سیستم هوش مصنوعی اقتصادی باید چند نکته مهم را در نظر گرفت. مهم‌ترین نکته میزان حافظه گرافیکی کارت گرافیک است. در بسیاری از پروژه‌های هوش مصنوعی، مقدار VRAM اهمیت بیشتری نسبت به قدرت خام پردازنده دارد.

موضوع بعدی ظرفیت رم سیستم است. امروزه 32 گیگابایت رم به‌عنوان نقطه شروع مناسب برای کار با مدل‌های هوش مصنوعی شناخته می‌شود.

سرعت ذخیره‌سازی نیز اهمیت دارد. استفاده از SSD NVMe باعث کاهش زمان بارگذاری مدل‌ها و افزایش سرعت کلی سیستم می‌شود.

سیستم هوش مصنوعی اقتصادی

همچنین باید به قابلیت ارتقای سیستم توجه کرد. انتخاب مادربرد مناسب می‌تواند در آینده هزینه ارتقای سخت‌افزار را کاهش دهد.

در نهایت بهتر است سیستم بر اساس نیاز واقعی خریداری شود. اگر هدف اجرای مدل‌های 7B یا 8B است، نیازی به خرید سخت‌افزارهای بسیار گران‌قیمت وجود ندارد و یک سیستم اقتصادی پاسخگوی نیاز کاربر خواهد بود.

سخن آخر

سیستم هوش مصنوعی اقتصادی راهکاری مناسب برای ورود به دنیای هوش مصنوعی بدون صرف هزینه‌های سنگین است. یک سیستم مجهز به پردازنده Core i5 یا Ryzen 5، رم 32 گیگابایتی، SSD پرسرعت و کارت گرافیک RTX 4060 یا RTX 3060 می‌تواند بسیاری از مدل‌های محبوب هوش مصنوعی را اجرا کند. مدل‌هایی مانند Llama، Mistral، Gemma، Qwen، DeepSeek و Stable Diffusion روی چنین سیستمی عملکرد قابل قبولی دارند. اگر به دنبال راه‌اندازی یک محیط شخصی برای تولید محتوا، برنامه‌نویسی، تحلیل داده یا یادگیری هوش مصنوعی هستید، انتخاب یک سیستم هوش مصنوعی اقتصادی می‌تواند بهترین تعادل میان هزینه و کارایی را در اختیار شما قرار دهد.

LLM

سیستم‌های مناسب برای LLM

در سال‌های اخیر، مدل‌های زبانی بزرگ که به اختصار LLM نامیده می‌شوند، به عنوان یکی از پیشرفت‌های بنیادین در حوزه هوش مصنوعی مطرح شده‌اند. این مدل‌ها توانایی تولید متن، پاسخ به پرسش‌ها، خلاصه‌سازی محتوا و حتی انجام استدلال‌های پیچیده را دارند.

با این حال، توسعه و اجرای این LLMها بدون وجود سیستم‌های فنی مناسب تقریبا غیرممکن است. مدل‌های زبانی بزرگ به دلیل حجم عظیم داده‌های آموزشی، تعداد بسیار زیاد پارامترها و نیاز به توان محاسباتی بالا، به زیرساخت‌های ویژه‌ای نیاز دارند.

سیستم‌های محاسباتی سخت‌افزاری برای LLM

اصلی‌ترین نیاز مدل‌های زبانی بزرگ، توان پردازشی بسیار بالا است. پردازنده‌های مرکزی معمولی برای آموزش یا حتی اجرای یک LLM با صدها میلیارد پارامتر کافی نیستند. به همین دلیل، استفاده از واحدهای پردازش گرافیکی پیشرفته به یک استاندارد تبدیل شده است. شرکت انویدیا با تولید محصولاتی مانند سری A100 و H100، توانسته است نیاز صنعت LLM را تا حد زیادی تأمین کند. این پردازنده‌های گرافیکی دارای هزاران هسته محاسباتی هستند که می‌توانند عملیات ضرب ماتریسی را که بخش عمده محاسبات شبکه‌های عصبی در یک LLM است، با سرعت بسیار بالا انجام دهند. در مقاله مقایسه کارت گرافیک A100 , H100 , RTX 6000 PRO Blackwell  به بررسی این پردازنده های گرافیکی پرداختیم.

علاوه بر پردازنده‌های گرافیکی، حافظه با پهنای باند بالا نیز یکی دیگر از اجزای حیاتی برای اجرای LLM محسوب می‌شود. مدل‌های زبانی بزرگ باید به صورت کامل یا بخشی از آن در حافظه جانبی پردازنده‌ها قرار گیرد تا عملیات استنتاج یا آموزش به صورت پیوسته انجام شود. برای مثال، یک LLM با ۱۷۵ میلیارد پارامتر به چندین ترابایت حافظه نیاز دارد. بنابراین، استفاده از حافظه‌های اچ‌بی‌ام یا حافظه‌های با پهنای باند بسیار بالا و همچنین چیدمان بهینه حافظه در میان چندین پردازنده گرافیکی برای بهینه‌سازی کارایی LLM ضروری است.

در سطح بالاتر، سیستم‌های توزیع شده که متشکل از صدها یا هزاران پردازنده گرافیکی هستند، برای آموزش LLMهایی مانند جی‌پی‌تی-۴ یا لاما استفاده می‌شوند. این خوشه‌های محاسباتی باید از طریق شبکه‌های پرسرعت مانند اینفینی‌باند به یکدیگر متصل شوند تا تأخیر در انتقال داده‌ها برای همگام‌سازی اجزای مختلف مدل زبانی بزرگ به حداقل برسد. بدون چنین اتصالات پرسرعتی، همگام‌سازی میان پردازنده‌ها به یک گلوگاه بزرگ تبدیل خواهد شد و کارایی سیستم LLM به شدت کاهش می‌یابد.

سیستم‌های ذخیره‌سازی و مدیریت داده برای LLM

دومین جزء مهم در معماری یک LLM، سیستم ذخیره‌سازی داده است. مدل‌های زبانی بزرگ بر روی حجم عظیمی از داده‌های متنی آموزش داده می‌شوند. این داده‌ها معمولا شامل کتاب‌ها، مقالات وب، کدهای برنامه‌نویسی و محتوای علمی هستند که جمعا به چندین ده ترابایت می‌رسند. دسترسی سریع و قابل اعتماد به این داده‌ها در طول فرآیند آموزش یک LLM اهمیت بالایی دارد. سیستم‌های ذخیره‌سازی توزیع شده مانند اچ‌دی‌اف‌اس یا سیستم‌های مدرن مبتنی بر آبجکت استوریج، امکان خواندن همزمان داده توسط صدها پردازنده را برای تغذیه مدل زبانی بزرگ فراهم می‌کنند.

علاوه بر ذخیره‌سازی خام داده، نیاز به سیستم‌های مدیریت داده برای پیش‌پردازش و پاکسازی متن‌های مورد استفاده در LLM وجود دارد. داده‌های متنی خام معمولا دارای نویز، کاراکترهای تکراری، اطلاعات تکراری یا محتوای نامرتبط هستند. سیستم‌های مناسب برای آموزش یک LLM باید شامل ابزارهایی برای توکن‌سازی، نرمال‌سازی، حذف داده‌های بی‌کیفیت و ایجاد بسته‌های داده با طول یکسان باشند. برای این منظور، پلتفرم‌هایی مانند اسپارک یا سیستم‌های پردازش داده موازی کاربرد فراوان دارند و به کارآمدی مدل‌های زبانی بزرگ کمک می‌کنند.

همچنین در مرحله اجرا و ارائه خدمات توسط یک LLM، ذخیره‌سازی کش برای پاسخ‌های مکرر یا محاسبات میانی اهمیت پیدا می‌کند. بسیاری از سوالات کاربران از یک مدل زبانی بزرگ تکراری هستند. اگر پاسخ هر سوال برای مدت معینی در حافظه کش ذخیره شود، می‌توان از محاسبات مجدد توسط LLM جلوگیری کرد و هزینه و زمان پاسخگویی را کاهش داد. بنابراین، سیستم‌های کش توزیع شده مانند ردیس معمولا در معماری خدماتی مدل‌های زبانی بزرگ گنجانده می‌شوند.

سیستم‌های نرم‌افزاری و فریم‌ورک‌های مخصوص LLM

برای استفاده کارآمد از سخت‌افزارهای قدرتمند در راستای اجرای یک LLM، به فریم‌ورک‌های نرم‌افزاری تخصصی نیاز است. در حال حاضر، فریم‌ورک‌هایی مانند پایتورچ و تنسورفلو دو ابزار اصلی برای توسعه و آموزش مدل‌های زبانی بزرگ هستند.

LLM

این فریم‌ ورک‌ها قابلیت‌هایی مانند محاسبات خودکار گرادیان، مدیریت حافظه، و پشتیبانی از موازی‌سازی را ارائه می‌دهند. بدون این ابزارها، پیاده‌سازی دستوری الگوریتم‌های بهینه‌سازی برای یک LLM تقریبا غیرممکن خواهد بود.

فراتر از فریم‌ورک‌های پایه، کتابخانه‌ها و ابزارهای خاصی برای مدل‌های زبانی بزرگ توسعه یافته‌اند. برای مثال، کتابخانه «دیکپ‌اسپید» از شرکت مایکروسافت، روش‌های موازی‌سازی پیشرفته‌ای مانند موازی‌سازی داده، موازی‌سازی لوله‌ای و موازی‌سازی تانسور را برای آموزش LLM ارائه می‌دهد. همچنین کتابخانه «ترنسفورمرز» از هاگینگ‌فیس، دسترسی به مدل‌های زبانی بزرگ از پیش آموزش دیده و ابزارهای ارزیابی را ساده کرده است. این کتابخانه‌ها شامل توابعی برای بارگذاری یک LLM، توکن‌سازی متن و تولید متن با تنظیمات مختلف هستند.

یک سیستم نرم‌افزاری مناسب برای مدل زبانی بزرگ باید شامل ماژول پایش و ثبت وقایع نیز باشد. آموزش یک LLM ممکن است هفته‌ها یا ماه‌ها طول بکشد. در این مدت، احتمال بروز خطاهای سخت‌افزاری یا نرم‌افزاری وجود دارد. سیستم‌های پایش پیشرفته می‌توانند دمای پردازنده‌ها، مصرف حافظه، نرخ استفاده از واحد محاسباتی و همچنین معیارهای آموزشی LLM مانند میزان خطا و دقت را در زمان واقعی نمایش دهند. در صورت بروز مشکل، این سیستم‌ها قادر به ذخیره وضعیت فعلی آموزش مدل زبانی بزرگ و بازیابی از نقاط بازبینی هستند.

سیستم‌های استنتاج و بهینه‌سازی برای کاربردی شدن LLM

پس از آموزش یک مدل زبانی بزرگ، مرحله مهم بعدی، استنتاج یا استفاده عملی از LLM است. در این مرحله، سیستم باید بتواند به درخواست‌های کاربران در زمان کوتاه پاسخ دهد. تفاوت اصلی میان مرحله آموزش و استنتاج در این است که در استنتاج، تأخیر بسیار حیاتی و توان عملیاتی بالا برای پاسخگویی LLM اهمیت دارد. برای این منظور، تکنیک‌های بهینه‌سازی مختلفی به کار می‌روند.

LLM

یکی از مهمترین روش‌های بهینه‌سازی برای استنتاج یک LLM، استفاده از کمینه‌سازی اعداد با دقت کمتر است. به جای ذخیره پارامترهای مدل زبانی بزرگ با دقت ممیز شناور ۳۲ بیتی، می‌توان آن‌ها را با دقت ۱۶ بیتی یا حتی ۸ و ۴ بیتی ذخیره کرد. این کار باعث کاهش چشمگیر حافظه مورد نیاز و افزایش سرعت محاسبات LLM می‌شود، هرچند که ممکن است دقت مدل را اندکی کاهش دهد. روش دیگر، تقطیر مدل زبانی بزرگ است که در آن یک مدل کوچک‌تر را آموزش می‌دهیم تا خروجی‌های LLM بزرگ را تقلید کند.

همچنین سیستم‌های استنتاج برای مدل‌های زبانی بزرگ معمولا از مکانیزم‌های کش برداری استفاده می‌کنند. در بسیاری از کاربردهای مبتنی بر LLM مانند سیستم‌های پرسش و پاسخ یا دستیارهای مجازی، درخواست‌های مشابه بارها تکرار می‌شوند. با ذخیره بردارهای نمایش متن در یک پایگاه داده برداری، می‌توان به جای اجرای کامل مدل زبانی بزرگ، پاسخ‌های مشابه را بازیابی کرد. این روش به خصوص برای LLMهای تولید افزایشیافته با بازیابی بسیار مؤثر است.

سیستم‌های امنیتی و حریم خصوصی برای LLM

بدون شک، پیاده‌سازی مدل‌های زبانی بزرگ در محیط‌های واقعی مستلزم رعایت اصول امنیتی و حریم خصوصی است. بسیاری از کاربردهای تجاری LLM شامل داده‌های حساس کاربران مانند اطلاعات پزشکی، مالی یا محرمانه سازمانی هستند. بنابراین، سیستم‌های مناسب برای مدل زبانی بزرگ باید قابلیت اجرای مدل به صورت محلی را داشته باشند. در این مدل استقرار محلی، داده‌های کاربران از سیستم LLM خارج نمی‌شوند و کنترل کامل در اختیار مالک داده است.

علاوه بر استقرار محلی LLM، استفاده از روش‌های رمزنگاری پیشرفته مانند محاسبات چندجانبه ایمن یا رمزنگاری همومورفیک در حال توسعه است. این روش‌ها امکان محاسبه بر روی داده‌های رمز شده توسط یک مدل زبانی بزرگ بدون نیاز به رمزگشایی را فراهم می‌کنند. البته در حال حاضر این روش‌ها بسیار کند هستند و برای LLMهای بزرگ به بلوغ کامل نرسیده‌اند. اما به عنوان یک سیستم مناسب برای حفاظت از مدل‌های زبانی بزرگ در آینده نقش مهمی ایفا خواهند کرد.

همچنین سیستم‌های ثبت و پایش درخواست‌ها از نظر امنیتی برای LLM ضروری هستند. ثبت اطلاعاتی مانند کاربر درخواست‌کننده، زمان درخواست، نوع پرسش و پاسخ تولید شده توسط مدل زبانی بزرگ، به تشخیص حملات مخرب یا نشت اطلاعات کمک می‌کند. یک سیستم مناسب برای LLM باید توانایی تشخیص الگوهای غیرعادی مانند درخواست‌های مکرر برای استخراج داده‌های آموزش یا تلاش برای شکستن محدودیت‌های محتوایی مدل زبانی بزرگ را داشته باشد.

نتیجه‌گیری

LLMها به ترکیبی هماهنگ از سخت‌افزارهای قدرتمند مانند پردازنده‌های گرافیکی پیشرفته، سیستم‌های ذخیره‌سازی توزیع شده با دسترسی سریع به داده، فریم‌ورک‌های نرم‌افزاری به ینه‌سازی شده، روش‌های استنتاج با تأخیر کم و همچنین سازوکارهای امنیتی مناسب نیاز دارند. هیچ کدام از این اجزا به تنهایی برای اجرای یک مدل زبانی بزرگ کافی نیستند و یک سیستم کارآمد باید تمامی این لایه‌ها را به صورت یکپارچه پوشش دهد.

با توجه به سرعت پیشرفت فناوری LLM، انتظار می‌رود سیستم‌های مناسب برای مدل‌های زبانی بزرگ نیز به سرعت تکامل یابند. کاهش هزینه‌های محاسباتی، افزایش کارایی انرژی، بهبود روش‌های فشرده‌سازی LLM و توسعه سخت‌افزارهای اختصاصی برای محاسبات عصبی مرتبط با مدل‌های زبانی بزرگ، از جمله روندهایی هستند که آینده این حوزه را شکل خواهند داد. درک صحیح این سیستم‌ها برای پژوهشگران، مهندسان و مدیرانی که قصد بهره‌گیری از توان LLMها را دارند، امری ضروری و اجتناب‌ناپذیر است.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell برای کاربردهای هوش مصنوعی

انتخاب پردازنده گرافیکی مناسب برای پروژه‌های هوش مصنوعی، به ویژه در حوزه مدل‌های زبانی بزرگ، تصمیمی سرنوشت‌ساز و پیچیده است. هر یک از سه کارت گرافیک مورد بررسی، اگرچه محصولی از انویدیا هستند، اما برای کاربردها و بودجه‌بندی متفاوتی طراحی شده‌اند.

انویدیا A100 به عنوان استاندارد طلایی سابق،H100 به عنوان راهکار غالب مراکز داده در سال‌های اخیر و RTX 6000 PRO Blackwell به عنوان تازه‌واردی با معماری به روز و حافظه بالا، گزینه‌های پیش روی مهندسان و پژوهشگران هستند.

مشخصات فنی و معماری

برای درک تفاوت عملکرد، ابتدا باید به تفاوت‌های بنیادین در معماری و مشخصات فنی این سه محصول نگاه کرد. هر یک از این کارت‌گرافیک‌ها بر پایه یک معماری خاص طراحی شده و ویژگی‌های منحصر به فردی را ارائه می‌دهد.

۱. کارت گرافیک A100 با معماری آمپر

معماری آمپر انقلابی در محاسبات هوش مصنوعی ایجاد کرد. این کارت‌گرافیک از نسل سوم هسته‌های تانسور بهره می‌برد و قابلیت‌هایی مانند تی‌اف۳۲ و اسپارسیتی را معرفی نمود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

رایج‌ترین نسخه کارت گرافیک A100، مدل ۸۰ گیگابایتی با حافظه نوع اچ‌بی‌ام۲ئی و پهنای باند ۲ ترابایت بر ثانیه است. فرم فاکتور این محصول از نوع اس‌اکس‌ام بوده و برای نصب در مراکز داده تخصصی طراحی شده است. این کارت همچنین از فناوری ام‌آی‌جی پشتیبانی می‌کند که به کاربران اجازه می‌دهد یک کارت گرافیک را به چندین بخش مجزا و ایمن تقسیم نمایند.

۲. کارت‌گرافیک‌ H100 با معماری هاپر

معماری هاپر پیشرفتی قابل توجه نسبت به نسل قبل است. کارت‌گرافیک‌ H100 از نسل چهارم هسته‌های تانسور و نوع داده اف‌پی۸ پشتیبانی می‌کند که عملاً توان محاسباتی را برای این نوع داده نسبت به ای۱۰۰ دوچندان می‌نماید.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مدل اس‌اکس‌ام این محصول دارای ۸۰ گیگابایت حافظه نوع اچ‌بی‌ام۳ با پهنای باند ۳.۳۵ ترابایت بر ثانیه است که از ای۱۰۰ سریع‌تر می‌باشد. فرم فاکتور این محصول نیز از نوع اس‌اکس‌ام بوده و به سیستم‌های خنک‌کننده پیشرفته نیاز دارد. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول به ۹۸۹ ترافلاپس می‌رسد که رقمی بسیار چشمگیر است.

۳. انویدیا RTX 6000 PRO Blackwell با معماری بلک‌ول

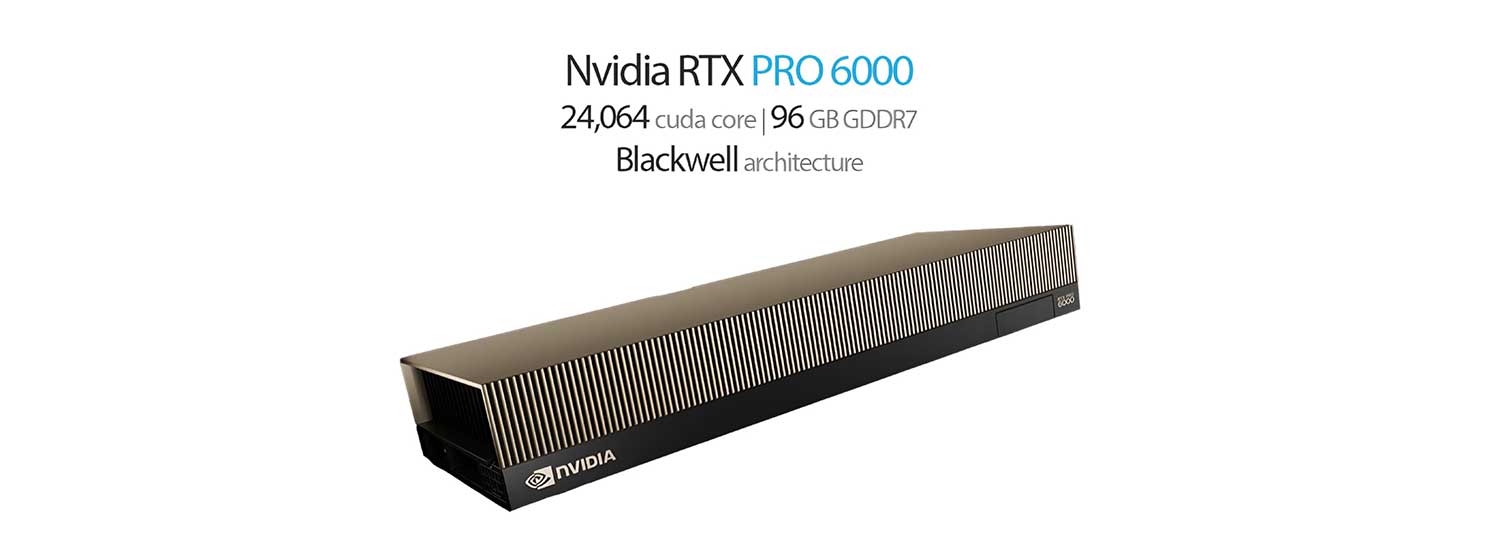
جدیدترین محصول این خانواده یعنی کارت گرافیک RTX 6000 PRO Blackwell بر پایه معماری بلک‌ول ساخته شده است. تفاوت کلیدی این محصول در نوع حافظه آن است. بر خلاف دو مدل قبلی که از حافظه اچ‌بی‌ام استفاده می‌کردند، آرتی‌ایکس ۶۰۰۰ پرو از ۹۶ گیگابایت حافظه نوع جی‌دی‌دی‌آر۷ با پهنای باند ۱.۷۹۲ ترابایت بر ثانیه بهره می‌برد.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

فرم فاکتور این محصول از نوع پی‌سی‌آی‌اکسپرس است که امکان نصب آن را در ایستگاه‌های کاری معمولی و سیستم های هوش مصنوعی معمولی را فراهم می‌کند. این محصول از نسل پنجم هسته‌های تانسور و نوع داده اف‌پی۴ پشتیبانی می‌کند که پیشرفته‌ترین فناوری روز برای شتاب‌دهی به استنتاج مدل‌های عظیم محسوب می‌شود. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول حدود ۱۲۶ ترافلاپس است که در مقایسه با اچ‌۱۰۰ پایین‌تر به نظر می‌رسد، اما این کاهش توان با بهره‌وری انرژی بالاتر و حافظه بیشتر جبران شده است.

 تحلیل مقایسه‌ای مشخصات کلیدی

از نظر معماری، کارت گرافیک A100 متعلق به نسل آمپر، کارت‌گرافیک‌ H100 متعلق به نسل هاپر و کارت گرافیک RTX 6000 PRO Blackwell متعلق به جدیدترین نسل یعنی بلک‌ول است. هر نسل جدید بهبودهای قابل توجهی در بهره‌وری انرژی و توان محاسباتی به همراه داشته است.

از نظر مقدار حافظه، کارت گرافیک A100 و کارت‌گرافیک‌ H100 هر دو ۸۰ گیگابایت حافظه در اختیار کاربر قرار می‌دهند، در حالی که کارت گرافیک RTX 6000 PRO Blackwell با ۹۶ گیگابایت حافظه، برتری محسوسی در این زمینه دارد. این ۱۶ گیگابایت اضافی می‌تواند تفاوت زیادی در اجرای مدل‌های بسیار بزرگ ایجاد کند.

از نظر نوع حافظه، کارت گرافیک A100 از نوع اچ‌بی‌ام۲ئی، کارت‌گرافیک‌ H100 از نوع اچ‌بی‌ام۳ و کارت گرافیک RTX 6000 PRO Blackwell از نوع جی‌دی‌دی‌آر۷ استفاده می‌کند. حافظه اچ‌بی‌ام پهنای باند بالاتری دارد اما گران‌تر است، در حالی که جی‌دی‌دی‌آر۷ اگرچه پهنای باند کمتری ارائه می‌دهد، اما مقرون به صرفه‌تر و در دسترس‌تر است.

از نظر پهنای باند حافظه، کارت گرافیک A100 با ۲ ترابایت بر ثانیه، اچ‌۱۰۰ با ۳.۳۵ ترابایت بر ثانیه و کارت گرافیک RTX 6000 PRO Blackwell با ۱.۷۹۲ ترابایت بر ثانیه عمل می‌کند. اچ‌۱۰۰ در این شاخص به وضوح برتر است و برای بارهای کاری حساس به پهنای باند مانند آموزش مدل‌های بزرگ، بهترین انتخاب محسوب می‌شود.

از نظر قیمت تقریبی، کارت‌گرافیک‌ H100 گران‌ترین گزینه است و قیمت آن در بازار آزاد به چند ده هزار دلار می‌رسد. کارت گرافیک A100 قیمت متوسطی دارد و در بازار دست دوم با قیمت‌های معقول‌تری یافت می‌شود. کارت گرافیک RTX 6000 PRO Blackwell از نظر قیمت خرید، گزینه‌ای بین این دو محسوب می‌شود و نسبت به کارت‌گرافیک‌ H100 مقرون به صرفه‌تر است.

تحلیل عملکرد برای هوش مصنوعی

عملکرد این کارت‌ها بسته به نوع بار کاری، یعنی آموزش یا استنتاج و همچنین اندازه مدل، تفاوت چشمگیری دارد.

۱. عملکرد در مرحله آموزش مدل

در حوزه آموزش مدل‌های بزرگ، همواره پهنای باند حافظه و توان محاسباتی خام حرف اول را می‌زند. کارت‌گرافیک‌ H100 در این بخش برتری مطلق دارد. پهنای باند بالای اچ‌بی‌ام۳ و توان محاسباتی عظیم اف‌پی۸ آن باعث می‌شود آموزش مدل‌هایی مانند جی‌پی‌تی-۳ تا ۴ برابر سریع‌تر از ای۱۰۰ انجام شود. برای یک تیم تحقیقاتی که قصد آموزش یک مدل بزرگ از ابتدا را دارد، کارت‌گرافیک‌ H100 می‌تواند هفته‌ها زمان را صرفه‌جویی کند.

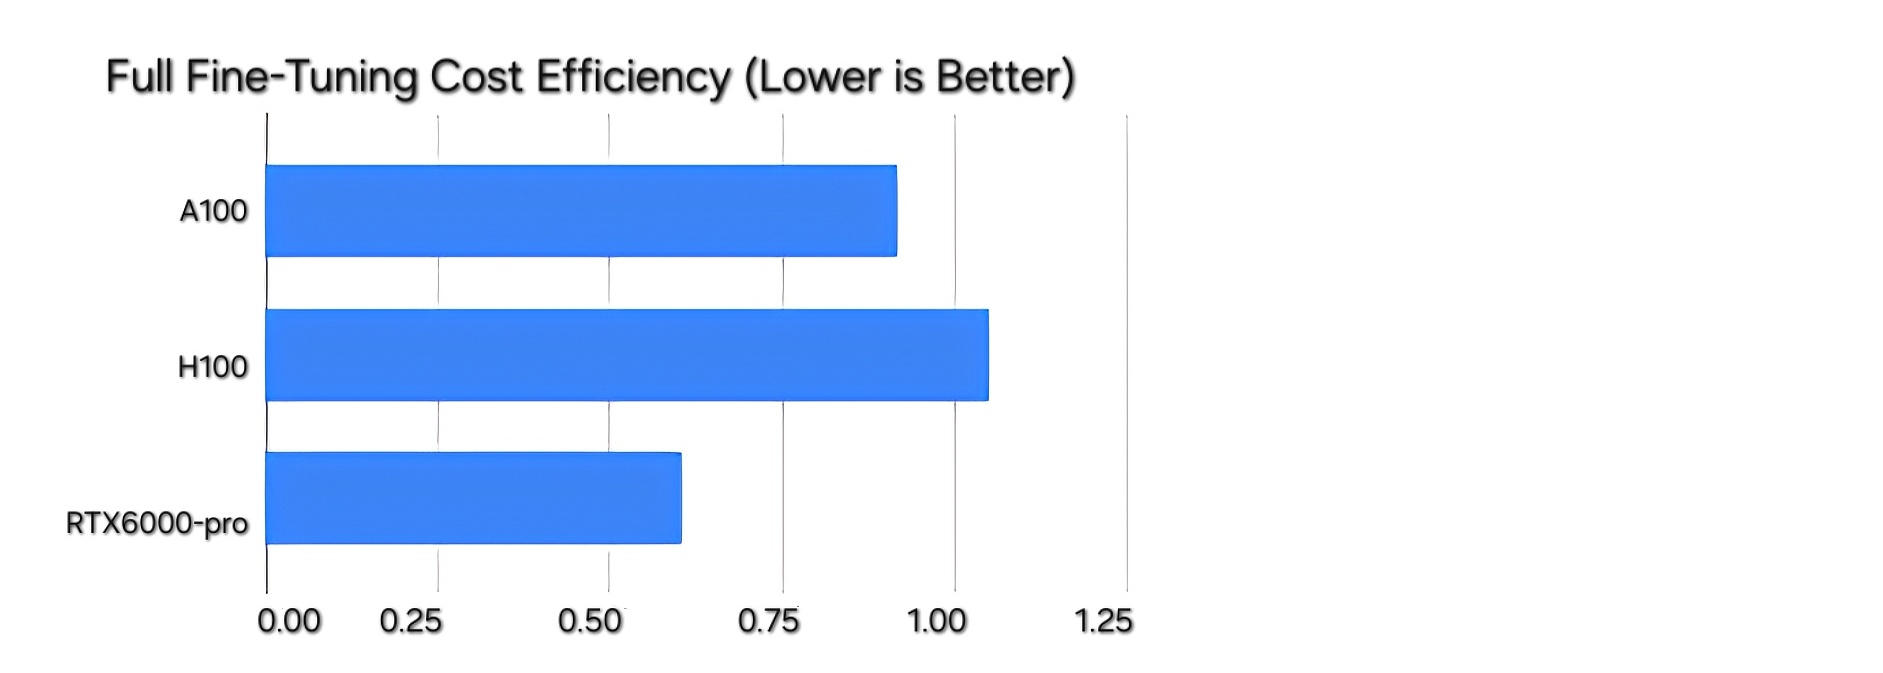
ای۱۰۰ اگرچه سرعتی معادل یک‌چهارم اچ‌۱۰۰ در برخی بارها دارد، اما به دلیل بلوغ نرم‌افزاری و هزینه کمتر، گزینه‌ای مقرون به صرفه برای تیم‌های متوسط محسوب می‌شود. طبق بنچمارک‌های معتبر، هزینه اجرای یک دوره آموزشی روی ای۱۰۰ تقریباً نصف اچ‌۱۰۰ تمام می‌شود، چراکه اچ‌۱۰۰ برای مدل‌های کوچک به طور کامل اشباع نمی‌گردد.

اما جایگاه کارت گرافیک RTX 6000 PRO Blackwell در این بخش چیست؟ این کارت با داشتن حافظه جی‌دی‌دی‌آر۷، پهنای باند کمتری نسبت به اچ‌۱۰۰ دارد. همچنین توان محاسباتی اف‌پی۱۶ آن در مقایسه با اچ‌۱۰۰ بسیار پایین‌تر است. با این حال، یک مزیت بزرگ دارد و آن ۹۶ گیگابایت حافظه است. معماری بلک‌ول در این کارت به گونه‌ای طراحی شده که برای استنتاج بهینه است، نه آموزش حجیم. برای آموزش مدل‌های بسیار بزرگ، اچ‌۱۰۰ همچنان پادشاه بلامنازع باقی می‌ماند.

۲.عملکرد در مرحله استنتاج

بخش جذاب ماجرا به استنتاج مربوط می‌شود، جایی که آرتی‌ایکس ۶۰۰۰ پرو می‌تواند بدرخشد. بزرگترین چالش در استنتاج مدل‌های زبانی بزرگ، ظرفیت حافظه است. برای اجرای یک مدل ۷۰ میلیارد پارامتری در دقت اف‌پی۸، تقریباً به ۷۰ گیگابایت حافظه نیاز خواهد بود.

انویدیا ای۱۰۰ و اچ‌۱۰۰ هر دو ۸۰ گیگابایت حافظه دارند. این مقدار برای اجرای نسخه اف‌پی۸ مدل ۷۰ میلیاردی کافی است، اما فضای بسیار کمی برای حافظه میانی باقی می‌گذارد. این موضوع سرعت را در توالی‌های طولانی کاهش می‌دهد و امکان استفاده از سایز بچ بزرگ را محدود می‌کند.

در سوی دیگر، انویدیا آرتی‌ایکس ۶۰۰۰ پرو با ۹۶ گیگابایت حافظه، فضای تنفس بیشتری دارد. این یعنی می‌تواند همین مدل ۷۰ میلیاردی را با سایز بچ بزرگ‌تر و سرعت بالاتر، بدون نیاز به دو کارت گرافیک و ارتباطات پرسرعت بین آنها اجرا کند. این ویژگی برای استقرار مدل در محیط تولیدی یک مزیت رقابتی بزرگ محسوب می‌شود.

بنچمارک‌های مستقل نشان می‌دهند که این کارت در دقت اف‌پی۸ عملکرد بسیار خوبی دارد و در برخی تست‌ها به ۸,۴۰۰ توکن در ثانیه روی مدل ۳۰ میلیاردی دست یافته است. این رقم تقریباً برابر با عملکرد چهار کارت آرتی‌ایکس ۴۰۹۰ است. اگرچه اچ‌۱۰۰ در حالت تئوری توان محاسباتی اف‌پی۸ بالاتری دارد، اما آرتی‌ایکس ۶۰۰۰ پرو با ارائه حافظه بیشتر، امکان اجرای روان‌تر مدل‌های حجیم را با هزینه سخت‌افزاری کمتر فراهم می‌کند.

علاوه بر این، پشتیبانی از نوع داده اف‌پی۴ در معماری بلک‌ول، یک برگ برنده بزرگ است. استفاده از اف‌پی۴ به طور تئوری توان خروجی را نسبت به اف‌پی۸ دو برابر می‌کند. این قابلیت، آرتی‌ایکس ۶۰۰۰ پرو را به گزینه‌ای ایده‌آل برای اجرای مدل‌های بسیار بزرگ در آینده تبدیل می‌کند، کاری که از اچ‌۱۰۰ یا ای۱۰۰ برنمی‌آید.

 تحلیل هزینه و صرفه اقتصادی

در نگاه اول، قیمت خرید اچ‌۱۰۰ بسیار بالا است و بسیاری از تیم‌ها توانایی تهیه آن را ندارند. اما در محاسبات ابری یا کرایه‌ای، قضیه متفاوت است. نرخ کرایه ساعتی اچ‌۱۰۰ بالاست و حدود ۲ دلار به ازای هر ساعت برای مدل پی‌سی‌آی‌اکسپرس برآورد می‌شود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

در مقابل، آرتی‌ایکس ۶۰۰۰ پرو به دلیل ماهیت ورکاستیشن بودن و عدم نیاز به زیرساخت خنک‌کننده گران‌قیمت مرکز داده، کرایه ساعتی بسیار کمتری دارد. این نرخ به حدود ۰.۷ دلار به ازای هر ساعت می‌رسد. برای اجرای یک ای‌پی‌آی استنتاج، استفاده از آرتی‌ایکس ۶۰۰۰ پرو می‌تواند هزینه به ازای هر یک میلیون توکن را تا یک‌سوم اچ‌۱۰۰ کاهش دهد.

برای مدل‌های ۳۰ میلیاردی، هزینه استنتاج با آرتی‌ایکس ۶۰۰۰ پرو حدود ۰.۰۲ دلار به ازای هر یک میلیون توکن تخمین زده می‌شود. این رقم بسیار رقابتی است و به کسب‌وکارهای کوچک و متوسط اجازه می‌دهد بدون صرف هزینه‌های سرسام‌آور، مدل‌های هوش مصنوعی خود را به صورت زنده ارائه دهند.

نتیجه‌گیری

کدام یک برای هوش مصنوعی بهتر است؟

پاسخ به این سؤال کاملاً به نیاز خاص شما بستگی دارد و هیچ پاسخ یکسانی برای همه وجود ندارد.

اگر شما در حال آموزش یک مدل زبانی بزرگ از صفر هستید یا به حداکثر توان محاسباتی برای کاهش زمان آموزش نیاز دارید، انویدیا اچ‌۱۰۰ بدون شک بهترین انتخاب است. هیچ کارت دیگری در این رده قیمتی توان عملیاتی اف‌پی۸ و پهنای باند معادل اچ‌۱۰۰ را برای محیط‌های صنعتی و تحقیقاتی بزرگ ارائه نمی‌دهد. این کارت برای شرکت‌های بزرگ و مراکز تحقیقاتی پیشرفته طراحی شده است.

اگر هدف شما اجرا و استقرار مدل در محیط تولیدی به صورت مقرون به صرفه است، انویدیا آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول انتخاب هوشمندانه‌تری محسوب می‌شود. حافظه ۹۶ گیگابایتی آن بستری ایده‌آل برای اجرای مدل‌های تا ۷۰ میلیارد پارامتر با دقت مناسب فراهم می‌کند. هزینه عملیاتی پایین‌تر و پشتیبانی از فناوری جدید اف‌پی۴، آن را به سرمایه‌ای مناسب برای چند سال آینده تبدیل می‌کند. این کارت گزینه‌ای عالی برای استارتاپ‌ها و تیم‌هایی است که می‌خواهند مدل خود را با بودجه معقول به صورت زنده اجرا کنند.

اگر بودجه محدودی دارید و به دنبال یک گزینه متعادل برای آموزش و استنتاج مدل‌های نسبتاً بزرگ هستید، انویدیا ای۱۰۰ هنوز هم انتخاب قابل قبولی است. این کارت دیگر گزینه‌ای برای پیشرفته‌ترین پروژه‌ها نیست، اما با توجه به قیمت دست دوم مناسب و پایداری بالای نرم‌افزار، همچنان در بسیاری از مراکز داده به عنوان یک اسب کار قابل اعتماد فعالیت می‌کند.

در یک جمله خلاصه:

برای آموزش، اچ‌۱۰۰ برنده بی‌رقابت است. برای استنتاج با حجم بالا و بودجه بهینه، آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول گزینه‌ای بهتر و آینده‌نگرانه‌تر به شمار می‌رود. انتخاب نهایی به بودجه، نوع پروژه و اولویت‌های شما بستگی دارد.

سرورهای DGX انویدیا

معرفی سرورهای DGX انویدیا

در عصر کنونی، هوش مصنوعی به عنوان نیروی محرکه تحول دیجیتال در صنایع مختلف ظهور یافته است. با این حال، پیاده‌سازی و مقیاس‌پذیری زیرساخت‌های هوش مصنوعی همواره با چالش‌های قابل توجهی از جمله پیچیدگی یکپارچه‌سازی سخت‌افزار و نرم‌افزار، هزینه‌های سنگین مهندسی، و زمان‌بر بودن فرآیند راه‌اندازی همراه بوده است. سرورهای DGX شرکت انویدیا به عنوان راهکاری جامع و یکپارچه برای رفع این موانع طراحی شده‌اند.

پیشرفت‌های سریع در حوزه هوش مصنوعی، به ویژه در زمینه یادگیری عمیق و مدل‌های زبانی بزرگ، تقاضا برای توان محاسباتی بی‌سابقه‌ای را ایجاد کرده است. سازمان‌ها و پژوهشگران برای آموزش مدل‌هایی با میلیاردها پارامتر به زیرساختی نیاز دارند که فراتر از توان سرورهای سنتی باشد.

با این حال، مسیر دستیابی به چنین زیرساختی اغلب با دشواری‌هایی نظیر ناسازگاری اجزای سخت‌افزاری، پیچیدگی پیکربندی نرم‌افزارهای متن‌باز، و هزینه‌های بالای نگهداری همراه است. در این راستا، شرکت انویدیا خانواده سرورهای DGX را به عنوان «مولفه هوش مصنوعی» یا «ماشین هوش مصنوعی» یکپارچه معرفی کرده است.

هدف این دستگاه‌ها، ارائه یک راه حل کلید در دست است که پیچیدگی‌های ساخت و راه‌اندازی زیرساخت سیستم های هوش مصنوعی را از دوش کاربران بردارد .

مفهوم و جایگاه سرورهای DGX

سرورهای DGX که مخفف عبارت «مولفه هوش مصنوعی» هستند، دستگاه‌هایی از پیش پیکربندی شده و بهینه‌سازی شده‌اند که به طور اختصاصی برای اجرای بارهای کاری سنگین هوش مصنوعی و یادگیری ماشین طراحی شده‌اند.

سرورهای DGX انویدیا

برخلاف سرورهای معمولی و سیستم های رندرینگ اسمبل شده که ممکن است ترکیبی از قطعات مختلف تولیدکنندگان گوناگون باشند، سرور DGX به عنوان یک دستگاه یکپارچه یا «مولفه» عرضه می‌شود.

این بدان معناست که شرکت انویدیا تمام اجزا از جمله پردازنده‌های گرافیکی، پردازنده‌های مرکزی، حافظه، ذخیره‌سازی، اتصالات شبکه و مهمتر از همه، پشته نرم‌افزاری را از پیش انتخاب و بهینه‌سازی کرده است . نخستین نسخه از این سرورها با نام DGX-1 در سال ۲۰۱۶ معرفی شد و از آن زمان تاکنون، این خانواده همواره در خط مقدم تحول سخت‌افزاری هوش مصنوعی قرار داشته است .

معماری فنی و اجزای کلیدی سرورهای DGX انویدیا

قلب تپنده سرورهای نسل جدید DGX، از جمله مدل H100 و H200، توسط هشت پردازنده گرافیکی H100 یا H200 شرکت انویدیا تشکیل شده است. مدل H100 دارای ۶۴۰ گیگابایت حافظه مجتمع است، در حالی که مدل H200 این مقدار را به ۱۱۲۸ گیگابایت افزایش می‌دهد .

افزون بر این، دو پردازنده مرکزی Intel Xeon، مجموعاً ۲ ترابایت حافظه سیستم و ۳۰ ترابایت حافظه ذخیره‌سازی NVMe SSD در این سرورها تعبیه شده است .

سرورهای DGX انویدیا

با این حال، آنچه سرورهای DGX را از مجموعه‌ای از قطعات مجزا متمایز می‌کند، فناوری ارتباطی اختصاصی به کار رفته در آن است. هر یک از هشت پردازنده گرافیکی از طریق چهار سوئیچ NVSwitch نسل چهارم و فناوری NVLink به یکدیگر متصل می‌شوند .

این معماری، پهنای باند دوسویه بسیار بالایی به میزان ۹۰۰ گیگابایت بر ثانیه بین هر جفت پردازنده گرافیکی فراهم می‌آورد. چنین سرعت ارتباطی برای آموزش مدل‌های بزرگ که نیازمند تبادل مداوم داده میان پردازنده‌ها هستند، نقشی حیاتی دارد. در غیر این صورت، بخش قابل توجهی از زمان پردازش صرف ارتباطات می‌شود .

در بخش شبکه خارجی نیز این سرورها مجهز به کارت‌های شبکه ConnectX-7 با سرعت ۴۰۰ گیگابیت بر ثانیه هستند که امکان ایجاد خوشه‌های قدرتمند از چندین دستگاه DGX را فراهم می‌آورد .

نرم‌افزار؛ عامل تمایز اصلی

اگرچه سخت‌افزار قدرتمند ستون فقرات این سرورها را تشکیل می‌دهد، اما ارزش واقعی سرورهای DGX در بسته نرم‌افزاری یکپارچه آن‌ها نهفته است. این دستگاه‌ها به صورت پیش‌فرض با مجموعه نرم‌افزاری NVIDIA AI Enterprise عرضه می‌شوند.

این مجموعه شامل کتابخانه‌هایی همچون CUDA و cuDNN، فریمورک‌های بهینه‌سازی شده یادگیری عمیق، و ابزارهای مدیریت کانتینر مانند Docker و Kubernetes است .

این رویکرد «کلید در دست» بدان معناست که سازمان‌ها بلافاصله پس از نصب فیزیکی سرور، بدون نیاز به صرف ماه‌ها زمان برای کامپایل و پیکربندی کتابخانه‌های متن‌باز و رفع تداخلات نرم‌افزاری، قادر به اجرای مدل‌های خود خواهند بود.

همچنین، داشتن قرارداد پشتیبانی از سوی انویدیا، دسترسی به تیمی از متخصصان به نام DGXpert را فراهم می‌آورد که در بهینه‌سازی عملکرد و عیب‌یابی سیستم به کاربران یاری می‌رسانند .

مقیاس‌پذیری از میز کار تا ابررایانه

خانواده DGX تنها به دستگاه‌های مرکز داده محدود نمی‌شود و نیازهای متنوع کاربران را پوشش می‌دهد. برای توسعه‌دهندگان و پژوهشگرانی که به یک ایس تگاه کاری قدرتمند روی میز نیاز دارند، مدل‌هایی مانند DGX Station و DGX Spark (که پیش‌تر با نام DGX Orin شناخته می‌شد) طراحی شده‌اند.

سرورهای DGX انویدیا

این دستگاه‌های رومیزی که از ابرتراشه Grace Blackwell بهره می‌برند، امکان توسعه و آزمایش مدل‌های هوش مصنوعی را در محیط محلی فراهم می‌کنند و سپس قابلیت انتقال آسان آن مدل‌ها به خوشه‌های بزرگ‌تر را دارند .

در سوی دیگر طیف، سرورهای DGX قابلیت تجمیع در معماری‌های بزرگ‌تری به نام SuperPOD را دارند. یک ابرخوشه DGX SuperPOD می‌تواند شامل صدها گره DGX باشد که توسط شبکه‌های پرسرعت InfiniBand به هم متصل شده و به عنوان یک ابررایانه غول‌پیکر عمل می‌کنند.

جالب توجه است که در زمان معرفی، برخی از این ابرخوشه‌ها در فهرست سریع‌ترین ابررایانه‌های جهان قرار گرفته‌اند . جدیدترین نسل این سامانه‌ها از خنک‌کنندگی مایع برای مدیریت حرارت بالای تولید شده توسط تراشه‌های قدرتمند استفاده می‌کنند .

کاربردها و چشم‌انداز آینده

سرورهای DGX در صنایع گوناگونی از جمله داروسازی برای کشف دارو، خودروسازی برای توسعه خودروهای خودران، و خدمات مالی برای تشخیص تقلب مورد استفاده قرار می‌گیرند .

افزون بر استقرار در محل سازمان‌ها، شرکت انویدیا سرویس DGX Cloud را نیز ارائه می‌دهد که به مشتریان اجازه می‌دهد از همین معماری قدرتمند به صورت اجاره‌ای در ابرسرویس‌هایی همچون Microsoft Azure و Oracle Cloud Infrastructure استفاده کنند .

نتیجه‌گیری

سرورهای DGX انویدیا پاسخی کامل به نیاز روزافزون به زیرساخت یکپارچه و کارآمد هوش مصنوعی هستند. این سامانه‌ها با ترکیب پردازنده‌های گرافیکی پیشرفته، معماری ارتباطی با پهنای باند بسیار بالا، حافظه و ذخیره‌سازی سریع، و مهمتر از همه، مجموعه نرم‌افزاری بهینه‌سازی شده، راه حلی کلید در دست ارائه می‌دهند.

این یکپارچگی عمیق، زمان لازم برای راه‌اندازی و آموزش مدل‌های هوش مصنوعی را از چند ماه به چند روز کاهش می‌دهد. با ظهور نسل‌های جدید مانند سکوی Grace Blackwell و افزایش قابلیت مقیاس‌پذیری تا سطح ابررایانه‌های عظیم، خانواده DGX همچنان به عنوان معیاری برای کارایی و قابلیت اطمینان در عصر کارخانه‌های هوش مصنوعی باقی خواهند ماند.

پردازنده‌های AMD Instinct

معرفی پردازنده‌های AMD Instinct

در عصر کنونی، محاسبات با کارایی بالا و هوش مصنوعی به عنوان موتورهای محرک تحول در صنایع مختلف شناخته می‌شوند. از شبیه‌سازی‌های پیچیده علمی گرفته تا آموزش مدل‌های بزرگ زبانی، نیاز به قدرت محاسباتی روز به روز در حال افزایش است.

شرکت AMD با معرفی خانواده پردازنده‌های Instinct، پاسخی به این نیاز فزاینده ارائه داده است.

D:\digibino\posts\10 NEW\معرفی پردازنده‌های AMD Instinct

این پردازنده‌ها که به طور ویژه برای مراکز داده و ابررایانه‌ها طراحی شده‌اند، معماری نوینی را به کار گرفته‌اند تا بتوانند از عهده سنگین‌ترین بارهای محاسباتی در حوزه هوش مصنوعی و محاسبات علمی برآیند.

معماری و طراحی پردازنده‌های AMD Instinct

خانواده پردازنده‌های AMD Instinct بر پایه معماری اختصاصی CDNA (مخفف Compute DNA) طراحی شده‌اند. این معماری بر خلاف محصولات عمومی ترسیم، از ابتدا برای انجام محاسبات علمی و بارهای کاری مرتبط با هوش مصنوعی بهینه‌سازی گردیده است. آخرین نسل از این معماری تحت عنوان CDNA 3، پیشرفت‌های قابل توجهی را در زمینه تراکم محاسباتی و بهره‌وری انرژی به ارمغان آورده است. یکی از برجسته‌ترین ویژگی‌های نسل جدید این پردازنده‌ها، استفاده از فناوری پیشرفته بسته‌بندی سه‌بعدی چیپلت می‌باشد. به عنوان نمونه، پردازنده MI300X از هشت قطعه محاسباتی به نام XCD در کنار هشت قالب حافظه HBM3 تشکیل شده است. این طراحی هوشمندانه امکان دستیابی به تعداد هسته‌های محاسباتی بسیار بالا را فراهم می‌کند؛ به طوری که این پردازنده در مجموع از ۳۰۴ هسته محاسباتی بهره می‌برد که نسبت به نسل قبل افزایشی حدود ۴۰ درصدی را نشان می‌دهد.

مدل‌های مختلف و کاربردهای پردازنده‌های AMD Instinct

خانواده Instinct شامل مدل‌های گوناگونی است که هر یک برای کاربرد خاصی بهینه‌سازی شده‌اند.

D:\digibino\posts\10 NEW\معرفی پردازنده‌های AMD Instinct

مدل MI300A یک راهکار یکپارچه و منحصربه‌فرد است که هسته‌های پردازنده مرکزی Zen 4 را در کنار هسته‌های گرافیکی CDNA 3 قرار می‌دهد. این طراحی، تنگنای انتقال داده بین پردازنده و شتاب‌دهنده را از بین می‌برد و برای بارهای کاری ترکیبی همچون شبیه‌سازی‌های علمی و مدل‌های آب و هوایی ایده‌آل محسوب می‌شود.

در سوی دیگر، مدل MI300X صرفاً بر روی توان محاسباتی گرافیکی تمرکز دارد و هسته‌های پردازنده مرکزی را حذف کرده است. این محصول با در اختیار داشتن ۱۹۲ گیگابایت حافظه HBM3، به طور ویژه برای آموزش و اجرای مدل‌های بزرگ زبانی طراحی شده است.

ظرفیت بالای حافظه در این پردازنده به گونه‌ای است که مدل‌های عظیمی با ۷۰ میلیارد پارامتر را می‌توان بدون نیاز به تقسیم کردن بین چندین شتاب‌دهنده، به طور کامل در حافظه یک قطعه جای داد. جدیدترین مدل معرفی شده، MI325X نام دارد که گام دیگری در جهت افزایش ظرفیت حافظه برداشته است.

این مدل با بهره‌گیری از ۲۵۶ گیگابایت حافظه HBM3E و پهنای باند ۶ ترابایت بر ثانیه، توانایی اجرای مدل‌های با بیش از ۱۰۰ میلیارد پارامتر را به صورت تک‌قطعه فراهم می‌کند. مدل MI250X نیز به عنوان گزینه‌ای برای ابررایانه‌های بزرگ، دو هسته پردازشی را در یک بسته ارائه می‌دهد.

عملکرد و توان محاسباتی پردازنده‌های AMD Instinct

پردازنده‌های Instinct از نظر توان خام محاسباتی نیز عملکرد بسیار بالایی را ارائه می‌دهند.

مدل MI300X قادر است در محاسبات با دقت هشت بیتی که عمدتاً در فرآیند استنتاج مدل‌های هوش مصنوعی کاربرد دارد، به حداکثر توان ۲.۶ پتافلاپس دست یابد. این میزان عملکرد در محاسبات با دقت شانزده بیتی که برای آموزش مدل‌ها استفاده می‌شود، به ۱.۳ پتافلاپس می‌رسد. یکی از نکات قابل توجه، عملکرد بالای این پردازنده‌ها در محاسبات با دقت مضاعف (FP64) است. این قابلیت برای شبیه‌سازی‌های علمی بسیار حیاتی محسوب می‌شود و MI300X با ارائه ۸۱.۷ ترافلاپس عملکرد در این حوزه، جایگاه مناسبی در ابررایانه‌های رتبه‌بندی شده در فهرست TOP500 پیدا کرده است. برای مقایسه، نسبت به نسل قبلی، عملکرد در محاسبات FP64 بیش از دو برابر شده است. همچنین بهینه‌سازی‌های معماری باعث کاهش قابل توجه مصرف انرژی به ازای هر عملیات محاسباتی گردیده است.

اهمیت حافظه و پهنای باند در پردازنده‌های AMD Instinct

در محاسبات مدرن هوش مصنوعی در سیستم های هوش مصنوعی ، اغلب سرعت حافظه به اندازه قدرت محاسباتی پردازنده اهمیت دارد. پردازنده‌های Instinct با بهره‌گیری از جدیدترین نسل حافظه‌های HBM، پهنای باند بسیار بالایی را فراهم می‌کنند. مدل MI300X دارای پهنای باند ۵.۳ ترابایت بر ثانیه است که به داده‌ها اجازه می‌دهد با کمترین تأخیر بین حافظه و هسته‌های محاسباتی جابجا شوند. این ویژگی به ویژه برای مدل‌های بزرگ زبانی که نیازمند دسترسی مداوم به حجم عظیمی از پارامترها هستند، حیاتی می‌باشد. حافظه HBM3 به کار رفته در این محصولات از فناوری تصحیح خطا (ECC) پشتیبانی می‌کند که برای پایداری در محاسبات طولانی علمی ضروری است. همچنین افزایش تعداد کانال‌های حافظه نسبت به نسل قبل، گلوگاه انتقال داده را به میزان قابل توجهی کاهش داده است.

ارتباطات و مقیاس‌پذیری پردازنده‌های AMD Instinct

برای ساخت ابررایانه‌ها و خوشه‌های محاسباتی بزرگ، توانایی برقراری ارتباط سریع میان چندین پردازنده از اهمیت بالایی برخوردار است. خانواده Instinct از فناوری Infinity Fabric شرکت AMD برای ایجاد ارتباطی با پهنای باند بالا و تأخیر کم میان چندین قطعه استفاده می‌کنند. به عنوان مثال، یک سرور استاندارد می‌تواند میزبان هشت قطعه MI300X باشد که از طریق هفت لینک Infinity Fabric به یکدیگر متصل می‌شوند و یک توپولوژی کاملاً متصل را تشکیل می‌دهند. این معماری اجازه می‌دهد مجموعاً ۱.۵ ترابایت حافظه HBM3 در اختیار بارهای کاری قرار گیرد. فناوری Infinity Fabric همچنین امکان ارتباط مستقیم با پردازنده‌های مرکزی EPYC را فراهم می‌کند، به طوری که از دید نرم‌افزار، حافظه اصلی و حافظه شتاب‌دهنده به صورت یک فضای آدرس‌دهی واحد دیده می‌شود. این قابلیت، برنامه‌نویسی سیستم‌های ناهمگن را ساده‌تر می‌سازد و سربار انتقال داده را کاهش می‌دهد.

D:\digibino\posts\10 NEW\معرفی پردازنده‌های AMD Instinct

بوم‌ی سازی نرم‌افزاری

سخت‌افزار قدرتمند بدون وجود نرم‌افزارهای سازگار، کارایی لازم را نخواهد داشت. شرکت AMD با ارائه پلتفرم ROCm، یک بوم‌سازگان نرم‌افزاری باز و قدرتمند را برای پردازنده‌های Instinct فراهم کرده است. این پلتفرم از چارچوب‌های محبوب هوش مصنوعی مانند TensorFlow و PyTorch پشتیبانی می‌کند.

همچنین همکاری‌های گسترده‌ای با توسعه‌دهندگان نرم‌افزارهای علمی صورت گرفته است تا برنامه‌های کاربردی در حوزه‌هایی نظیر دینامیک مولکولی (مانند GROMACS و NAMD)، شیمی کوانتوم (CP2K) و شبیه‌سازی‌های لرزه‌ای (SPECFEM3D) بتوانند از حداکثر توان این سخت‌افزار بهره ببرند. کتابخانه‌های بهینه‌سازی شده برای الگوریتم‌های پرکاربردی مانند ضرب ماتریس (RoCS) و تبدیل فوریه سریع (rocFFT) نیز بخشی از این بوم‌سازگان هستند. مدل برنامه‌نویسی HIP که به زبان C++ شبیه است، امکان انتقال کدهای نوشته شده برای سخت‌افزارهای مشابه را با صرف زمان نسبتاً کم فراهم می‌کند.

چشم‌انداز آینده

شرکت AMD مسیر توسعه خانواده Instinct را تا سال‌های آتی ترسیم کرده است. انتظار می‌رود سری MI400 در سال ۲۰۲۶ و سری MI500 در سال ۲۰۲۷ با استفاده از فناوری ساخت ۲ نانومتر و حافظه HBM4E روانه بازار شوند. هدف این شرکت دستیابی به افزایش هزار برابری عملکرد در بازه چهار ساله است که نشان از عزم جدی برای رقابت در بازار رو به رشد شتاب‌دهنده‌های هوش مصنوعی دارد. همچنین برنامه‌هایی برای ادغام عمیق‌تر محاسبات نوری در ارتباطات بین چیپلتی وجود دارد که می‌تواند مصرف انرژی در مقیاس‌های بزرگ را به شدت کاهش دهد. یکی دیگر از اهداف اعلام شده، افزایش چگالی حافظه با استفاده از فناوری‌های جدید بسته‌بندی است تا بتوان مدل‌های با بیش از یک تریلیون پارامتر را در یک پردازنده جای داد.

نتیجه‌گیری

پردازنده‌های AMD Instinct با ارائه معماری نوین چیپلت، حافظه پرظرفیت و پهنای باند بالا، راهکار مناسبی برای چالش‌های محاسباتی عصر حاضر محسوب می‌شوند.

این محصولات با پوشش طیف گسترده‌ای از کاربردها، از شبیه‌سازی‌های علمی دقیق گرفته تا پیاده‌سازی مدل‌های پیشرفته هوش مصنوعی، جایگاه خود را در مراکز داده و ابررایانه‌های بزرگ تثبیت کرده‌اند.

توجه به معماری حافظه و پهنای باند در کنار توان محاسباتی خام، نشان از درک صحیح از نیازهای واقعی بارهای کاری مدرن دارد. با توجه به نقشه راه بلندپروازانه شرکت AMD، انتظار می‌رود این خانواده در سال‌های آینده شاهد پیشرفت‌های چشمگیرتری در زمینه عملکرد و کارایی انرژی باشد و نقش مهمی در شکل‌دهی به آینده محاسبات با کارایی بالا ایفا کند.

انتخاب بین مدل‌های مختلف این خانواده به نوع بار کاری و نیاز به یکپارچگی با پردازنده مرکزی بستگی دارد، اما در مجموع، AMD Instinct گزینه‌ای جدی و رو به رشد در بازار شتاب‌دهنده‌های محاسباتی به شمار می‌رود.

معرفی پردازنده‌های سری EPYC شرکت AMD

معرفی پردازنده‌های سری EPYC شرکت AMD

پردازنده‌های سری EPYC شرکت ای ام دی، یکی از پیشرفته‌ترین خانواده‌های پردازنده برای سرورها و مراکز داده محسوب می‌شوند. این پردازنده‌ها از سال ۲۰۱۷ با معماری انقلابی «زن» وارد بازار شدند و توانستند رقابت را در بازاری که پیش از آن تقریباً در انحصار یک شرکت دیگر بود، احیا کنند.

در عصر داده‌های بزرگ و رایانش ابری، نیاز به پردازنده‌هایی که هم توان محاسباتی بالا و هم بازدهی انرژی مناسبی داشته باشند، بیش از هر زمان دیگری حس می‌شود. شرکت ای ام دی با معرفی پردازنده‌های سری EPYC، تحولی بنیادین در دنیای پردازشگرهای سرور ایجاد کرد. بر خلاف پردازنده‌های مصرفی که برای رایانه‌های شخصی طراحی می‌شوند، پردازنده‌های سری EPYC برای اجرای بی‌وقفه و سنگین‌ترین بارهای کاری در مراکز داده، سامانه‌های ابری، پایگاه‌های داده بزرگ، شبیه‌سازی‌های علمی و سامانه‌های هوش مصنوعی بهینه شده‌اند.

معماری چیپلت (چندقلو)

مهم‌ترین نوآوری در پردازنده‌های EPYC، استفاده از معماری به نام «چیپلت» است. در این معماری، به جای آنکه همه بخش‌های یک پردازنده شامل هسته‌های محاسباتی، حافظه نهان و کنترل‌کننده ورودی و خروجی روی یک قطعه سیلیکونی بزرگ ساخته شوند، هر کدام از این بخش‌ها به صورت یک قطعه کوچک و مجزا به نام «چیپلت» طراحی می‌گردند. سپس این چیپلت‌ها در کنار یکدیگر روی یک بستر ارتباطی نصب می‌شوند. مزیت اصلی این روش، کاهش هزینه تولید و افزایش انعطاف‌پذیری است. زیرا ای ام دی می‌تواند بدون طراحی دوباره کل پردازنده، فقط چیپلت هسته‌ها را با نسل جدید جایگزین کند و بقیه اجزا را حفظ نماید. این ویژگی همچنین امکان افزایش تعداد هسته‌ها را بدون افزایش چشمگیر هزینه فراهم می‌سازد.

ریزمعماری‌های زن (Zen)

قلب پردازنده‌های EPYC، ریزمعماری «زن» است. این معماری از زمان معرفی خود تاکنون در نسل‌های مختلف بهبود یافته است.

هر نسل از ریزمعماری زن، بهبودهایی در تعداد دستورالعمل‌های اجرا شده در هر سیکل ساعت، کاهش تأخیر در دسترسی به حافظه و افزایش بازدهی انرژی داشته است.

  • معماری زن ۱ (Zen 1): نسل اول پردازنده‌های EPYC بر پایه این معماری ساخته شد و حداکثر ۳۲ هسته را ارائه می‌داد.
  • معماری زن ۲ (Zen 2): این نسل شاهد تقسیم چیپلت هسته‌ها به چیپلت‌های کوچک‌تر بود و تعداد هسته‌ها را به ۶۴ عدد افزایش داد.
  • معماری زن ۳ (Zen 3): بازطراحی دسترسی به حافظه نهان مشترک، باعث افزایش چشمگیر عملکرد در این نسل شد.
  • معماری زن ۴ (Zen 4): پشتیبانی از حافظه دی دی آر پنج (DDR5) و پی سی آی اکسپرس نسل پنجم (PCIe 5.0) از مهم‌ترین ویژگی‌های این نسل است.
  • معماری زن ۵ (Zen 5): جدیدترین نسل که با فرایند ساخت سه نانومتری تولید می‌شود و تا ۱۹۲ هسته را پشتیبانی می‌کند.

معرفی خانواده‌های مختلف پردازنده‌های EPYC

پردازنده‌های EPYC در دسته‌بندی‌های متفاوتی عرضه می‌شوند تا نیازهای گوناگون از یک سرور کوچک گرفته تا ابررایانه‌های عظیم و سیستم های هوش مصنوعی را پوشش دهند.

معرفی پردازنده‌های سری EPYC شرکت AMD

پردازنده‌های EPYC سری ۹۰۰۵

این سری قدرتمندترین نسل است که بر پایه معماری زن ۵ طراحی شده و برای سنگین‌ترین بارهای کاری مانند هوش مصنوعی و شبیه‌سازی‌های علمی پیشرفته مناسب می‌باشد. حداکثر تعداد هسته در این سری به ۱۹۲ هسته و ۳۸۴ رشته می‌رسد. حافظه نهان سطح سه نیز تا ۳۸۴ مگابایت افزایش یافته است. پشتیبانی از دوازده کانال حافظه دی دی آر پنج با سرعت شش هزار مگاهرتز و همچنین صد و شصت خط پی سی آی اکسپرس نسل پنجم، از ویژگی‌های برجسته این خانواده است.

پردازنده‌های EPYC سری ۹۰۰۴

این نسل که با معماری زن ۴ ساخته شده، همچنان یکی از گزینه‌های اصلی برای مراکز داده بزرگ به شمار می‌رود. حداکثر هسته در این سری ۹۶ هسته و ۱۹۲ رشته است. نکته قابل توجه در برخی مدل‌های این سری، استفاده از فناوری «حافظه نهان سه بعدی» است که حافظه نهان را تا بیش از هزار مگابایت افزایش می‌دهد. این ویژگی برای پایگاه‌های داده و برنامه‌هایی که به حافظه نهان بزرگ نیاز دارند، بسیار حیاتی است.

پردازنده‌های EPYC سری ۸۰۰۴

این پردازنده‌ها برای محیط‌هایی با محدودیت فیزیکی و مصرف انرژی پایین طراحی شده‌اند. حداکثر هسته در این سری ۶۴ هسته و ۱۲۸ رشته است. تفاوت اصلی این سری با سایرین در این است که فقط در پیکربندی یک سوکتی (تک پردازنده) قابل استفاده هستند. مصرف انرژی این خانواده بین صد تا دویست وات است و برای تجهیزات مخابراتی در لبه شبکه یا فروشگاه‌های بزرگ مناسب می‌باشد.

پردازنده‌های EPYC سری ۷۰۰۳

این خانواده با وجود گذشت چند سال از عرضه آن، به دلیل تعادل عالی بین قیمت و عملکرد، همچنان در بسیاری از مراکز داده مورد استفاده قرار می‌گیرد. این پردازنده‌ها بر پایه معماری زن ۳ ساخته شده‌اند و حداکثر ۶۴ هسته دارند. پشتیبانی از حافظه دی دی آر چهار و پی سی آی اکسپرس نسل چهارم، هزینه ساخت سرورهای مبتنی بر این نسل را کاهش می‌دهد.

پردازنده‌های EPYC سری ۴۰۰۴ و ۴۰۰۵

این خانواده برای کسب و کارهای کوچک و متوسط و سرورهای ابتدایی طراحی شده است. حداکثر هسته در این سری ۱۶ هسته و ۳۲ رشته می‌باشد. آخرین نسل از این خانواده بر پایه معماری زن ۵ ساخته می‌شود و از حافظه دی دی آر پنج پشتیبانی می‌کند. مصرف انرژی این پردازنده‌ها بین شصت و پنج تا یکصد و هفتاد وات متغیر است.

پردازنده‌های نهفته (Embedded)

شرکت ای ام دی نسخه خاصی از پردازنده‌های EPYC را برای کاربردهای صنعتی، تجهیزات پزشکی، سامانه‌های نظامی و شبکه‌های مخابراتی با نام «نهفته» عرضه کرده است. این پردازنده‌ها ویژگی مهمی به نام «چرخه حیات طولانی» دارند که به معنای دسترسی به قطعه به مدت هفت تا ده سال است. همچنین این قطعات برای تحمل دماهای بسیار پایین و بسیار بالا و نیز لرزش‌های شدید طراحی شده‌اند. خانواده‌های ۳۰۰۰، ۴۰۰۰، ۷۰۰۰، ۸۰۰۰ و ۹۰۰۰ هر کدام نسخه نهفته نیز دارند.

ویژگی‌های امنیتی

در عصر رایانش ابری، امنیت داده‌ها در زمانی که پردازش می‌شوند (بر خلاف زمان ذخیره‌سازی روی دیسک) چالش بزرگی است. پردازنده‌های EPYC به مجموعه فناوری به نام «اینفینیتی گارد» تجهیز شده‌اند.

معرفی پردازنده‌های سری EPYC شرکت AMD

این مجموعه شامل یک پردازنده امنیتی مجزا است که در دل پردازنده اصلی قرار دارد. دو قابلیت اصلی آن عبارتند از:

  • رمزنگاری ایمن حافظه: تمام محتویات حافظه اصلی به صورت خودکار و شفاف رمزنگاری می‌شود، بدون آنکه نیازی به تغییر نرم‌افزار باشد.
  • مجازی‌سازی ایمن رمزنگاری شده: این قابلیت اجازه می‌دهد تا هر ماشین مجازی به صورت کاملاً مجزا رمزنگاری شود و حتی مدیر سیستم میزبان هم نتواند به داده‌های ماشین مجازی دسترسی پیدا کند.

بهره‌وری انرژی و کاربردهای اصلی

یکی از نقاط قوت اصلی پردازنده‌های EPYC، نسبت عملکرد به مصرف انرژی است. استفاده از فرایندهای ساخت پیشرفته مانند سه نانومتر و چهار نانومتر، همراه با معماری چیپلت که بخش‌های غیرفعال را کاهش می‌دهد، باعث شده است که این پردازنده‌ها در ازای هر وات انرژی مصرفی، عملکرد بسیار بالایی ارائه دهند. این ویژگی هزینه برق مراکز داده را کاهش می‌دهد.

کاربردهای اصلی این پردازنده‌ها به شرح زیر است:

  • رایانش ابری و مراکز داده بزرگ: ارائه دهندگان بزرگی مانند آمازون، گوگل و مایکروسافت از EPYC در زیرساخت خود استفاده می‌کنند.
  • هوش مصنوعی و یادگیری ماشین: تعداد بالای هسته‌ها و پشتیبانی از دستورالعمل‌های برداری پیشرفته، این پردازنده‌ها را برای آموزش مدل‌های هوش مصنوعی مناسب ساخته است.
  • پایگاه‌های داده: حافظه نهان بزرگ در مدل‌های مجهز به فناوری سه بعدی، عملکرد تراکنش‌های پایگاه داده را چند برابر می‌کند.
  • زیرساخت شبکه و امنیت: قابلیت شتابدهی سخت‌افزاری رمزنگاری، این پردازنده‌ها را برای ساخت فایروال‌ها و مسیریاب‌های نسل جدید ایده‌آل می‌سازد.

نتیجه‌گیری

پردازنده‌های سری EPYC شرکت ای ام دی با کنار گذاشتن روش‌های سنتی طراحی و روی آوردن به معماری چیپلت و ریزمعماری‌های کارآمد زن، توانسته‌اند استانداردهای جدیدی در صنعت پردازنده‌های سرور تعریف کنند. تنوع بالای مدل‌ها از سری ۴۰۰۴ مناسب برای کسب و کارهای کوچک تا سری ۹۰۰۵ با ۱۹۲ هسته برای ابررایانه‌ها، نشان دهنده بلوغ این پلتفرم است. با توجه به روند افزایشی داده‌ها و نیاز روزافزون به پردازش امن و کارآمد، انتظار می‌رود نسل‌های آینده EPYC با بهبودهای بیشتر در عملکرد، مصرف انرژی و امنیت، نقشی کلیدی در زیرساخت دیجیتال جهان ایفا کنند. این پردازنده‌ها نه تنها رقابت را به بازار بازگردانده‌اند، بلکه گزینه‌های متعددی را پیش روی مهندسان و مدیران فناوری اطلاعات برای ساخت سامانه‌های قدرتمند و مقرون به صرفه قرار داده‌اند.

کارت گرافیک RTX PRO 6000 Blackwell

معرفی کارت گرافیک RTX PRO 6000 Blackwell

کارت گرافیک RTX PRO 6000 Blackwell، جدیدترین محصول حرفه‌ای شرکت انویدیا، بر پایه معماری پیشرفته بلک‌ول طراحی شده است. این کارت با هدف پاسخگویی به نیازهای سنگین محاسباتی در حوزه‌های هوش مصنوعی، رندرینگ سه‌بعدی، و پردازش‌های علمی حرفه‌ای معرفی گردیده است.

معرفی کارت گرافیک RTX PRO 6000 Blackwell

شرکت Nvidia همواره به عنوان یکی از پیشگامان صنعت تولید پردازشگرهای گرافیکی شناخته می‌شود. این شرکت با معرفی معماری بلک‌ول، گامی بلند در جهت یکپارچه‌سازی قابلیت‌های پیشرفته هوش مصنوعی و پردازش گرافیکی برداشته است. کارت گرافیک RTX PRO 6000 Blackwell، به عنوان پرچمدار محصولات حرفه‌ای این معماری، قدرت پردازشی بی‌نظیری را برای کاربران حرفه‌ای به ارمغان آورده است.

معماری بلک‌ول

معماری بلک‌ول، قلب تپنده این کارت گرافیکی محسوب می‌شود. این معماری نسل جدید، بهبودهای چشمگیری نسبت به نسل‌های پیشین داشته است.

معرفی کارت گرافیک RTX PRO 6000 Blackwell

از مهم‌ترین ویژگی‌های این معماری می‌توان به هسته‌های تنسور نسل پنجم، هسته‌های رهگیری پرتو نسل چهارم، و واحدهای پردازش جریانی پیشرفته اشاره نمود.

هسته‌های تنسور نسل پنجم، عملکردی تا سه برابر نسل قبل ارائه می‌دهند و از دقت محاسباتی FP4 پشتیبانی می‌کنند. این قابلیت، سرعت پردازش مدل‌های زبانی بزرگ و برنامه‌های هوش مصنوعی مولد را به شکل قابل توجهی افزایش می‌دهد. هسته‌های رهگیری پرتو نسل چهارم نیز عملکردی دو برابر نسل پیشین داشته و امکان رندرینگ صحنه‌های فوتورئالیستیک با جزئیات بی‌نظیر را فراهم می‌آورند.

مشخصات فنی برجسته کارت گرافیک RTX PRO 6000 Blackwell

حافظه گرافیکی یکی از نقاط قوت اصلی این محصول به شمار می‌رود. RTX PRO 6000 Blackwell به ۹۶ گیگابایت حافظه GDDR7 مجهز شده است که با پهنای باند ۱۷۹۲ گیگابایت بر ثانیه، توانایی پردازش حجم عظیمی از داده‌ها را در کمترین زمان ممکن دارد. وجود فناوری تصحیح خطا (ECC) نیز صحت داده‌ها را در محاسبات حساس تضمین می‌نماید.

از نظر توان پردازشی، این کارت دارای ۲۴۰۶۴ هسته CUDA بوده که ۲۳۴۰ هسته بیشتر از کارت مصرفی RTX 5090 می‌باشد. این تعداد هسته، قدرت خام پردازش موازی را به حداکثر ممکن رسانده است. حداکثر توان مصرفی این قطعه ۶۰۰ وات تعیین شده که با توجه به عملکرد ارائه شده، رقم قابل قبولی به نظر می‌رسد.

قابلیت‌های تخصصی کارت گرافیک RTX PRO 6000 Blackwell

پشتیبانی از دقت محاسباتی FP4، یکی از قابلیت‌های منحصربه‌فرد این محصول است. این ویژگی، عملکرد استنتاج مدل‌های هوش مصنوعی را تا ۱.۳۲ برابر نسبت به دقت FP8 افزایش می‌دهد.

معرفی کارت گرافیک RTX PRO 6000 Blackwell

در آزمایش‌های انجام شده، این کارت موفق شد عملکردی ۱.۶۳ برابر بهتر از کارت گرافیک H100 انویدیا در بار کاری ۱۰۰ درخواست همزمان ارائه دهد.

فناوری چند نمونه گرافیکی (MIG) امکان تقسیم کارت به چهار نمونه مجزا و ایزوله را فراهم می‌کند. هر نمونه دارای حافظه، حافظه نهان، و هسته‌های محاسباتی مستقل بوده و کیفیت سرویس تضمین شده‌ای دریافت می‌کند. این قابلیت برای محیط‌های مجازی‌سازی و استفاده همزمان چند کاربر، بسیار ارزشمند است.

پشتیبانی از DisplayPort 2.1، امکان اتصال نمایشگرهایی با رزولوشن ۸K در نرخ ۲۴۰ هرتز یا ۱۶K در نرخ ۶۰ هرتز را فراهم می‌سازد. چهار پورت خروجی روی کارت تعبیه شده که راه‌اندازی سیستم‌های چندنمایشگری را میسر می‌سازد.

نسخه‌های مختلف کارت گرافیک RTX PRO 6000 Blackwell

این کارت گرافیکی در سه نسخه اصلی عرضه می‌شود که هر کدام کاربرد خاص خود را دارند:

نسخه ایستگاه کاری استاندارد با توان مصرفی ۶۰۰ وات و خنک‌سازی دوگانه، برای سیستم‌هایی طراحی شده که حداکثر عملکرد در یک پردازشگر مد نظر است. این نسخه، بهترین انتخاب برای کاربرانی است که به دنبال بیشترین توان پردازشی هستند.

نسخه Max-Q با توان مصرفی ۳۰۰ وات و خنک‌سازی فعال، برای پیکربندی‌های فشرده و استفاده همزمان از چند کارت بهینه شده است. این نسخه امکان استفاده از چهار کارت در یک سیستم را فراهم می‌کند.

نسخه سرور با خنک‌سازی غیرفعال و توان مصرفی ۴۰۰ تا ۶۰۰ وات، برای استقرار در مراکز داده و محیط‌های سروری طراحی گردیده است.

کاربردها و سناریوهای استفاده

توسعه هوش مصنوعی، مهم‌ترین کاربرد این کارت گرافیکی به شمار می‌رود. با ۹۶ گیگابایت حافظه، امکان پردازش مدل‌های زبانی بزرگ با ۲۳۰ میلیارد پارامتر به صورت محلی وجود دارد. بنابرین از نظر کاربرد میتوان این کارت گرافیک را یکی از بهترین گزینه ها برای سیستم های هوش مصنوعی دانست.

معرفی کارت گرافیک RTX PRO 6000 Blackwell

آزمایش‌های عملی نشان داده که یک دستگاه RTX PRO 6000 عملکردی معادل چهار کارت RTX 5090 در پردازش مدل‌های بزرگ هوش مصنوعی دارد، در حالی که مصرف انرژی آن تنها ۶۰۰ وات در مقابل ۲۳۰۰ وات است.

علم داده و تحلیل، حوزه دیگری است که از این کارت بهره می‌برد. با استفاده از کتابخانه‌هایی مانند RAPIDS، فرآیندهای تحلیل داده تا چندین برابر سریع‌تر انجام می‌شود. حافظه ۹۶ گیگابایتی امکان کار با مجموعه داده‌های عظیم را بدون نیاز به منابع ابری فراهم می‌کند.

رندرینگ و محتوای بصری، از دیگر کاربردهای اصلی است. هسته‌های رهگیری پرتو نسل چهارم، همراه با فناوری‌های نورومورفیک، رندرینش صحنه‌های فوتورئالیستیک را به شکل بی‌سابقه‌ای تسریع می‌بخشند. کدک‌های نسل نهم و ششم نیز پردازش ویدئو با کیفیت ۴:۲:۲ را با سرعت و کیفیت بالا امکان‌پذیر ساخته‌اند.

تحلیل هزینه به عملکرد

با قیمت پایه ۹۵۰۰ دلار، RTX PRO 6000 Blackwell یک سرمایه‌گذاری سنگین محسوب می‌شود. اما زمانی که هزینه کل مالکیت مورد بررسی قرار گیرد، ارزش اقتصادی آن آشکار می‌شود. پیکربندی چهار کارت RTX 5090 برای دستیابی به عملکرد مشابه در بارهای کاری هوش مصنوعی، حدود ۱۴۰۰۰ دلار هزینه داشته و حدود ۲۳۰۰ وات توان مصرف می‌کند. در مقابل، یک دستگاه RTX PRO 6000 با ۹۵۰۰ دلار و ۶۰۰ وات، عملکردی برابر ارائه می‌دهد.

هزینه‌های مربوط به خنک‌سازی، زیرساخت برق، و نگهداری نیز در پیکربندی چند کارتی به مراتب بیشتر است. بنابراین برای سازمان‌هایی که نیازمند اجرای مدل‌های بزرگ هوش مصنوعی به صورت محلی هستند، این کارت انتخاب اقتصادی‌تری به شمار می‌رود.

جمع‌بندی

کارت گرافیک RTX PRO 6000 Blackwell، نقطه عطفی در تاریخ پردازشگرهای گرافیکی حرفه‌ای محسوب می‌شود.

ترکیب حافظه ۹۶ گیگابایتی GDDR7، معماری پیشرفته بلک‌ول، و قابلیت‌های منحصربه‌فردی مانند پشتیبانی از FP4 و MIG، آن را به ابزاری قدرتمند برای متخصصان هوش مصنوعی، دانشمندان داده، و طراحان حرفه‌ای تبدیل کرده است.

اگرچه قیمت این محصول بالا است، اما با در نظر گرفتن هزینه کل مالکیت و عملکرد استثنایی آن در بارهای کاری سنگین، سرمایه‌گذاری معقولی برای سازمان‌هایی محسوب می‌شود که به دنبال راه‌اندازی زیرساخت قدرتمند محلی برای پردازش‌های هوش مصنوعی و رندرینگ پیشرفته هستند. آینده صنعت پردازش گرافیکی، بدون شک تحت تأثیر قابلیت‌هایی از این دست قرار خواهد گرفت و رقابت در این حوزه را به سطح بالاتری خواهد برد.