
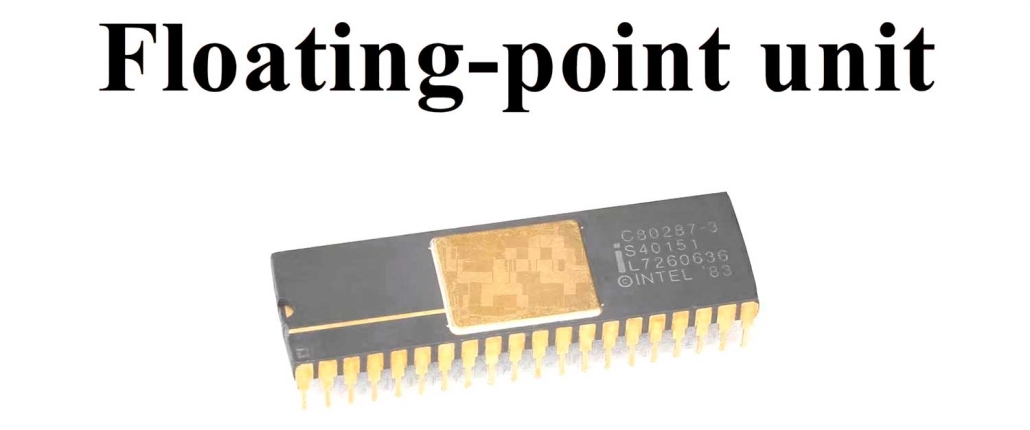
Floating Point Performance چیست؟
در دنیای محاسبات دیجیتال، پردازش اعداد یکی از بنیادیترین وظایف هر سامانه رایانهای به شمار میرود. اما همه اعداد به یک شکل پردازش نمیشوند. اعداد صحیح با اعداد اعشاری تفاوت بنیادین دارند و این تفاوت در نحوه ذخیرهسازی و محاسبه آنها تأثیر مستقیم میگذارد. اصطلاح «عملکرد ممیز شناور» یا «Floating Point Performance» به توانایی یک پردازنده یا سامانه محاسباتی در انجام عملیات ریاضی روی اعداد اعشاری با دقت بالا اشاره دارد.
این عملیات شامل جمع، تفریق، ضرب، تقسیم و همچنین توابع پیچیدهتر مانند توان، ریشه، لگاریتم و عملیات مثلثاتی میشود. درک این مفهوم برای متخصصان علوم کامپیوتر، مهندسان، پژوهشگران حوزه سیستم های هوش مصنوعی، گرافیک رایانهای، شبیهسازیهای علمی و بسیاری از رشتههای دیگر ضروری است.
تعریف ممیز شناور FPU
برای درک عملکرد ممیز شناور، ابتدا باید بدانیم ممیز شناور چیست. ممیز شناور روشی برای نمایش اعداد حقیقی در حافظه کامپیوتر است. در این روش، یک عدد به سه بخش علامت، نما و مانتیس (قسمت کسری) تقسیم میشود. فرمول کلی به صورت (۱)⁺ᵗ × مانتیس × ۲^(نما) نوشته میشود. این روش امکان نمایش طیف بسیار وسیعی از اعداد، از اعداد بسیار کوچک تا بسیار بزرگ را با دقت نسبتاً ثابت فراهم میکند. استاندارد رایج برای این کار، استاندارد IEEE ۷۵۴ است که دو نوع اصلی دارد: دقت تکی (۳۲ بیتی) و دقت دوگانه (۶۴ بیتی).

در دقت تکی، ۲۳ بیت برای مانتیس، ۸ بیت برای نما و یک بیت برای علامت اختصاص مییابد. در دقت دوگانه، ۵۲ بیت مانتیس، ۱۱ بیت نما و یک بیت علامت دارد. عملکرد ممیز شناور به سرعت و صحت انجام محاسبات روی این اعداد در واحد پردازش مرکزی یا واحد پردازش گرافیکی گفته میشود.
اهمیت عملکرد ممیز شناور FPU
عملکرد ممیز شناور یکی از شاخصهای کلیدی در ارزیابی قدرت محاسباتی پردازندهها به شمار میرود. دلیل این اهمیت آن است که بسیاری از مسائل علمی و مهندسی ذاتاً با اعداد حقیقی سروکار دارند. برای نمونه، شبیهسازی وضعیت آب و هوا، محاسبات دینامیک سیالات، تحلیل تنش در سازههای مهندسی، مدلسازی میدانهای الکترومغناطیسی، پردازش سیگنالهای دیجیتال، و حتی الگوریتمهای یادگیری ماشین و شبکههای عصبی عمیق همه و همه به میزان زیادی به عملیات ممیز شناور وابسته هستند. در واقع، در دهههای اخیر، نیاز به پردازش سریع اعداد اعشاری به قدری افزایش یافته است که شرکتهای سازنده پردازنده، واحدهای مجزایی به نام FPU (واحد ممیز شناور) را درون پردازندههای خود تعبیه کردهاند. بدون وجود چنین واحدهایی، انجام محاسبات اعشاری به روش نرمافزاری بسیار کند و غیرعملی خواهد بود. بنابراین، بهبود عملکرد ممیز شناور به طور مستقیم موجب افزایش سرعت اجرای برنامههای علمی و مهندسی میشود.
عوامل مؤثر بر عملکرد ممیز شناور FPU
عملکرد ممیز شناور تحت تأثیر عوامل متعددی قرار دارد. اولین و مهمترین عامل، معماری خود پردازنده است. تعداد واحدهای FPU، پهنای باند حافظه، میزان حافظه نهان (کش) و فناوری ساخت ترانزیستورها نقش تعیینکنندهای دارند.
برای نمونه، پردازندههای مدرن ممکن است دارای چندین واحد SIMD (دستورالعمل مجرد چند داده) مانند AVX در پردازندههای اینتل یا SVE در معماری آرم باشند که قادرند در یک چرخه ساعت چندین عملیات ممیز شناور را به صورت موازی انجام دهند.
عامل دوم، نوع داده و دقت مورد نیاز است. محاسبات با دقت دوگانه به طور معمول دو برابر محاسبات با دقت تکی زمان میبرند، هرچند که در برخی پردازندههای ویژه این تفاوت کمتر شده است.
عامل سوم، الگوی دسترسی به حافظه است. اگر دادهها در حافظه نهان قرار داشته باشند، سرعت محاسبات بسیار بیشتر از حالتی است که دادهها باید از حافظه اصلی یا حافظه مجازی بازیابی شوند.
عامل چهارم، وجود دستورالعملهای خاص مانند FMA (ضرب و جمع توأم) است که دو عملیات را در یک دستورالعمل انجام میدهد و هم سرعت را افزایش میدهد و هم خطای گردکردن را کاهش میدهد.
تفاوت عملکرد ممیز شناور FPU با عملکرد اعداد صحیح
درک تفاوت میان محاسبات ممیز شناور و محاسبات اعداد صحیح برای تحلیل عملکرد سیستم ضروری است. اعداد صحیح به صورت دقیق و بدون خطا در حافظه نمایش داده میشوند و عملیات روی آنها مانند جمع و ضرب معمولاً در یک یا دو چرخه ساعت انجام میگیرد. در مقابل، اعداد ممیز شناور به دلیل ماهیت تقریبی خود، همواره با خطای گردکردن همراه هستند و عملیات روی آنها به مراحل بیشتری نیاز دارد.

برای مثال، جمع دو عدد ممیز شناور نیازمند همترازسازی نماها، جمع مانتیسها و سپس نرمالسازی نتیجه است که ممکن است چندین چرخه ساعت طول بکشد. همچنین، تقسیم ممیز شناور یا محاسبه توابع مثلثاتی بسیار پرهزینهتر از عملیات ساده روی اعداد صحیح است. به همین دلیل، در پردازندههای همه منظوره، عملکرد ممیز شناور همواره پایینتر از عملکرد اعداد صحیح است.
با این حال، در پردازندههای تخصصی مانند واحدهای پردازش گرافیکی (GPU) که برای گرافیک و محاسبات علمی طراحی شدهاند، تعداد بسیار زیاد واحدهای FPU موازی میتواند عملکرد ممیز شناور بسیار بالایی ارائه دهد، حتی بالاتر از عملکرد عدد صحیح در همان تراشه.
کاربردهای عملی عملکرد ممیز شناور FPU
برای درک بهتر اهمیت این مفهوم، برخی از مهمترین کاربردهای عملی را مرور میکنیم. در هوش مصنوعی و یادگیری عمیق، هزاران میلیارد عملیات ممیز شناور برای آموزش یک مدل بزرگ مورد نیاز است.
به همین دلیل، تراشههای تخصصی مانند TPU گوگل و پردازندههای گرافیکی انویدیا به طور خاص برای بهینهسازی عملکرد ممیز شناور (اغلب با دقت کمتر مانند ۱۶ بیتی) طراحی شدهاند. در گرافیک رایانهای، هر پیکسل روی صفحه نمایش نیازمند محاسبات ممیز شناور برای تعیین رنگ، روشنایی، سایه و بافت است.
بازیهای رایانهای مدرن و نرمافزارهای شبیهسازی سه بعدی به میلیونها عملیات ممیز شناور در هر فریم نیاز دارند. در علوم و مهندسی، شبیهسازیهای عددی مانند پیشبینی وضعیت هوا، شبیهسازی جریان هوا بر روی بال هواپیما، مدلسازی راکتورهای هستهای و تحلیل دینامیک مولکولی همگی به شدت به کارایی ممیز شناور وابسته هستند.
همچنین در مالی و اقتصاد محاسباتی، مدلسازی ریسک، قیمتگذاری اختیار معامله و تحلیل سریهای زمانی نیازمند محاسبات اعشاری سریع و دقیق است.
روشهای اندازهگیری عملکرد ممیز شناور FPU
برای ارزیابی و مقایسه عملکرد ممیز شناور در سامانههای مختلف، معیارها و بنچمارکهای استانداردی وجود دارد. واحد اصلی سنجش، FLOPS (عملیات ممیز شناور در ثانیه) است.

این واحد میتواند با پیشوندهای کیلو، مگا، گیگا، ترا، پتا و اکسا بیان شود. برای نمونه، یک ابررایانه مدرن ممکن است چندین اگزافلاپس عملکرد داشته باشد. بنچمارک LINPACK که برای رتبهبندی ابررایانهها در فهرست TOP۵۰۰ استفاده میشود، عملکرد ممیز شناور را در حل دستگاه معادلات خطی اندازهگیری میکند.
بنچمارکهای دیگری مانند SPECfp، Geekbench و PolyBench نیز معیارهای شناخته شدهای هستند. همچنین توسعهدهندگان نرمافزار میتوانند با استفاده از ابزارهایی مانند Perf در لینوکس، VTune از اینتل یا ابزارهای ردیابی مانند Nsight برای پردازندههای گرافیکی، عملکرد بخشهای مختلف کد خود را بررسی کنند. اندازهگیری دقیق نیازمند تکرار آزمایشها و در نظر گرفتن عواملی مانند دمای پردازنده، فرکانس پویا و تداخل سایر فرایندها است.
روشهای بهینهسازی و افزایش عملکرد ممیز شناور FPU
برای بهبود عملکرد ممیز شناور در یک برنامه خاص، راهکارهای گوناگونی وجود دارد. اولین راهکار، بهرهگیری از موازیسازی در سطح داده با استفاده از دستورالعملهای SIMD است.
اگر کامپایلر به صورت خودکار نتواند کد را بهینه کند، برنامهنویس میتواند به صورت دستی از توابع داخلی یا اینترینسیکها استفاده کند. راهکار دوم، کاهش تبدیلهای غیرضروری میان انواع دادههای صحیح و اعشاری است، زیرا هر تبدیل هزینه اضافی دارد.
راه حل سوم، استفاده از الگوریتمهایی با پایداری عددی بهتر است که به دقت کمتری نیاز دارند و در نتیجه خطای گردکردن را کاهش داده و گاهی باعث افزایش سرعت میشوند. راهکار چهارم، بهبود محلی بودن ارجاعات حافظه است تا دادهها تا حد امکان در حافظه نهان باقی بمانند.
راهکار پنجم، جایگزین کردن عملیات پرهزینه مانند تقسیم با عملیات ارزانتر مانند ضرب در معکوس عدد (در صورت وجود دقت کافی) است. همچنین، در برخی کاربردها میتوان از دقت کمتر (مثلاً ۱۶ بیتی به جای ۳۲ بیتی) استفاده کرد که هم سرعت را افزایش میدهد و هم مصرف انرژی را کاهش میدهد.
نتیجه گیری
عملکرد ممیز شناور یکی از جنبههای حیاتی محاسبات مدرن است که مستقیماً بر سرعت و کارایی برنامههای علمی، مهندسی، گرافیکی و هوش مصنوعی تأثیر میگذارد. این مفهوم به توانایی پردازنده در انجام عملیات ریاضی روی اعداد اعشاری با رعایت استانداردهایی مانند IEEE ۷۵۴ اشاره دارد.
عواملی مانند معماری پردازنده، دقت دادهها، الگوی دسترسی به حافظه و وجود دستورالعملهای تخصصی همگی بر این عملکرد اثر میگذارند. اندازهگیری آن با واحد FLOPS و بنچمارکهای استانداردی مانند LINPACK انجام میشود.
با توجه به رشد روزافزون نیاز به محاسبات سنگین در حوزههایی مانند یادگیری عمیق، شبیهسازیهای پیچیده علمی و واقعیت مجازی، بهینهسازی و بهبود عملکرد ممیز شناور همچنان یکی از اولویتهای اصلی طراحان سخت افزار و توسعهدهندگان نرم افزار باقی خواهد ماند. درک صحیح این مفهوم به متخصصان کمک میکند تا معماریهای بهتر، الگوریتمهای کارآمدتر و کدهای سریعتری تولید کنند و در نتیجه گامهای مؤثرتری در پیشبرد مرزهای دانش و فناوری بردارند.
دیدگاه خود را ثبت کنید
تمایل دارید در گفتگوها شرکت کنید؟در گفتگو ها شرکت کنید.