LLM

سیستم‌های مناسب برای LLM

در سال‌های اخیر، مدل‌های زبانی بزرگ که به اختصار LLM نامیده می‌شوند، به عنوان یکی از پیشرفت‌های بنیادین در حوزه هوش مصنوعی مطرح شده‌اند. این مدل‌ها توانایی تولید متن، پاسخ به پرسش‌ها، خلاصه‌سازی محتوا و حتی انجام استدلال‌های پیچیده را دارند.

با این حال، توسعه و اجرای این LLMها بدون وجود سیستم‌های فنی مناسب تقریبا غیرممکن است. مدل‌های زبانی بزرگ به دلیل حجم عظیم داده‌های آموزشی، تعداد بسیار زیاد پارامترها و نیاز به توان محاسباتی بالا، به زیرساخت‌های ویژه‌ای نیاز دارند.

سیستم‌های محاسباتی سخت‌افزاری برای LLM

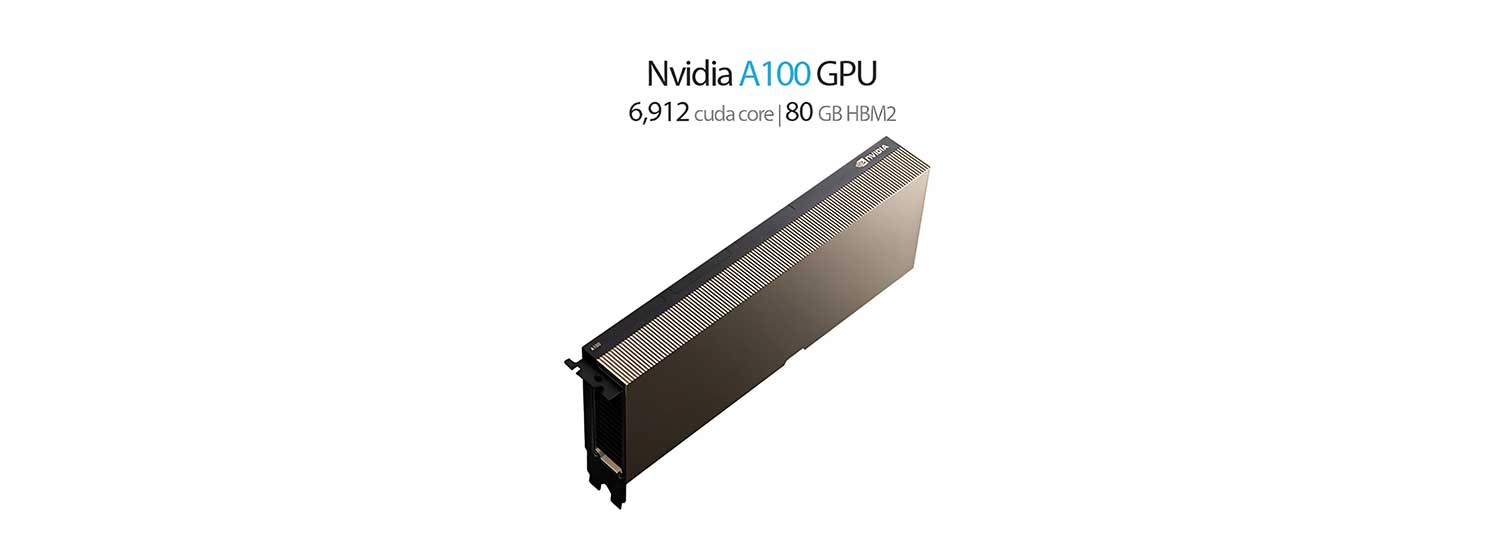
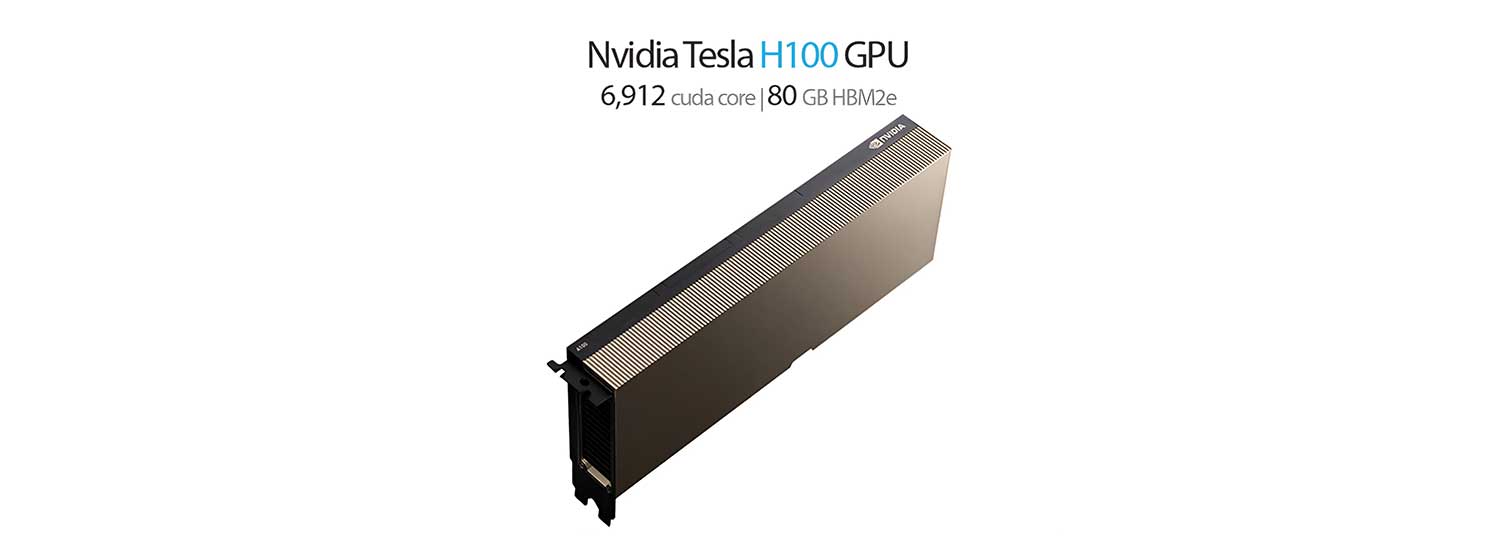
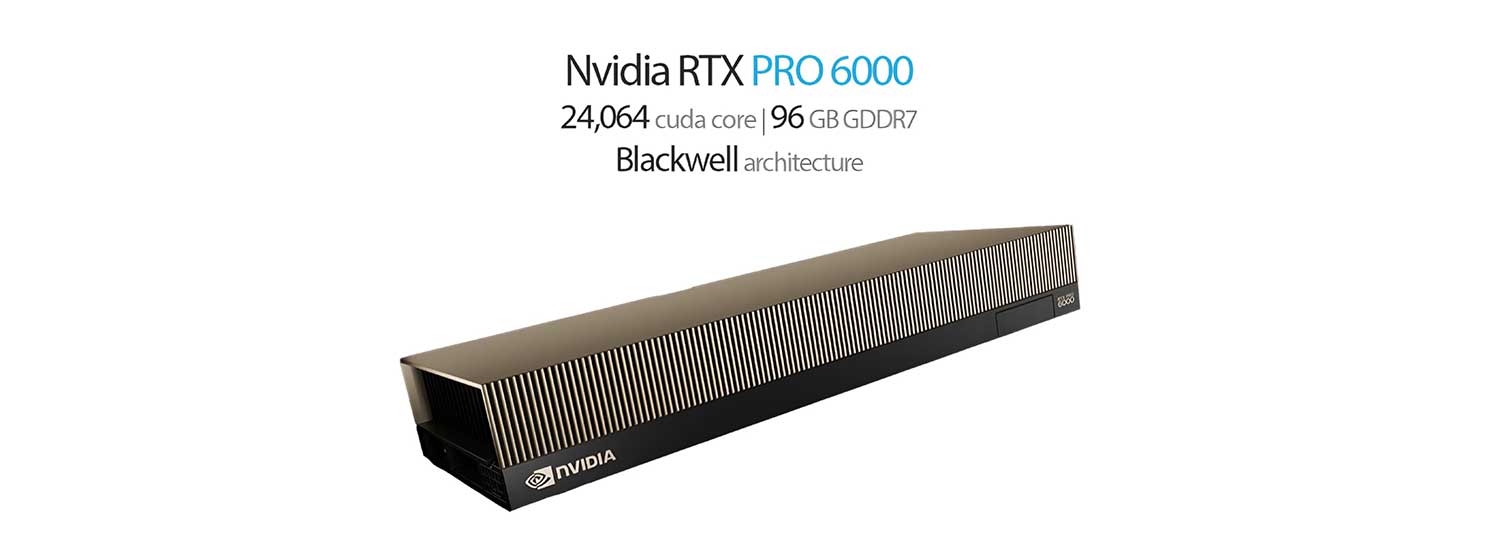
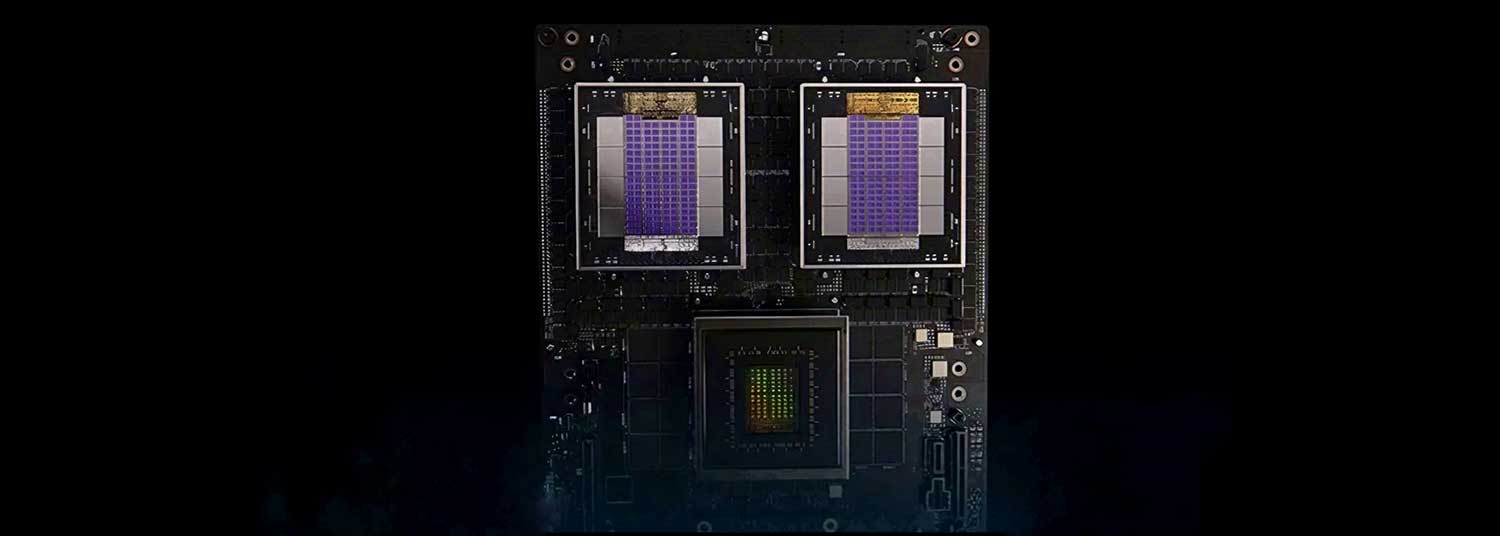
اصلی‌ترین نیاز مدل‌های زبانی بزرگ، توان پردازشی بسیار بالا است. پردازنده‌های مرکزی معمولی برای آموزش یا حتی اجرای یک LLM با صدها میلیارد پارامتر کافی نیستند. به همین دلیل، استفاده از واحدهای پردازش گرافیکی پیشرفته به یک استاندارد تبدیل شده است. شرکت انویدیا با تولید محصولاتی مانند سری A100 و H100، توانسته است نیاز صنعت LLM را تا حد زیادی تأمین کند. این پردازنده‌های گرافیکی دارای هزاران هسته محاسباتی هستند که می‌توانند عملیات ضرب ماتریسی را که بخش عمده محاسبات شبکه‌های عصبی در یک LLM است، با سرعت بسیار بالا انجام دهند. در مقاله مقایسه کارت گرافیک A100 , H100 , RTX 6000 PRO Blackwell  به بررسی این پردازنده های گرافیکی پرداختیم.

علاوه بر پردازنده‌های گرافیکی، حافظه با پهنای باند بالا نیز یکی دیگر از اجزای حیاتی برای اجرای LLM محسوب می‌شود. مدل‌های زبانی بزرگ باید به صورت کامل یا بخشی از آن در حافظه جانبی پردازنده‌ها قرار گیرد تا عملیات استنتاج یا آموزش به صورت پیوسته انجام شود. برای مثال، یک LLM با ۱۷۵ میلیارد پارامتر به چندین ترابایت حافظه نیاز دارد. بنابراین، استفاده از حافظه‌های اچ‌بی‌ام یا حافظه‌های با پهنای باند بسیار بالا و همچنین چیدمان بهینه حافظه در میان چندین پردازنده گرافیکی برای بهینه‌سازی کارایی LLM ضروری است.

در سطح بالاتر، سیستم‌های توزیع شده که متشکل از صدها یا هزاران پردازنده گرافیکی هستند، برای آموزش LLMهایی مانند جی‌پی‌تی-۴ یا لاما استفاده می‌شوند. این خوشه‌های محاسباتی باید از طریق شبکه‌های پرسرعت مانند اینفینی‌باند به یکدیگر متصل شوند تا تأخیر در انتقال داده‌ها برای همگام‌سازی اجزای مختلف مدل زبانی بزرگ به حداقل برسد. بدون چنین اتصالات پرسرعتی، همگام‌سازی میان پردازنده‌ها به یک گلوگاه بزرگ تبدیل خواهد شد و کارایی سیستم LLM به شدت کاهش می‌یابد.

سیستم‌های ذخیره‌سازی و مدیریت داده برای LLM

دومین جزء مهم در معماری یک LLM، سیستم ذخیره‌سازی داده است. مدل‌های زبانی بزرگ بر روی حجم عظیمی از داده‌های متنی آموزش داده می‌شوند. این داده‌ها معمولا شامل کتاب‌ها، مقالات وب، کدهای برنامه‌نویسی و محتوای علمی هستند که جمعا به چندین ده ترابایت می‌رسند. دسترسی سریع و قابل اعتماد به این داده‌ها در طول فرآیند آموزش یک LLM اهمیت بالایی دارد. سیستم‌های ذخیره‌سازی توزیع شده مانند اچ‌دی‌اف‌اس یا سیستم‌های مدرن مبتنی بر آبجکت استوریج، امکان خواندن همزمان داده توسط صدها پردازنده را برای تغذیه مدل زبانی بزرگ فراهم می‌کنند.

علاوه بر ذخیره‌سازی خام داده، نیاز به سیستم‌های مدیریت داده برای پیش‌پردازش و پاکسازی متن‌های مورد استفاده در LLM وجود دارد. داده‌های متنی خام معمولا دارای نویز، کاراکترهای تکراری، اطلاعات تکراری یا محتوای نامرتبط هستند. سیستم‌های مناسب برای آموزش یک LLM باید شامل ابزارهایی برای توکن‌سازی، نرمال‌سازی، حذف داده‌های بی‌کیفیت و ایجاد بسته‌های داده با طول یکسان باشند. برای این منظور، پلتفرم‌هایی مانند اسپارک یا سیستم‌های پردازش داده موازی کاربرد فراوان دارند و به کارآمدی مدل‌های زبانی بزرگ کمک می‌کنند.

همچنین در مرحله اجرا و ارائه خدمات توسط یک LLM، ذخیره‌سازی کش برای پاسخ‌های مکرر یا محاسبات میانی اهمیت پیدا می‌کند. بسیاری از سوالات کاربران از یک مدل زبانی بزرگ تکراری هستند. اگر پاسخ هر سوال برای مدت معینی در حافظه کش ذخیره شود، می‌توان از محاسبات مجدد توسط LLM جلوگیری کرد و هزینه و زمان پاسخگویی را کاهش داد. بنابراین، سیستم‌های کش توزیع شده مانند ردیس معمولا در معماری خدماتی مدل‌های زبانی بزرگ گنجانده می‌شوند.

سیستم‌های نرم‌افزاری و فریم‌ورک‌های مخصوص LLM

برای استفاده کارآمد از سخت‌افزارهای قدرتمند در راستای اجرای یک LLM، به فریم‌ورک‌های نرم‌افزاری تخصصی نیاز است. در حال حاضر، فریم‌ورک‌هایی مانند پایتورچ و تنسورفلو دو ابزار اصلی برای توسعه و آموزش مدل‌های زبانی بزرگ هستند.

LLM

این فریم‌ ورک‌ها قابلیت‌هایی مانند محاسبات خودکار گرادیان، مدیریت حافظه، و پشتیبانی از موازی‌سازی را ارائه می‌دهند. بدون این ابزارها، پیاده‌سازی دستوری الگوریتم‌های بهینه‌سازی برای یک LLM تقریبا غیرممکن خواهد بود.

فراتر از فریم‌ورک‌های پایه، کتابخانه‌ها و ابزارهای خاصی برای مدل‌های زبانی بزرگ توسعه یافته‌اند. برای مثال، کتابخانه «دیکپ‌اسپید» از شرکت مایکروسافت، روش‌های موازی‌سازی پیشرفته‌ای مانند موازی‌سازی داده، موازی‌سازی لوله‌ای و موازی‌سازی تانسور را برای آموزش LLM ارائه می‌دهد. همچنین کتابخانه «ترنسفورمرز» از هاگینگ‌فیس، دسترسی به مدل‌های زبانی بزرگ از پیش آموزش دیده و ابزارهای ارزیابی را ساده کرده است. این کتابخانه‌ها شامل توابعی برای بارگذاری یک LLM، توکن‌سازی متن و تولید متن با تنظیمات مختلف هستند.

یک سیستم نرم‌افزاری مناسب برای مدل زبانی بزرگ باید شامل ماژول پایش و ثبت وقایع نیز باشد. آموزش یک LLM ممکن است هفته‌ها یا ماه‌ها طول بکشد. در این مدت، احتمال بروز خطاهای سخت‌افزاری یا نرم‌افزاری وجود دارد. سیستم‌های پایش پیشرفته می‌توانند دمای پردازنده‌ها، مصرف حافظه، نرخ استفاده از واحد محاسباتی و همچنین معیارهای آموزشی LLM مانند میزان خطا و دقت را در زمان واقعی نمایش دهند. در صورت بروز مشکل، این سیستم‌ها قادر به ذخیره وضعیت فعلی آموزش مدل زبانی بزرگ و بازیابی از نقاط بازبینی هستند.

سیستم‌های استنتاج و بهینه‌سازی برای کاربردی شدن LLM

پس از آموزش یک مدل زبانی بزرگ، مرحله مهم بعدی، استنتاج یا استفاده عملی از LLM است. در این مرحله، سیستم باید بتواند به درخواست‌های کاربران در زمان کوتاه پاسخ دهد. تفاوت اصلی میان مرحله آموزش و استنتاج در این است که در استنتاج، تأخیر بسیار حیاتی و توان عملیاتی بالا برای پاسخگویی LLM اهمیت دارد. برای این منظور، تکنیک‌های بهینه‌سازی مختلفی به کار می‌روند.

LLM

یکی از مهمترین روش‌های بهینه‌سازی برای استنتاج یک LLM، استفاده از کمینه‌سازی اعداد با دقت کمتر است. به جای ذخیره پارامترهای مدل زبانی بزرگ با دقت ممیز شناور ۳۲ بیتی، می‌توان آن‌ها را با دقت ۱۶ بیتی یا حتی ۸ و ۴ بیتی ذخیره کرد. این کار باعث کاهش چشمگیر حافظه مورد نیاز و افزایش سرعت محاسبات LLM می‌شود، هرچند که ممکن است دقت مدل را اندکی کاهش دهد. روش دیگر، تقطیر مدل زبانی بزرگ است که در آن یک مدل کوچک‌تر را آموزش می‌دهیم تا خروجی‌های LLM بزرگ را تقلید کند.

همچنین سیستم‌های استنتاج برای مدل‌های زبانی بزرگ معمولا از مکانیزم‌های کش برداری استفاده می‌کنند. در بسیاری از کاربردهای مبتنی بر LLM مانند سیستم‌های پرسش و پاسخ یا دستیارهای مجازی، درخواست‌های مشابه بارها تکرار می‌شوند. با ذخیره بردارهای نمایش متن در یک پایگاه داده برداری، می‌توان به جای اجرای کامل مدل زبانی بزرگ، پاسخ‌های مشابه را بازیابی کرد. این روش به خصوص برای LLMهای تولید افزایشیافته با بازیابی بسیار مؤثر است.

سیستم‌های امنیتی و حریم خصوصی برای LLM

بدون شک، پیاده‌سازی مدل‌های زبانی بزرگ در محیط‌های واقعی مستلزم رعایت اصول امنیتی و حریم خصوصی است. بسیاری از کاربردهای تجاری LLM شامل داده‌های حساس کاربران مانند اطلاعات پزشکی، مالی یا محرمانه سازمانی هستند. بنابراین، سیستم‌های مناسب برای مدل زبانی بزرگ باید قابلیت اجرای مدل به صورت محلی را داشته باشند. در این مدل استقرار محلی، داده‌های کاربران از سیستم LLM خارج نمی‌شوند و کنترل کامل در اختیار مالک داده است.

علاوه بر استقرار محلی LLM، استفاده از روش‌های رمزنگاری پیشرفته مانند محاسبات چندجانبه ایمن یا رمزنگاری همومورفیک در حال توسعه است. این روش‌ها امکان محاسبه بر روی داده‌های رمز شده توسط یک مدل زبانی بزرگ بدون نیاز به رمزگشایی را فراهم می‌کنند. البته در حال حاضر این روش‌ها بسیار کند هستند و برای LLMهای بزرگ به بلوغ کامل نرسیده‌اند. اما به عنوان یک سیستم مناسب برای حفاظت از مدل‌های زبانی بزرگ در آینده نقش مهمی ایفا خواهند کرد.

همچنین سیستم‌های ثبت و پایش درخواست‌ها از نظر امنیتی برای LLM ضروری هستند. ثبت اطلاعاتی مانند کاربر درخواست‌کننده، زمان درخواست، نوع پرسش و پاسخ تولید شده توسط مدل زبانی بزرگ، به تشخیص حملات مخرب یا نشت اطلاعات کمک می‌کند. یک سیستم مناسب برای LLM باید توانایی تشخیص الگوهای غیرعادی مانند درخواست‌های مکرر برای استخراج داده‌های آموزش یا تلاش برای شکستن محدودیت‌های محتوایی مدل زبانی بزرگ را داشته باشد.

نتیجه‌گیری

LLMها به ترکیبی هماهنگ از سخت‌افزارهای قدرتمند مانند پردازنده‌های گرافیکی پیشرفته، سیستم‌های ذخیره‌سازی توزیع شده با دسترسی سریع به داده، فریم‌ورک‌های نرم‌افزاری به ینه‌سازی شده، روش‌های استنتاج با تأخیر کم و همچنین سازوکارهای امنیتی مناسب نیاز دارند. هیچ کدام از این اجزا به تنهایی برای اجرای یک مدل زبانی بزرگ کافی نیستند و یک سیستم کارآمد باید تمامی این لایه‌ها را به صورت یکپارچه پوشش دهد.

با توجه به سرعت پیشرفت فناوری LLM، انتظار می‌رود سیستم‌های مناسب برای مدل‌های زبانی بزرگ نیز به سرعت تکامل یابند. کاهش هزینه‌های محاسباتی، افزایش کارایی انرژی، بهبود روش‌های فشرده‌سازی LLM و توسعه سخت‌افزارهای اختصاصی برای محاسبات عصبی مرتبط با مدل‌های زبانی بزرگ، از جمله روندهایی هستند که آینده این حوزه را شکل خواهند داد. درک صحیح این سیستم‌ها برای پژوهشگران، مهندسان و مدیرانی که قصد بهره‌گیری از توان LLMها را دارند، امری ضروری و اجتناب‌ناپذیر است.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell برای کاربردهای هوش مصنوعی

انتخاب پردازنده گرافیکی مناسب برای پروژه‌های هوش مصنوعی، به ویژه در حوزه مدل‌های زبانی بزرگ، تصمیمی سرنوشت‌ساز و پیچیده است. هر یک از سه کارت گرافیک مورد بررسی، اگرچه محصولی از انویدیا هستند، اما برای کاربردها و بودجه‌بندی متفاوتی طراحی شده‌اند.

انویدیا A100 به عنوان استاندارد طلایی سابق،H100 به عنوان راهکار غالب مراکز داده در سال‌های اخیر و RTX 6000 PRO Blackwell به عنوان تازه‌واردی با معماری به روز و حافظه بالا، گزینه‌های پیش روی مهندسان و پژوهشگران هستند.

مشخصات فنی و معماری

برای درک تفاوت عملکرد، ابتدا باید به تفاوت‌های بنیادین در معماری و مشخصات فنی این سه محصول نگاه کرد. هر یک از این کارت‌گرافیک‌ها بر پایه یک معماری خاص طراحی شده و ویژگی‌های منحصر به فردی را ارائه می‌دهد.

۱. کارت گرافیک A100 با معماری آمپر

معماری آمپر انقلابی در محاسبات هوش مصنوعی ایجاد کرد. این کارت‌گرافیک از نسل سوم هسته‌های تانسور بهره می‌برد و قابلیت‌هایی مانند تی‌اف۳۲ و اسپارسیتی را معرفی نمود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

رایج‌ترین نسخه کارت گرافیک A100، مدل ۸۰ گیگابایتی با حافظه نوع اچ‌بی‌ام۲ئی و پهنای باند ۲ ترابایت بر ثانیه است. فرم فاکتور این محصول از نوع اس‌اکس‌ام بوده و برای نصب در مراکز داده تخصصی طراحی شده است. این کارت همچنین از فناوری ام‌آی‌جی پشتیبانی می‌کند که به کاربران اجازه می‌دهد یک کارت گرافیک را به چندین بخش مجزا و ایمن تقسیم نمایند.

۲. کارت‌گرافیک‌ H100 با معماری هاپر

معماری هاپر پیشرفتی قابل توجه نسبت به نسل قبل است. کارت‌گرافیک‌ H100 از نسل چهارم هسته‌های تانسور و نوع داده اف‌پی۸ پشتیبانی می‌کند که عملاً توان محاسباتی را برای این نوع داده نسبت به ای۱۰۰ دوچندان می‌نماید.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مدل اس‌اکس‌ام این محصول دارای ۸۰ گیگابایت حافظه نوع اچ‌بی‌ام۳ با پهنای باند ۳.۳۵ ترابایت بر ثانیه است که از ای۱۰۰ سریع‌تر می‌باشد. فرم فاکتور این محصول نیز از نوع اس‌اکس‌ام بوده و به سیستم‌های خنک‌کننده پیشرفته نیاز دارد. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول به ۹۸۹ ترافلاپس می‌رسد که رقمی بسیار چشمگیر است.

۳. انویدیا RTX 6000 PRO Blackwell با معماری بلک‌ول

جدیدترین محصول این خانواده یعنی کارت گرافیک RTX 6000 PRO Blackwell بر پایه معماری بلک‌ول ساخته شده است. تفاوت کلیدی این محصول در نوع حافظه آن است. بر خلاف دو مدل قبلی که از حافظه اچ‌بی‌ام استفاده می‌کردند، آرتی‌ایکس ۶۰۰۰ پرو از ۹۶ گیگابایت حافظه نوع جی‌دی‌دی‌آر۷ با پهنای باند ۱.۷۹۲ ترابایت بر ثانیه بهره می‌برد.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

فرم فاکتور این محصول از نوع پی‌سی‌آی‌اکسپرس است که امکان نصب آن را در ایستگاه‌های کاری معمولی و سیستم های هوش مصنوعی معمولی را فراهم می‌کند. این محصول از نسل پنجم هسته‌های تانسور و نوع داده اف‌پی۴ پشتیبانی می‌کند که پیشرفته‌ترین فناوری روز برای شتاب‌دهی به استنتاج مدل‌های عظیم محسوب می‌شود. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول حدود ۱۲۶ ترافلاپس است که در مقایسه با اچ‌۱۰۰ پایین‌تر به نظر می‌رسد، اما این کاهش توان با بهره‌وری انرژی بالاتر و حافظه بیشتر جبران شده است.

 تحلیل مقایسه‌ای مشخصات کلیدی

از نظر معماری، کارت گرافیک A100 متعلق به نسل آمپر، کارت‌گرافیک‌ H100 متعلق به نسل هاپر و کارت گرافیک RTX 6000 PRO Blackwell متعلق به جدیدترین نسل یعنی بلک‌ول است. هر نسل جدید بهبودهای قابل توجهی در بهره‌وری انرژی و توان محاسباتی به همراه داشته است.

از نظر مقدار حافظه، کارت گرافیک A100 و کارت‌گرافیک‌ H100 هر دو ۸۰ گیگابایت حافظه در اختیار کاربر قرار می‌دهند، در حالی که کارت گرافیک RTX 6000 PRO Blackwell با ۹۶ گیگابایت حافظه، برتری محسوسی در این زمینه دارد. این ۱۶ گیگابایت اضافی می‌تواند تفاوت زیادی در اجرای مدل‌های بسیار بزرگ ایجاد کند.

از نظر نوع حافظه، کارت گرافیک A100 از نوع اچ‌بی‌ام۲ئی، کارت‌گرافیک‌ H100 از نوع اچ‌بی‌ام۳ و کارت گرافیک RTX 6000 PRO Blackwell از نوع جی‌دی‌دی‌آر۷ استفاده می‌کند. حافظه اچ‌بی‌ام پهنای باند بالاتری دارد اما گران‌تر است، در حالی که جی‌دی‌دی‌آر۷ اگرچه پهنای باند کمتری ارائه می‌دهد، اما مقرون به صرفه‌تر و در دسترس‌تر است.

از نظر پهنای باند حافظه، کارت گرافیک A100 با ۲ ترابایت بر ثانیه، اچ‌۱۰۰ با ۳.۳۵ ترابایت بر ثانیه و کارت گرافیک RTX 6000 PRO Blackwell با ۱.۷۹۲ ترابایت بر ثانیه عمل می‌کند. اچ‌۱۰۰ در این شاخص به وضوح برتر است و برای بارهای کاری حساس به پهنای باند مانند آموزش مدل‌های بزرگ، بهترین انتخاب محسوب می‌شود.

از نظر قیمت تقریبی، کارت‌گرافیک‌ H100 گران‌ترین گزینه است و قیمت آن در بازار آزاد به چند ده هزار دلار می‌رسد. کارت گرافیک A100 قیمت متوسطی دارد و در بازار دست دوم با قیمت‌های معقول‌تری یافت می‌شود. کارت گرافیک RTX 6000 PRO Blackwell از نظر قیمت خرید، گزینه‌ای بین این دو محسوب می‌شود و نسبت به کارت‌گرافیک‌ H100 مقرون به صرفه‌تر است.

تحلیل عملکرد برای هوش مصنوعی

عملکرد این کارت‌ها بسته به نوع بار کاری، یعنی آموزش یا استنتاج و همچنین اندازه مدل، تفاوت چشمگیری دارد.

۱. عملکرد در مرحله آموزش مدل

در حوزه آموزش مدل‌های بزرگ، همواره پهنای باند حافظه و توان محاسباتی خام حرف اول را می‌زند. کارت‌گرافیک‌ H100 در این بخش برتری مطلق دارد. پهنای باند بالای اچ‌بی‌ام۳ و توان محاسباتی عظیم اف‌پی۸ آن باعث می‌شود آموزش مدل‌هایی مانند جی‌پی‌تی-۳ تا ۴ برابر سریع‌تر از ای۱۰۰ انجام شود. برای یک تیم تحقیقاتی که قصد آموزش یک مدل بزرگ از ابتدا را دارد، کارت‌گرافیک‌ H100 می‌تواند هفته‌ها زمان را صرفه‌جویی کند.

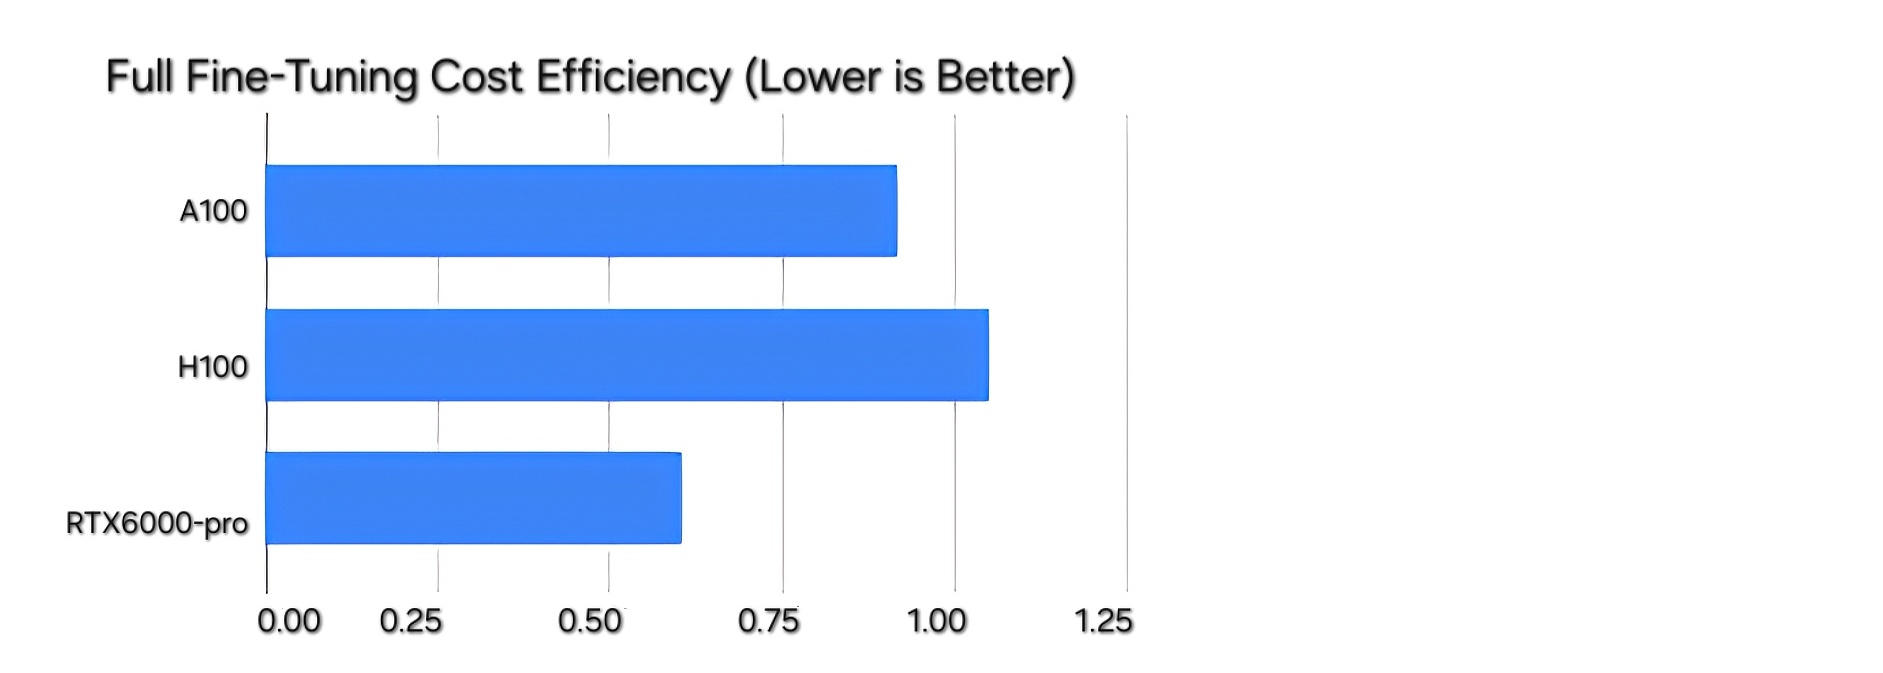
ای۱۰۰ اگرچه سرعتی معادل یک‌چهارم اچ‌۱۰۰ در برخی بارها دارد، اما به دلیل بلوغ نرم‌افزاری و هزینه کمتر، گزینه‌ای مقرون به صرفه برای تیم‌های متوسط محسوب می‌شود. طبق بنچمارک‌های معتبر، هزینه اجرای یک دوره آموزشی روی ای۱۰۰ تقریباً نصف اچ‌۱۰۰ تمام می‌شود، چراکه اچ‌۱۰۰ برای مدل‌های کوچک به طور کامل اشباع نمی‌گردد.

اما جایگاه کارت گرافیک RTX 6000 PRO Blackwell در این بخش چیست؟ این کارت با داشتن حافظه جی‌دی‌دی‌آر۷، پهنای باند کمتری نسبت به اچ‌۱۰۰ دارد. همچنین توان محاسباتی اف‌پی۱۶ آن در مقایسه با اچ‌۱۰۰ بسیار پایین‌تر است. با این حال، یک مزیت بزرگ دارد و آن ۹۶ گیگابایت حافظه است. معماری بلک‌ول در این کارت به گونه‌ای طراحی شده که برای استنتاج بهینه است، نه آموزش حجیم. برای آموزش مدل‌های بسیار بزرگ، اچ‌۱۰۰ همچنان پادشاه بلامنازع باقی می‌ماند.
۲.عملکرد در مرحله استنتاج

بخش جذاب ماجرا به استنتاج مربوط می‌شود، جایی که آرتی‌ایکس ۶۰۰۰ پرو می‌تواند بدرخشد. بزرگترین چالش در استنتاج مدل‌های زبانی بزرگ، ظرفیت حافظه است. برای اجرای یک مدل ۷۰ میلیارد پارامتری در دقت اف‌پی۸، تقریباً به ۷۰ گیگابایت حافظه نیاز خواهد بود.
انویدیا ای۱۰۰ و اچ‌۱۰۰ هر دو ۸۰ گیگابایت حافظه دارند. این مقدار برای اجرای نسخه اف‌پی۸ مدل ۷۰ میلیاردی کافی است، اما فضای بسیار کمی برای حافظه میانی باقی می‌گذارد. این موضوع سرعت را در توالی‌های طولانی کاهش می‌دهد و امکان استفاده از سایز بچ بزرگ را محدود می‌کند.

در سوی دیگر، انویدیا آرتی‌ایکس ۶۰۰۰ پرو با ۹۶ گیگابایت حافظه، فضای تنفس بیشتری دارد. این یعنی می‌تواند همین مدل ۷۰ میلیاردی را با سایز بچ بزرگ‌تر و سرعت بالاتر، بدون نیاز به دو کارت گرافیک و ارتباطات پرسرعت بین آنها اجرا کند. این ویژگی برای استقرار مدل در محیط تولیدی یک مزیت رقابتی بزرگ محسوب می‌شود.

بنچمارک‌های مستقل نشان می‌دهند که این کارت در دقت اف‌پی۸ عملکرد بسیار خوبی دارد و در برخی تست‌ها به ۸,۴۰۰ توکن در ثانیه روی مدل ۳۰ میلیاردی دست یافته است. این رقم تقریباً برابر با عملکرد چهار کارت آرتی‌ایکس ۴۰۹۰ است. اگرچه اچ‌۱۰۰ در حالت تئوری توان محاسباتی اف‌پی۸ بالاتری دارد، اما آرتی‌ایکس ۶۰۰۰ پرو با ارائه حافظه بیشتر، امکان اجرای روان‌تر مدل‌های حجیم را با هزینه سخت‌افزاری کمتر فراهم می‌کند.

علاوه بر این، پشتیبانی از نوع داده اف‌پی۴ در معماری بلک‌ول، یک برگ برنده بزرگ است. استفاده از اف‌پی۴ به طور تئوری توان خروجی را نسبت به اف‌پی۸ دو برابر می‌کند. این قابلیت، آرتی‌ایکس ۶۰۰۰ پرو را به گزینه‌ای ایده‌آل برای اجرای مدل‌های بسیار بزرگ در آینده تبدیل می‌کند، کاری که از اچ‌۱۰۰ یا ای۱۰۰ برنمی‌آید.

 تحلیل هزینه و صرفه اقتصادی

در نگاه اول، قیمت خرید اچ‌۱۰۰ بسیار بالا است و بسیاری از تیم‌ها توانایی تهیه آن را ندارند. اما در محاسبات ابری یا کرایه‌ای، قضیه متفاوت است. نرخ کرایه ساعتی اچ‌۱۰۰ بالاست و حدود ۲ دلار به ازای هر ساعت برای مدل پی‌سی‌آی‌اکسپرس برآورد می‌شود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

در مقابل، آرتی‌ایکس ۶۰۰۰ پرو به دلیل ماهیت ورکاستیشن بودن و عدم نیاز به زیرساخت خنک‌کننده گران‌قیمت مرکز داده، کرایه ساعتی بسیار کمتری دارد. این نرخ به حدود ۰.۷ دلار به ازای هر ساعت می‌رسد. برای اجرای یک ای‌پی‌آی استنتاج، استفاده از آرتی‌ایکس ۶۰۰۰ پرو می‌تواند هزینه به ازای هر یک میلیون توکن را تا یک‌سوم اچ‌۱۰۰ کاهش دهد.

برای مدل‌های ۳۰ میلیاردی، هزینه استنتاج با آرتی‌ایکس ۶۰۰۰ پرو حدود ۰.۰۲ دلار به ازای هر یک میلیون توکن تخمین زده می‌شود. این رقم بسیار رقابتی است و به کسب‌وکارهای کوچک و متوسط اجازه می‌دهد بدون صرف هزینه‌های سرسام‌آور، مدل‌های هوش مصنوعی خود را به صورت زنده ارائه دهند.

نتیجه‌گیری

کدام یک برای هوش مصنوعی بهتر است؟

پاسخ به این سؤال کاملاً به نیاز خاص شما بستگی دارد و هیچ پاسخ یکسانی برای همه وجود ندارد.

اگر شما در حال آموزش یک مدل زبانی بزرگ از صفر هستید یا به حداکثر توان محاسباتی برای کاهش زمان آموزش نیاز دارید، انویدیا اچ‌۱۰۰ بدون شک بهترین انتخاب است. هیچ کارت دیگری در این رده قیمتی توان عملیاتی اف‌پی۸ و پهنای باند معادل اچ‌۱۰۰ را برای محیط‌های صنعتی و تحقیقاتی بزرگ ارائه نمی‌دهد. این کارت برای شرکت‌های بزرگ و مراکز تحقیقاتی پیشرفته طراحی شده است.

اگر هدف شما اجرا و استقرار مدل در محیط تولیدی به صورت مقرون به صرفه است، انویدیا آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول انتخاب هوشمندانه‌تری محسوب می‌شود. حافظه ۹۶ گیگابایتی آن بستری ایده‌آل برای اجرای مدل‌های تا ۷۰ میلیارد پارامتر با دقت مناسب فراهم می‌کند. هزینه عملیاتی پایین‌تر و پشتیبانی از فناوری جدید اف‌پی۴، آن را به سرمایه‌ای مناسب برای چند سال آینده تبدیل می‌کند. این کارت گزینه‌ای عالی برای استارتاپ‌ها و تیم‌هایی است که می‌خواهند مدل خود را با بودجه معقول به صورت زنده اجرا کنند.

اگر بودجه محدودی دارید و به دنبال یک گزینه متعادل برای آموزش و استنتاج مدل‌های نسبتاً بزرگ هستید، انویدیا ای۱۰۰ هنوز هم انتخاب قابل قبولی است. این کارت دیگر گزینه‌ای برای پیشرفته‌ترین پروژه‌ها نیست، اما با توجه به قیمت دست دوم مناسب و پایداری بالای نرم‌افزار، همچنان در بسیاری از مراکز داده به عنوان یک اسب کار قابل اعتماد فعالیت می‌کند.

در یک جمله خلاصه:

برای آموزش، اچ‌۱۰۰ برنده بی‌رقابت است. برای استنتاج با حجم بالا و بودجه بهینه، آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول گزینه‌ای بهتر و آینده‌نگرانه‌تر به شمار می‌رود. انتخاب نهایی به بودجه، نوع پروژه و اولویت‌های شما بستگی دارد.

فناوری NVLink

معرفی فناوری NVLink شرکت انویدیا

در عصر کنونی که حجم داده‌های تولیدشده روزبه‌روز افزایش می‌یابد و مدل‌های هوش مصنوعی به مرزهای تریلیون‌ها پارامتر نزدیک می‌شوند، زیرساخت‌های محاسباتی سنتی با چالش‌های بنیادین مواجه هستند. یکی از حیاتی‌ترین این چالش‌ها، مسئله ارتباط بین پردازنده‌های گرافیکی یا همان GPUها در سامانه‌های چندپردازنده‌ای است.

فنّاوری NVLink که توسط شرکت انویدیا طراحی و توسعه یافته است، پاسخی نوآورانه به این نیاز رو به رشد محسوب می‌شود.

ضرورت پیدایش NVLink

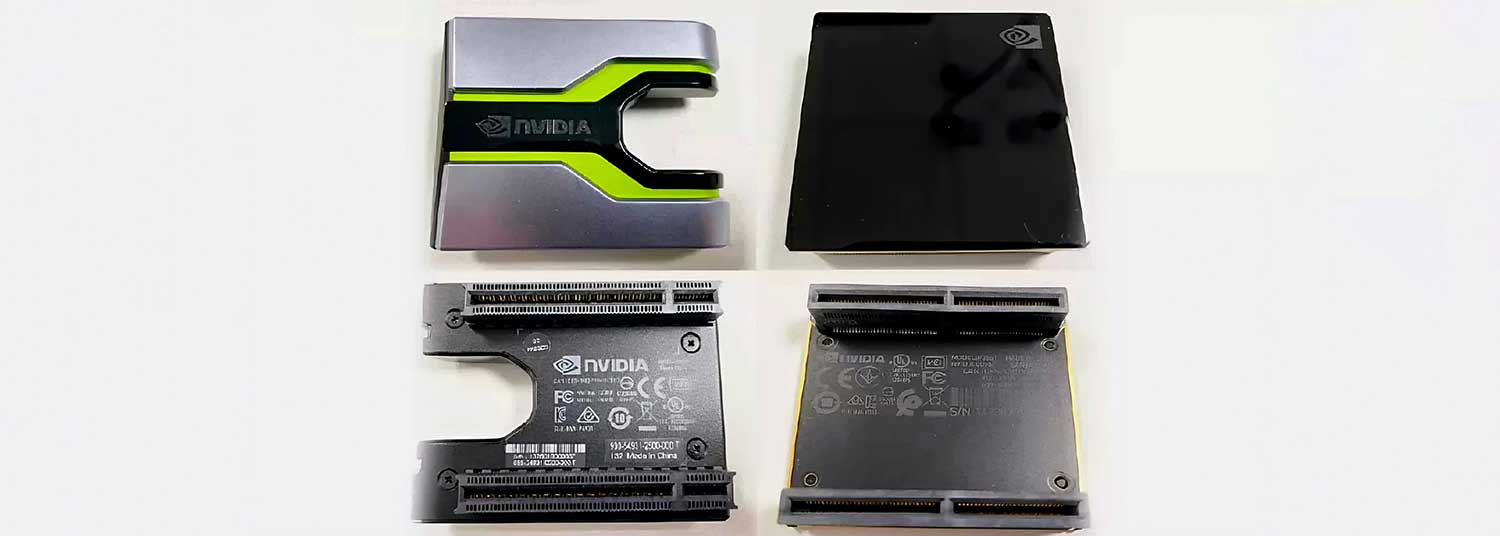
به‌طور سنتی، ارتباط بین GPUها در یک سرور از طریق گذرگاه استاندارد PCI Express یا همان PCIe انجام می‌شده است. این گذرگاه از ابتدای معرفی خود در اوایل دهه ۲۰۰۰، نقش اصلی را در اتصال دستگاه‌های جانبی به پردازنده مرکزی ایفا کرده است. اگرچه نسل‌های مختلف PCIe بهبودهایی در پهنای باند داشته‌اند، اما این گذرگاه به‌عنوان یک گلوگاه اساسی در سامانه‌های سنگین محاسباتی شناخته می‌شود. برای نمونه، گذرگاه PCIe نسل پنجم حداکثر پهنای باند دوطرفه در حدود ۱۲۸ گیگابایت بر ثانیه ارائه می‌دهد. این میزان برای اجرای مدل‌های پیچیده هوش مصنوعی که نیازمند تبادل لحظه‌ای حجم عظیمی از داده میان ده‌ها یا صدها GPU هستند، کافی نیست. یک مدل زبانی بزرگ با یک تریلیون پارامتر، هنگام آموزش، نیاز دارد که هر میلی‌ثانیه، گرادیان‌ها و به‌روزرسانی‌های وزن میان تمام پردازنده‌ها مبادله شود. در چنین شرایطی، پهنای باند محدود PCIe باعث می‌شود تا بخش قابل توجهی از زمان پردازش به جای محاسبه، صرف انتظار برای انتقال داده گردد.

افزون بر محدودیت پهنای باند، معماری مبتنی بر PCIe نیازمند دخالت پردازنده مرکزی یا CPU در فرآیند انتقال داده است. در این معماری، هنگامی که دو GPU می‌خواهند داده‌ای را مبادله کنند، ابتدا داده باید از حافظه GPU مبدأ به حافظه اصلی سیستم منتقل شود، سپس CPU آن را مسیریابی کرده و در نهایت به GPU مقصد برسد. این فرآیند چندمرحله‌ای باعث افزایش تأخیر یا Latency می‌شود و همچنین بار اضافی قابل توجهی بر روی CPU تحمیل می‌کند. در سامانه‌های بزرگ، CPU که خود مسئولیت مدیریت سیستم عامل و برنامه‌ریزی فرآیندها را بر عهده دارد، نمی‌تواند به طور مؤثر از عهده مدیریت حجم عظیم ترافیک داده میان ده‌ها GPU برآید. به همین دلایل، انویدیا تصمیم به خلق یک رابط اختصاصی و کارآمد برای شبکه‌سازی درون‌راکی یا Scale-up گرفت و NVLink را برای نخستین بار در سال ۲۰۱۶ و همزمان با معماری Pascal معرفی کرد.

مفهوم و معماری NVLink

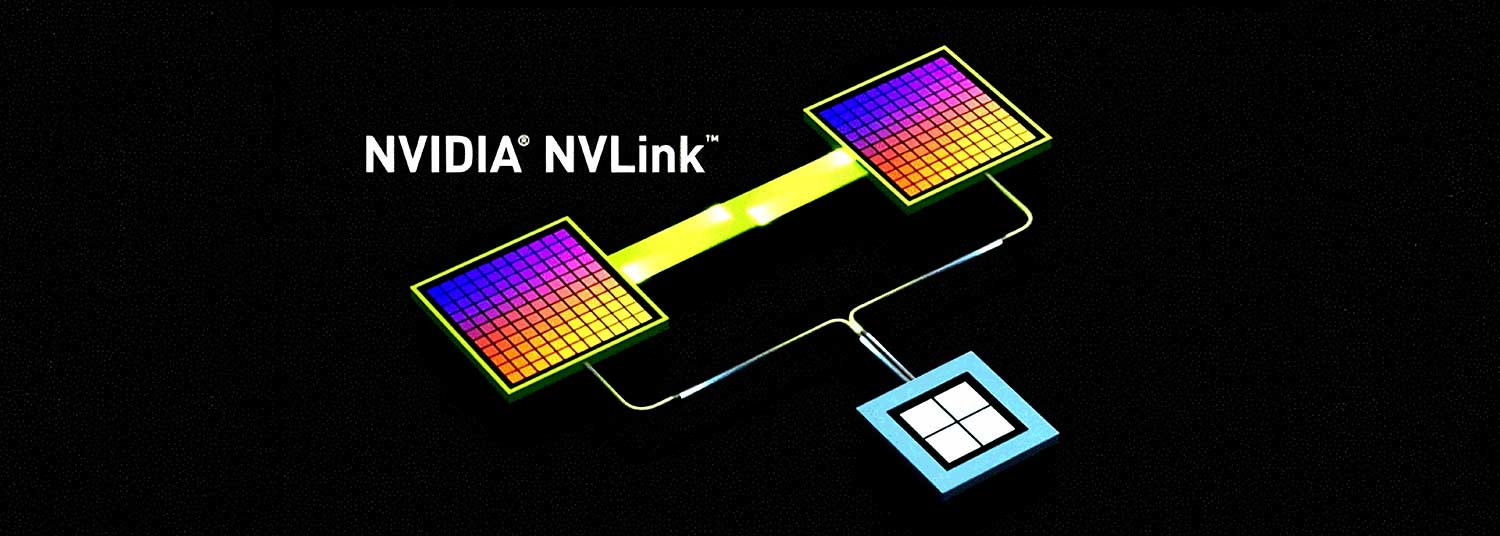
NVLink یک رابط ارتباطی پرسرعت با تأخیر بسیار پایین است که به‌طور خاص برای ارتباط مستقیم GPUها با یکدیگر و همچنین اتصال GPUها به CPUهای سازگار طراحی شده است. کلید واژه در این تعریف، کلمه «مستقیم» است. برخلاف معماری متمرکز PCIe که داده‌ها باید از پل ارتباطی چیپ‌ست و گذرگاه‌های اشتراکی عبور کنند، NVLink امکان برقراری ارتباطی مشبک یا Mesh-style را فراهم می‌آورد. این ارتباط مستقیم، مزیت دوچندان دارد: نخست آنکه پهنای باند قابل‌دسترس برای هر GPU به طور چشمگیری افزایش می‌یابد و هر جفت از GPUها می‌توانند بدون رقابت بر سر منابع مشترک با یکدیگر تبادل داده کنند. دوم آنکه تأخیر ناشی از دخالت CPU و گذر از لایه‌های نرم‌افزاری میانی حذف می‌شود. در عمل، تأخیر ارتباطی در NVLink به کمتر از یک میکروثانیه می‌رسد که در مقایسه با ده‌ها میکروثانیه PCIe، یک پیشرفت انقلابی است.

فناوری NVLink

این فناوری تنها به یک کابل ارتباطی ساده محدود نمی‌شود، بلکه یک مجموعه سخت‌افزاری و نرم‌افزاری کامل است. هسته اصلی این فناوری در سامانه‌های بزرگ، تراشه‌های NVLink Switch هستند. این تراشه‌ها با ایجاد یک شبکه تماماً متصل یا All-to-All میان GPUها، امکان می‌دهند تا هر جفت از GPUها با حداکثر سرعت ممکن با یکدیگر تبادل داده کنند. به عبارت دیگر، در یک سامانه مجهز به NVLink Switch، دیگر خبری از گلوگاه اشتراک‌گذاری پهنای باند میان چندین GPU نیست. هر GPU می‌تواند به طور همزمان با تمام GPUهای دیگر در بالاترین نرخ ممکن ارتباط برقرار کند. این قابلیت برای الگوریتم‌هایی مانند کاهش توزیع‌شده یا All-Reduce که در آموزش مدل‌های عمیق بسیار پرکاربرد هستند، حیاتی است.

تکامل نسل‌ها و پهنای باند

فناوری NVLink از زمان معرفی تاکنون دستخوش تحولات سریعی بوده است. هر نسل از این فناوری تقریباً دو برابر نسل قبل پهنای باند ارائه داده است و انویدیا را قادر ساخته تا همگام با رشد تصاعدی نیازهای محاسباتی حرکت کند.

فناوری NVLink

نسل اول NVLink که در سال ۲۰۱۶ عرضه شد، پهنای باند ۱۶۰ گیگابایت بر ثانیه به ازای هر GPU ارائه می‌داد که در آن زمان، جهشی چشمگیر نسبت به PCIe نسل سوم محسوب می‌شد.

نسل دوم با معماری Volta در سال ۲۰۱۷، این رقم را به ۳۰۰ گیگابایت بر ثانیه رساند. نسل سوم که در معماری Ampere در سال ۲۰۲۰ معرفی شد، پهنای باند ۶۰۰ گیگابایت بر ثانیه را ارائه کرد. در نسل چهارم که با معماری NVIDIA Hopper معرفی شد، پهنای باند هر GPU به ۹۰۰ گیگابایت بر ثانیه رسید.

نسل پنجم که هم‌زمان با معماری NVIDIA Blackwell عرضه شد، این رقم را به یک هزار و هشتصد گیگابایت بر ثانیه یا ۱.۸ ترابایت بر ثانیه افزایش داد. اخیراً نیز نسل ششم این فناوری برای پلتفرم NVIDIA Rubin معرفی شده است که پهنای باند استثنایی سه هزار و ششصد گیگابایت بر ثانیه یا ۳.۶ ترابایت بر ثانیه به ازای هر GPU ارائه می‌کند.

این میزان پهنای باند بیش از چهارده برابر استاندارد PCIe نسل ششم است که حداکثر ۲۵۶ گیگابایت بر ثانیه پهنای باند دوطرفه دارد.

برای درک بهتر این اعداد، باید به توان تجمیع‌شده در یک سامانه کامل توجه کرد. برای نمونه، در سامانه مرجع GB200 NVL72 که از ۷۲ GPU و ۳۶ پردازنده مرکزی Grace استفاده می‌کند، پهنای باند کل تجمیع‌شده به یکصد و سی ترابایت بر ثانیه می‌رسد. این میزان پهنای باند عظیم امکان هماهنگی لحظه‌ای میان همه پردازنده‌ها را در حین اجرای مدل‌های بزرگ هوش مصنوعی فراهم می‌سازد.

مزایای کلیدی و قابلیت‌های نرم‌افزاری

افزایش صرف پهنای باند، تنها مزیت NVLink نیست. این فناوری با ایجاد فضای آدرس حافظه یکپارچه یا Unified Memory Space میان GPUهای متصل، برنامه‌نویسی را برای توسعه‌دهندگان ساده‌تر می‌کند. در این مدل، برنامه‌نویس می‌تواند بدون نگرانی از محل فیزیکی داده، به یک آدرس حافظه واحد در سراسر همه GPUها دسترسی داشته باشد. سخت‌افزار NVLink به طور خودکار ترجمه آدرس و انتقال داده‌ها را در پس‌زمینه انجام می‌دهد. همچنین، مکانیزم‌های توکار برای تحمل خطا و Resiliency در نظر گرفته شده است که امکان تعویض قطعات بدون خاموش کردن سامانه یا Hot-swapping را فراهم می‌کند. در یک مرکز داده بزرگ، قابلیت تعویض یک ماژول معیوب بدون توقف محاسبات روی هزاران GPU دیگر، ارزش اقتصادی عظیمی دارد.

از منظر نرم‌افزاری، انویدیا کتابخانه‌های ارتباطی قدرتمندی مانند NCCL یا NVIDIA Collective Communications Library را ارائه داده است. این کتابخانه‌ها به‌طور خودکار از توپولوژی NVLink برای بهینه‌سازی عملیات جمعی مانند All-Reduce، Broadcast و Scatter-Gather بهره می‌برند. سرویس دیگری به نام IMEX یا Internode Memory Exchange نیز مدیریت حافظه اشتراکی میان گره‌های مختلف را تسهیل می‌کند. این لایه نرم‌افزاری باعث می‌شود تا برنامه‌های کاربردی بدون تغییر در کد اصلی، از مزایای پهنای باند بالای NVLink بهره‌مند شوند. در مجموع، NVLink ترکیبی از سخت‌افزار پیشرفته و نرم‌افزار هوشمند است که شکاف میان قابلیت‌های فیزیکی و کاربردپذیری عملی را پر می‌کند.

NVLink Fusion و چشم‌انداز آینده

انویدیا به تازگی توسعه فناوری جدیدی به نام NVLink Fusion را آغاز کرده است. این فناوری به شرکت‌های بزرگ فعال در حوزه ابری و ابرمقیاس یا Hyperscalerها اجازه می‌دهد تا پردازنده‌های سفارشی خود را نیز به شبکه NVLink متصل کنند.

با استفاده از استانداردهای باز مانند UCIe یا Universal Chiplet Interconnect Express، این شرکت‌ها می‌توانند پردازنده‌های اختصاصی یا XPU خود را طراحی کرده و آن‌ها را با استفاده از تراشه‌های NVLink به GPUهای انویدیا متصل نمایند.

این رویکرد، بسته‌ای بودن اکوسیستم انویدیا را تا حدی کاهش می‌دهد و امکان سفارشی‌سازی برای نیازهای خاص هر مشتری را فراهم می‌کند. در آینده، می‌توان انتظار داشت که NVLink به استانداردی واقعی برای ارتباطات درونی در مراکز داده تبدیل شود، جایگاهی که امروز InfiniBand و Ethernet برای ارتباط بین‌راکی دارند.

نتیجه‌گیری

فناوری NVLink تحولی بنیادین در نحوه ارتباط پردازنده‌های گرافیکی در مراکز داده مدرن ایجاد کرده است. این فناوری با غلبه بر محدودیت‌های ذاتی گذرگاه PCIe از طریق ارائه پهنای باند بسیار بالا، تأخیر فوق‌العاده پایین و ایجاد فضای حافظه یکپارچه، نیازهای شدید محاسباتی برنامه‌های پیشرفته برای سیستم های هوش مصنوعی و شبیه‌سازی‌های علمی را برآورده می‌سازد.

فناوری NVLink

از سامانه‌های کوچک چهار GPU تا اَبَررایانه‌های غول‌پیکر متشکل از هفتاد و دو GPU در یک شاسی، NVLink به عنوان ستون فقرات محاسباتی عمل می‌کند.

با معرفی قابلیت‌هایی مانند NVLink Fusion، این فناوری مسیر خود را به سوی آینده‌ای بازتر و قابل سفارشی‌سازی ادامه می‌دهد و نقش محوری خود را در عصر هوش مصنوعی و محاسبات با عملکرد بالا تثبیت می‌کند. بدون شک، پیشرفت‌های آینده در زمینه هوش مصنوعی، تا حد زیادی مرهون توانایی فنّاوری‌هایی مانند NVLink در هماهنگ‌سازی هزاران پردازنده به صورت یکپارچه و کارآمد خواهد بود.

سرورهای DGX انویدیا

معرفی سرورهای DGX انویدیا

در عصر کنونی، هوش مصنوعی به عنوان نیروی محرکه تحول دیجیتال در صنایع مختلف ظهور یافته است. با این حال، پیاده‌سازی و مقیاس‌پذیری زیرساخت‌های هوش مصنوعی همواره با چالش‌های قابل توجهی از جمله پیچیدگی یکپارچه‌سازی سخت‌افزار و نرم‌افزار، هزینه‌های سنگین مهندسی، و زمان‌بر بودن فرآیند راه‌اندازی همراه بوده است. سرورهای DGX شرکت انویدیا به عنوان راهکاری جامع و یکپارچه برای رفع این موانع طراحی شده‌اند.

پیشرفت‌های سریع در حوزه هوش مصنوعی، به ویژه در زمینه یادگیری عمیق و مدل‌های زبانی بزرگ، تقاضا برای توان محاسباتی بی‌سابقه‌ای را ایجاد کرده است. سازمان‌ها و پژوهشگران برای آموزش مدل‌هایی با میلیاردها پارامتر به زیرساختی نیاز دارند که فراتر از توان سرورهای سنتی باشد.

با این حال، مسیر دستیابی به چنین زیرساختی اغلب با دشواری‌هایی نظیر ناسازگاری اجزای سخت‌افزاری، پیچیدگی پیکربندی نرم‌افزارهای متن‌باز، و هزینه‌های بالای نگهداری همراه است. در این راستا، شرکت انویدیا خانواده سرورهای DGX را به عنوان «مولفه هوش مصنوعی» یا «ماشین هوش مصنوعی» یکپارچه معرفی کرده است.

هدف این دستگاه‌ها، ارائه یک راه حل کلید در دست است که پیچیدگی‌های ساخت و راه‌اندازی زیرساخت سیستم های هوش مصنوعی را از دوش کاربران بردارد .

مفهوم و جایگاه سرورهای DGX

سرورهای DGX که مخفف عبارت «مولفه هوش مصنوعی» هستند، دستگاه‌هایی از پیش پیکربندی شده و بهینه‌سازی شده‌اند که به طور اختصاصی برای اجرای بارهای کاری سنگین هوش مصنوعی و یادگیری ماشین طراحی شده‌اند.

سرورهای DGX انویدیا

برخلاف سرورهای معمولی و سیستم های رندرینگ اسمبل شده که ممکن است ترکیبی از قطعات مختلف تولیدکنندگان گوناگون باشند، سرور DGX به عنوان یک دستگاه یکپارچه یا «مولفه» عرضه می‌شود.

این بدان معناست که شرکت انویدیا تمام اجزا از جمله پردازنده‌های گرافیکی، پردازنده‌های مرکزی، حافظه، ذخیره‌سازی، اتصالات شبکه و مهمتر از همه، پشته نرم‌افزاری را از پیش انتخاب و بهینه‌سازی کرده است . نخستین نسخه از این سرورها با نام DGX-1 در سال ۲۰۱۶ معرفی شد و از آن زمان تاکنون، این خانواده همواره در خط مقدم تحول سخت‌افزاری هوش مصنوعی قرار داشته است .

معماری فنی و اجزای کلیدی سرورهای DGX انویدیا

قلب تپنده سرورهای نسل جدید DGX، از جمله مدل H100 و H200، توسط هشت پردازنده گرافیکی H100 یا H200 شرکت انویدیا تشکیل شده است. مدل H100 دارای ۶۴۰ گیگابایت حافظه مجتمع است، در حالی که مدل H200 این مقدار را به ۱۱۲۸ گیگابایت افزایش می‌دهد .

افزون بر این، دو پردازنده مرکزی Intel Xeon، مجموعاً ۲ ترابایت حافظه سیستم و ۳۰ ترابایت حافظه ذخیره‌سازی NVMe SSD در این سرورها تعبیه شده است .

سرورهای DGX انویدیا

با این حال، آنچه سرورهای DGX را از مجموعه‌ای از قطعات مجزا متمایز می‌کند، فناوری ارتباطی اختصاصی به کار رفته در آن است. هر یک از هشت پردازنده گرافیکی از طریق چهار سوئیچ NVSwitch نسل چهارم و فناوری NVLink به یکدیگر متصل می‌شوند .

این معماری، پهنای باند دوسویه بسیار بالایی به میزان ۹۰۰ گیگابایت بر ثانیه بین هر جفت پردازنده گرافیکی فراهم می‌آورد. چنین سرعت ارتباطی برای آموزش مدل‌های بزرگ که نیازمند تبادل مداوم داده میان پردازنده‌ها هستند، نقشی حیاتی دارد. در غیر این صورت، بخش قابل توجهی از زمان پردازش صرف ارتباطات می‌شود .

در بخش شبکه خارجی نیز این سرورها مجهز به کارت‌های شبکه ConnectX-7 با سرعت ۴۰۰ گیگابیت بر ثانیه هستند که امکان ایجاد خوشه‌های قدرتمند از چندین دستگاه DGX را فراهم می‌آورد .

نرم‌افزار؛ عامل تمایز اصلی

اگرچه سخت‌افزار قدرتمند ستون فقرات این سرورها را تشکیل می‌دهد، اما ارزش واقعی سرورهای DGX در بسته نرم‌افزاری یکپارچه آن‌ها نهفته است. این دستگاه‌ها به صورت پیش‌فرض با مجموعه نرم‌افزاری NVIDIA AI Enterprise عرضه می‌شوند.

این مجموعه شامل کتابخانه‌هایی همچون CUDA و cuDNN، فریمورک‌های بهینه‌سازی شده یادگیری عمیق، و ابزارهای مدیریت کانتینر مانند Docker و Kubernetes است .

این رویکرد «کلید در دست» بدان معناست که سازمان‌ها بلافاصله پس از نصب فیزیکی سرور، بدون نیاز به صرف ماه‌ها زمان برای کامپایل و پیکربندی کتابخانه‌های متن‌باز و رفع تداخلات نرم‌افزاری، قادر به اجرای مدل‌های خود خواهند بود.

همچنین، داشتن قرارداد پشتیبانی از سوی انویدیا، دسترسی به تیمی از متخصصان به نام DGXpert را فراهم می‌آورد که در بهینه‌سازی عملکرد و عیب‌یابی سیستم به کاربران یاری می‌رسانند .

مقیاس‌پذیری از میز کار تا ابررایانه

خانواده DGX تنها به دستگاه‌های مرکز داده محدود نمی‌شود و نیازهای متنوع کاربران را پوشش می‌دهد. برای توسعه‌دهندگان و پژوهشگرانی که به یک ایس تگاه کاری قدرتمند روی میز نیاز دارند، مدل‌هایی مانند DGX Station و DGX Spark (که پیش‌تر با نام DGX Orin شناخته می‌شد) طراحی شده‌اند.

سرورهای DGX انویدیا

این دستگاه‌های رومیزی که از ابرتراشه Grace Blackwell بهره می‌برند، امکان توسعه و آزمایش مدل‌های هوش مصنوعی را در محیط محلی فراهم می‌کنند و سپس قابلیت انتقال آسان آن مدل‌ها به خوشه‌های بزرگ‌تر را دارند .

در سوی دیگر طیف، سرورهای DGX قابلیت تجمیع در معماری‌های بزرگ‌تری به نام SuperPOD را دارند. یک ابرخوشه DGX SuperPOD می‌تواند شامل صدها گره DGX باشد که توسط شبکه‌های پرسرعت InfiniBand به هم متصل شده و به عنوان یک ابررایانه غول‌پیکر عمل می‌کنند.

جالب توجه است که در زمان معرفی، برخی از این ابرخوشه‌ها در فهرست سریع‌ترین ابررایانه‌های جهان قرار گرفته‌اند . جدیدترین نسل این سامانه‌ها از خنک‌کنندگی مایع برای مدیریت حرارت بالای تولید شده توسط تراشه‌های قدرتمند استفاده می‌کنند .

کاربردها و چشم‌انداز آینده

سرورهای DGX در صنایع گوناگونی از جمله داروسازی برای کشف دارو، خودروسازی برای توسعه خودروهای خودران، و خدمات مالی برای تشخیص تقلب مورد استفاده قرار می‌گیرند .

افزون بر استقرار در محل سازمان‌ها، شرکت انویدیا سرویس DGX Cloud را نیز ارائه می‌دهد که به مشتریان اجازه می‌دهد از همین معماری قدرتمند به صورت اجاره‌ای در ابرسرویس‌هایی همچون Microsoft Azure و Oracle Cloud Infrastructure استفاده کنند .

نتیجه‌گیری

سرورهای DGX انویدیا پاسخی کامل به نیاز روزافزون به زیرساخت یکپارچه و کارآمد هوش مصنوعی هستند. این سامانه‌ها با ترکیب پردازنده‌های گرافیکی پیشرفته، معماری ارتباطی با پهنای باند بسیار بالا، حافظه و ذخیره‌سازی سریع، و مهمتر از همه، مجموعه نرم‌افزاری بهینه‌سازی شده، راه حلی کلید در دست ارائه می‌دهند.

این یکپارچگی عمیق، زمان لازم برای راه‌اندازی و آموزش مدل‌های هوش مصنوعی را از چند ماه به چند روز کاهش می‌دهد. با ظهور نسل‌های جدید مانند سکوی Grace Blackwell و افزایش قابلیت مقیاس‌پذیری تا سطح ابررایانه‌های عظیم، خانواده DGX همچنان به عنوان معیاری برای کارایی و قابلیت اطمینان در عصر کارخانه‌های هوش مصنوعی باقی خواهند ماند.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

در سال 2025 که هوش مصنوعی حتی دنیای پردازنده ها رو هم تحت تاثیر خودش قرار داده شرکت های محبوبی مثل AMD و Intel بیکار نمونده و با عرضه ی بهترین پردازنده ها با پشتیبانی از هوش مصنوعی به کاربر کمک میکنن تا بتونه مدل ها و پروژه های AI رو با سرعت و قدرت بالا اجرا کنه.

مثلا اینتل با معرفی Core i7 و Core i9 تجربه ای روان و سریع به کاربران هوش مصنوعی دسکتاپ و لپتاپ ها میده و واسه ی سرورها و دیتاسنتر هم Xeon Scalable رو ارائه کرده.

تازه به فکر دستگاه های کوچک هم بوده تا بدون مصرف بالای انرژی بتونن برای اجرای پروژه های هوش مصنوعی از سری Atom استفاده کنند. در کنار اینتل رقیب همیشگیش یعنی ای ام دی هم دست به کار شده و پردازنده هایی مثل  Ryzen 7 7700X، Ryzen 9 7950X، Threadripper PRO 7995WX و EPYC 9654 رو عرضه کرده.

حتی شتاب دهنده هایی مثل Habana Gaudi 2 هم واسه دیتاسنترها و اجرای بدون مشکل کارهای Ai عرضه شده اند که خوبه با ویژگی، قابلیتها و حتی معایبشون آشنا بشی و واسه همین هم ازت میخوام تا آخر این مقاله از دیجی بینو همراهم باشی 😍.

بهترین سی پی یو برای هوش مصنوعی

در ادامه بهترین و قویترین پردازنده های هوش مصنوعی از شرکت های ای ام دی و اینتل برای سیستم های مخصوص هوش مصنوعی و سیستم های رندرینگ رو بهت معرفی کردم، پس بزن بریم… ✌

AMD Ryzen 7 7700X: پردازنده مقرون به صرفه

اگه با بودجه ی محدود دنبال یه پردازنده واسه اجرای پروژه های هوش مصنوعی هستی بهت ای ام دی مدل Ryzen 7 7700X رو پیشنهاد میکنم، این قطعه با 8 هسته و 16 رشته، توان پردازشی بالایی داره.

اگه بخوام از مشخصات این پردازنده بیشتر واست توضیح بدم باید بدونی که فرکانس پایه آن 4.5 گیگاهرتز هستش و در حالت بوست به 5.4 گیگاهرتز هم میرسه.

AMD Ryzen 7 7700X مجهز به حافظه ی DDR5 بوده و با پشتیبانی از رم 128 گیگابایتی و واحد گرافیکی AMD Radeon Graphics عملکرد قابل قبولی در پروژه های هوش مصنوعی داره و دیگه نیازی به خرید کارت گرافیک مجزا نیست.

راستی توان مصرفی این پردازنده 105 بوده که در مقایسه با سریهای قبل عدد قابل توجهی است و تازه واسه گیمینگ 🎮 و تولید محتوا هم انتخاب خوبیه.

 AMD Ryzen Threadripper PRO 7995WX: غول پردازشهای سنگین

اگه دنبال پردازنده ای با قدرت بسیار بالا هستی بهت Ryzen Threadripper PRO 7995WX از ای ام دی رو پیشنهاد میکنم، ببین همونطور که بهت گفتم با یه پردازنده ی قوی طرفی که ازش در مراکز داده، تیم های تحقیقاتی و ایستگاه های کاری پیشرفته استفاده میشه.

این پردازنده با معماری Zen 4 و به صورت 96 هسته و 192 رشته ای طراحی شده و واسه پردازش های سنگین، پروژه های هوش مصنوعی، رندرینگ و… مناسبه.

البته باید بدونی که قیمت این پردازنده با توجه به کارایی آن کمی گرونه 💰.

این cpu با داشتن هسته های زیاد و توان پردازش عالی بهترین گزینه برای پردازشهای سنگین و مدلهای هوش مصنوعی متوسط تا سنگین است.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

AMD Ryzen 9 7950X: ایده آل برای AI و گیمینگ

و اما یکی دیگه از پردازنده های قدرتمند باز هم از شرکت ای ام دی از سری 7000 با نام AMD Ryzen 9 7950X است که مجهز به 16 هسته و 32 رشته بوده و بهترین انتخاب برای پروژه های هوش مصنوعی به حساب میاد، این قطعه کش بالایی داشته و عملکرد قوی چند رشته ای آن باعث عملکرد روان و راحت میشه.

از ویژگیهای دیگه ی AMD RYZEN 9 7950X میتونم به لیتوگرافی 5 نانومتری، فرکانس پایه 4.5 گیگاهرتز و فرکانس بوست 5.7 گیگاهرتزی اشاره کنم.

پردازنده ی Ryzen 9 7950X مجهز به واحد NPU داخلی بوده و میتونه پروژه های AI سبک تا متوسط رو اجرا کنه.

این قطعه برای گیمینگ و تولید محتوا هم انتخاب خوبیه.

AMD EPYC 9654 : مناسب پروژه های بزرگ هوش مصنوعی!

به طور کلی پردازنده های سری EPYC واسه پروژه های بزرگ و استفاده در سرورها و دیتاسنترها طراحی شدند و EPYC 9654 ای ام دی هم دارای 96 هسته و 192 رشته پردازشی است؛ این قطعه با فناوری ساخت 5 نانومتری بهترین انتخاب برای تیم ها و شرکت هایی است که میخوان پروژه های هوش مصنوعی رو با حجم داده های خیلی زیاد اجرا کنند.

اگه بخوام از مزیتهای این پردازنده بهت بگم میتونم به قدرت بالا در اجرای برنامه های سنگین و پیچیده، کش بالا، پردازش حجم بالا و مصرف بهینه ی انرژی اشاره کنم.

Intel Core i7 و i9: سبک و سریع

نسلهای جدید پردازنده های Core i7  و i9 به دلیل اینکه مجهز به واحد پردازش عصبی هستند میتونن پروژه های هوش مصنوعی سبک تا متوسط رو اجرا کنند.

در واقع این نسل از پردازنده های اینتل مجهز به NPU داخلی بوده و توان پردازش AI رو دارند و ویژگی هایی مثل مصرف انرژی کم، سازگاری خوب با نرم افزارهای مختلف آنها رو به بهترین پردازنده با پشتیبانی از هوش مصنوعی از شرکت اینتل تبدیل کرده است.

این CPU ها واسه کاربران دسکتاپ و لپتاپ که نمیخواهند مدلهای سنگین رو اجرا کنند انتخاب خوبی خواهد بود اما همونطور که بهت گفتم این سخت افزارها امکان پردازش های خیلی سنگین AI رو ندارند.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

نسل Sapphire Rapids: قدرت بالای AI برای سرورها

پردازنده ی بعدی که میخوام بهت معرفی کنم به عنوان پردازنده های سروری و مخصوص دیتا سنترها طراحی شده اند که یکسری از مدل ها مثل Intel Xeon Scalable برای پردازش های هوش مصنوعی بهینه شده و قادر به انجام پردازش های سنگین هستند.

پشتیبانی از نرم افزارهای سروری و قدرت پردازش بالا در داده ها رو میشه به عنوان اصلی ترین مزیت این قطعه نام برد اما باید بدونی که این پردازنده قیمت و مصرف انرژی بالایی داره.

Intel Atom: کم مصرف

یکی دیگه از CPU هایی که از هوش مصنوعی پشتیبانی میکنه و باز هم از شرکت اینتل است پردازنده های Atom بوده که مصرف انرژی پایینی دارند و مناسب پردازشهای هوش مصنوعی سبک هستند.

پس اگه دنبال یک پردازنده واسه اجرای پروژه های AI سبک واسه دستگاه های کم مصرف هستی پردازنده های  Atom انتخاب خوبی خواهند بود.

Habana Gaudi 2: پردازش سریع هوش مصنوعی

ببین Habana Gaudi 2 توسط زیر مجموعه ی اینتل طراحی و عرضه شده و میشه بهش گفت یک شتاب دهنده AI که میتونه در اجرای مدل های هوش مصنوعی بهت کمک کنه.

این قطعه توان پردازشی بالایی برای هوش مصنوعی داره اما مصرف بالای انرژی رو میشه یکی از معایب آن دانست.

AMD Ryzen AI 9 9950X (سری 9000): اجرای روان با قدرت بالا

یکی دیگه از پردازنده های قدرتمند با پشتیبانی از هوش مصنوعی Ryzen AI 9 9950X نام داره که مجهز به NPU داخلی اختصاصی است و میتونه مدل های سنگین AI رو اجرا کنه.

از جمله مهمترین مزیت های این CPU میتونم به توان پردازشی بالا و اجرای روان هوش مصنوعی اشاره کنم. البته باید بدونی که پردازنده قیمت بالایی داشته و نیاز به سیستم خنک کننده ی مناسب داره.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

چرا پردازنده مناسب برای هوش مصنوعی اهمیت دارد؟

همونطور که میدونی پردازنده ها مغز سیستم هستند و قدرت بالای آن ها به پردازش سریع داده ها کمک میکنه و واسه اجرای مدل های AI حتما باید بری سراغ CPU هایی که از هوش مصنوعی پشتیبانی میکنند.

حالا میدونی چرا بهت میگم پردازنده های مرکزی با پشتیبانی از هوش مصنوعی رو انتخاب کنی؟

✓ قدرت پردازشی بالا

از آنجایی که الگوریتم های هوش مصنوعی و یادگیری ماشین نیاز به توان محاسباتی بالایی داره باید از پردازنده های مرکزی استفاده کنی که از هوش مصنوعی پشتیبانی می کنند.

✓ بهره وری بیش تر و مصرف انرژی کمتر

از دیگر دلایل استفاده از سی پی یوهای مبتنی بر هوش مصنوعی اینه که این قطعات واسه اجرای پروژه های هوش مصنوعی طراحی شده اند و به دلیل دارا بودن NPU (واحد پردازش عصبی) میتونن مدل های AI رو با مصرف انرژی کمتر و به صورت بهینه اجرا کنند.

✓ کاربرد گسترده

با کمک cpu های هوش مصنوعی میتونی علاوه بر مدل های AI به راحتی پروژه های شبیه سازی، طراحی های سه بعدی رو اجرا کنی تازه این پردازنده های مرکزی انتخاب خوبی واسه گیمینگ هستند.

فاکتورهای مهم در انتخاب پردازنده هوش مصنوعی

حالا که بهترین پردازنده ها با پشتیبانی از هوش مصنوعی آشنا شدی و فهمیدی سیستم مورد نیاز برای هوش مصنوعی نیاز به چه سی پی یوهایی داره لازمه که بهت بگم اصلی ترین فاکتورها در انتخاب پردازنده مرکزی چیاس! پس با من همراه باش… 😊

  • توان پردازشی

قطعا اولین و مهمترین فاکتور، قدرت پردازشی سی پی یو است، در واقع هر چه این سخت افزار هوش مصنوعی قدرتمندتر باشه میتونه داده های پیچیده و مدل های بزرگ هوش مصنوعی رو با سرعت بالا پردازش کنه و این خییییلی جذابهههه… 😍

  • تعداد هسته ها

همونطور که میدونی خیلی از الگوریتم های AI نیاز به انجام عملیات مختلف همزمان دارند و واسه همین هم آن دسته از پردازنده ها که هسته های بیش تری داشته و از فناوری هایی مثل Hyper-Threading یا SMT پشتیبانی میکنند انتخاب بهتری خواهند بود.

  • میزان مصرف انرژی

نکته ی مهم دیگه مصرف بهینه ی انرژی است که البته در پروژه های بزرگ اهمیت بیشتری پیدا میکنه، بهت گفتم که پردازنده هوش مصنوعی قدرت بالای پردازش داره و خوبه که در حین قدرت بالا مصرف انرژی کمی داشته باشه.

  • حافظه

وجود پهنای باند مناسب و حافظه کش زیاد به جابه جایی سریع داده ها بین هسته و حافظه و اجرای روان پروژه ها کمک خواهد کرد.


  • هماهنگی با دیگر قطعات سخت افزاری

یک CPU مناسب باید با دیگر قطعات سخت افزاری هماهنگی کاملی داشته باشه تا سرعت اجرای مدل ها افزایش پیدا کنه، حالا اگه دوست داری با بهترین کارت گرافیک برای هوش مصنوعی و البته ارزونترینشون آشنا بشی حتما سری به مقاله ی “هفت کارت گرافیک ارزان برای هوش مصنوعی” بزن که به دردت میخوره.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

نتیجه گیری:

اگه کاربر عادی هستی و واسه لپتاپ و اجرای هوش مصنوعی های سبک دنبال سی پی یو هستی Intel Core i7/i9 و  AMD Ryzen 7 7700Xانتخاب خوبیه ولی اگه هدفت اجرای AI های سنگین تره میتونی بری سراغ Ryzen Threadripper PRO و Ryzen AI 9 9950X.

و اما در آخر…

از اینکه تا آخر این مقاله همراهم بودی ازت ممنونم، امیدوارم الان با بهترین پردازنده ها با پشتیبانی از هوش مصنوعی آشنا شده باشی، اگه دنبال خرید بهترین لپ تاپ با هوش مصنوعی یا کیس هوش مصنوعی هستی بهت پیشنهاد میکنم واسه خرید سیستم هوش مصنوعی با مناسب ترین قیمت سری به صفحه ی سیستم های هوش مصنوعی دیجیبینو بزنی؛ مطمئنم میتونی سیستم دلخواهت رو با قیمت مناسب خریداری کنی، راستی اگه نیاز به مشاوره هم داری کافیه با کارشناسان ما در ارتباط باشی، به همین سادگی! 😉

رم برای سیستم‌های هوش مصنوعی

چه میزان رم برای سیستم‌های هوش مصنوعی لازم است؟

در سال‌های اخیر، هوش مصنوعی به یکی از مهم‌ترین بخش‌های فناوری تبدیل شده است. از تشخیص چهره در گوشی‌های هوشمند گرفته تا ترجمه متون و حتی خودروهای خودران، همه این‌ها با کمک هوش مصنوعی ممکن شده‌اند. اما برای اجرای این فناوری‌ها، تنها داشتن نرم‌افزار کافی نیست. سخت‌افزار مناسب هم نقش بسیار مهمی دارد.

یکی از مهم‌ترین بخش‌های سخت‌افزار در این زمینه، حافظه رم (RAM) است. رم جایی است که اطلاعات در زمان اجرای برنامه‌ها به صورت موقت ذخیره می‌شود. اگر مقدار رم کافی نباشد، حتی بهترین الگوریتم‌ها هم به کندی اجرا می‌شوند یا اصلاً اجرا نمی‌شوند.

در این مقاله می‌خواهیم بررسی کنیم که برای اجرای پروژه‌های مختلف در زمینه هوش مصنوعی، چه مقدار رم برای سیستم های هوش مصنوعی لازم است. از کارهای ساده مثل اجرای یک چت‌بات گرفته تا آموزش مدل‌های پیچیده یادگیری عمیق، در هر مورد بررسی خواهیم کرد که چقدر رم نیاز دارید و چرا.

رم چیست و چه نقشی در سیستم دارد؟

رم یا همان حافظه موقت (Random Access Memory) یکی از اصلی‌ترین اجزای سخت‌افزار در هر کامپیوتر یا لپ‌تاپ است.

رم برای سیستم‌های هوش مصنوعی

برخلاف هارد دیسک یا حافظه SSD که اطلاعات را به صورت دائمی ذخیره می‌کنند، رم فقط برای ذخیره‌سازی موقتی اطلاعات در زمان اجرای برنامه‌ها استفاده می‌شود.

وقتی یک برنامه را باز می‌کنید یا یک مدل هوش مصنوعی را اجرا می‌کنید، بخش زیادی از داده‌ها و دستورها وارد رم می‌شوند. به این ترتیب، پردازنده می‌تواند با سرعت بالا به اطلاعات دسترسی پیدا کند و کارها را سریع‌تر انجام دهد. اگر رم کافی نباشد، سیستم به حافظه‌های کندتر مثل هارد دیسک مراجعه می‌کند که باعث کاهش شدید سرعت می‌شود.

در پروژه‌های هوش مصنوعی، معمولاً حجم زیادی از داده‌ها باید هم‌زمان پردازش شوند. مدل‌های یادگیری ماشین و یادگیری عمیق نیز نیاز به بارگذاری بخش زیادی از اطلاعات در حافظه دارند. به همین دلیل، رم نقش حیاتی در اجرای روان و سریع این برنامه‌ها دارد.

انواع کاربردهای هوش مصنوعی و نیازهای رم هرکدام

میزان رم مورد نیاز در پروژه‌های هوش مصنوعی بستگی مستقیم به نوع کار، حجم داده‌ها و پیچیدگی مدل دارد. در این بخش، کاربردهای رایج را به سه دسته کلی تقسیم می‌کنیم:

رم برای سیستم‌های هوش مصنوعی

  • کاربردهای سبک: نیاز به رم ۸ تا ۱۶ گیگابایت

در این دسته، پروژه‌هایی قرار دارند که حجم داده‌ در آن‌ها کم است و پردازش‌ها ساده‌اند. مثلاً:

طراحی چت‌بات‌های ساده

تحلیل اولیه داده‌ها با پایتون و کتابخانه‌هایی مثل Pandas

استفاده از مدل‌های آماده با داده‌های محدود (مثلاً طبقه‌بندی متن‌های کوتاه)

در این موارد، یک سیستم با ۸ تا ۱۶ گیگابایت رم معمولاً کافی است. البته اگر چند برنامه هم‌زمان اجرا شوند یا حجم فایل‌ها بیشتر از حد معمول باشد، ممکن است به رم بالاتر نیاز باشد.

  • کاربردهای متوسط: نیاز به رم ۱۶ تا ۳۲ گیگابایت

وقتی وارد پروژه‌هایی می‌شویم که نیاز به پردازش تصویر، تحلیل صوت یا اجرای مدل‌های یادگیری ماشین متوسط دارند، نیاز به رم هم افزایش پیدا می‌کند. برای مثال:

شناسایی اشیا در تصاویر با مدل‌های آماده مثل YOLO یا MobileNet

تحلیل صوت و گفتار

آموزش مدل‌های سبک با داده‌های واقعی

استفاده از فریم‌ورک‌هایی مثل TensorFlow یا PyTorch برای پروژه‌های متوسط

در این موارد، رم بین ۱۶ تا ۳۲ گیگابایت توصیه می‌شود تا هم اجرای مدل روان باشد و هم سیستم دچار کندی یا هنگ نشود.

  • کاربردهای سنگین: نیاز به رم ۶۴ گیگابایت یا بیشتر

در پروژه‌هایی که شامل یادگیری عمیق (Deep Learning) یا پردازش حجم بزرگی از داده‌ها هستند، نیاز به رم به‌طور چشمگیری افزایش می‌یابد. این کاربردها شامل موارد زیر هستند:

آموزش شبکه‌های عصبی بزرگ مثل Transformer یا مدل‌های زبان پیشرفته

پردازش و تحلیل ویدیو با کیفیت بالا

کار با دیتاست‌های سنگین مانند ImageNet یا دیتاست‌های پزشکی

استفاده از چند GPU به‌صورت هم‌زمان

در این شرایط، رم ۶۴ گیگابایت یا حتی بیشتر (۱۲۸ گیگابایت یا بالاتر) ممکن است ضروری باشد. حتی با وجود GPU قدرتمند، اگر رم کافی نباشد، سیستم نمی‌تواند اطلاعات مورد نیاز را به‌موقع به GPU منتقل کند و راندمان کار پایین می‌آید.

در نتیجه، انتخاب میزان رم مناسب کاملاً بستگی به نوع پروژه و منابع مورد استفاده دارد.

رم مورد نیاز برای آموزش مدل در برابر اجرای مدل

در پروژه‌های هوش مصنوعی، معمولاً دو مرحله اصلی وجود دارد: مرحله آموزش (Training) و مرحله اجرا یا پیش‌بینی (Inference).

رم برای سیستم‌های هوش مصنوعی

هر یک از این مراحل، نیازهای سخت‌افزاری متفاوتی دارند، به‌ویژه از نظر رم.

  • آموزش مدل (Training): نیاز به رم بالا

در مرحله آموزش، مدل باید داده‌های زیادی را بارها و بارها پردازش کند تا الگوها را یاد بگیرد. این فرآیند پیچیده و زمان‌بر است و معمولاً به رم زیادی نیاز دارد. به ویژه اگر:

اندازه دیتاست بزرگ باشد

مدل ساختار پیچیده‌ای داشته باشد (مثل شبکه‌های عمیق یا مدل‌های زبانی)

از تکنیک‌هایی مثل پردازش موازی یا چند GPU استفاده شود

برای این نوع پروژه‌ها، رم کمتر از ۳۲ یا ۶۴ گیگابایت معمولاً کافی نیست. در موارد حرفه‌ای، حتی رم‌های ۱۲۸ گیگابایتی یا بیشتر استفاده می‌شود. نبود رم کافی در این مرحله می‌تواند باعث کندی شدید، خطای اجرا یا شکست کامل فرآیند آموزش شود.

  • اجرای مدل (Inference): نیاز به رم کمتر

در مرحله اجرای مدل، سیستم از مدل آموزش‌دیده برای پیش‌بینی یا تحلیل استفاده می‌کند. دراین حالت، داده‌ها معمولاً کوچک‌تر هستند و مدل فقط یک‌بار آن‌ها را پردازش می‌کند.

نتیجه اینکه، میزان رم مورد نیاز بسیار کمتر از مرحله آموزش است. در بسیاری از موارد، حتی با رم ۸ تا ۱۶ گیگابایت هم می‌توان مدل‌های نسبتاً پیشرفته را اجرا کرد. برای مثال:

اجرای یک مدل طبقه‌بندی تصویر از پیش آموزش‌دیده

پاسخ‌گویی یک چت‌بات با مدل زبان آماده

تحلیل ساده متن یا عدد

البته اگر مدل بسیار بزرگ باشد (مثلاً مدل‌های زبانی جدید)، ممکن است حتی اجرای آن هم نیاز به رم بالا داشته باشد. اما در کل، Inference نسبت به Training رم کمتری مصرف می‌کند.

سایر عوامل مؤثر بر عملکرد کنار رم

در اجرای پروژه‌های هوش مصنوعی، رم یکی از عوامل کلیدی است؛ اما تنها عامل نیست. حتی اگر رم زیادی داشته باشید، اگر دیگر بخش‌های سیستم متناسب نباشند، باز هم با کندی یا خطا روبه‌رو می‌شوید. در این بخش، به چند عامل مهم دیگر اشاره می‌کنیم:

  • کارت گرافیک (GPU) و حافظه گرافیکی (VRAM)

در بسیاری از پروژه‌های یادگیری ماشین و به‌ویژه یادگیری عمیق، بخش زیادی از محاسبات توسط کارت گرافیک انجام می‌شود. کارت‌های گرافیکی مخصوص محاسبات (مثل سری NVIDIA RTX یا H100) دارای حافظه مخصوص به نام VRAM هستند.

اگر VRAM کافی نباشد، مدل‌های سنگین قابل آموزش یا اجرا نخواهند بود. حتی اگر رم سیستم زیاد باشد، اما کارت گرافیک ضعیف یا کم‌حافظه باشد، عملکرد به‌شدت کاهش می‌یابد.

  • پردازنده (CPU) مناسب

CPU یا همان پردازنده مرکزی، در کنار GPU وظیفه پردازش اطلاعات را دارد. در کارهایی که از GPU استفاده نمی‌شود، سرعت و قدرت CPU بسیار مهم می‌شود. پردازنده‌های چند هسته‌ای با فرکانس بالا می‌توانند فرآیندهای موازی را بهتر مدیریت کنند.

  • دیسک سخت و سرعت خواندن/نوشتن

اگر داده‌ها روی هارد دیسک‌های قدیمی (HDD) ذخیره شوند، سرعت بارگذاری آن‌ها به رم پایین خواهد بود. استفاده از حافظه‌های SSD به‌ویژه نوع NVMe می‌تواند سرعت سیستم را به شکل قابل توجهی افزایش دهد. این موضوع در پروژه‌هایی با حجم بالای داده بسیار اهمیت دارد.

  • بهینه‌سازی نرم‌افزاری

گاهی با وجود سخت‌افزار مناسب، کد پروژه بهینه نیست و منابع را به‌درستی استفاده نمی‌کند. استفاده از تکنیک‌هایی مانند:

Mini-batch processing

کاهش دقت مدل (مثلاً استفاده از float16 به‌جای float32)

استفاده از حافظه اشتراکی بین GPU و CPU

می‌تواند مصرف رم و منابع دیگر را کاهش دهد.

در نتیجه، هنگام بررسی عملکرد سیستم در پروژه‌های هوش مصنوعی، بهتر است همه اجزای سخت‌افزار و حتی شیوه کدنویسی را در نظر گرفت، نه فقط مقدار رم.

نتیجه‌گیری و پیشنهاد نهایی

هوش مصنوعی به بخشی جدانشدنی از فناوری امروز تبدیل شده و برای اجرای موفق پروژه‌های مرتبط با آن، تنها داشتن دانش برنامه‌نویسی کافی نیست. سخت‌افزار مناسب، به‌ویژه مقدار رم، نقش بسیار مهمی در سرعت، دقت و پایداری اجرای پروژه‌ها دارد.

در این مقاله دیدیم که:

  • پروژه‌های سبک با رم ۸ تا ۱۶ گیگابایت قابل اجرا هستند.
  • برای پروژه‌های متوسط، رم بین ۱۶ تا ۳۲ گیگابایت پیشنهاد می‌شود.
  • پروژه‌های سنگین مانند آموزش مدل‌های یادگیری عمیق به رم ۶۴ گیگابایت یا بیشتر نیاز دارند.
  • مرحله آموزش مدل معمولاً رم بیشتری نسبت به مرحله اجرا (Inference) مصرف می‌کند.

سایر عوامل مانند کارت گرافیک، پردازنده، حافظه SSD و بهینه‌سازی نرم‌افزاری نیز تأثیر مستقیم بر عملکرد دارند.اگر در حال برنامه‌ریزی برای شروع یک پروژه هوش مصنوعی هستید، بهتر است ابتدا نوع پروژه و نیازهای دقیق آن را مشخص کنید. سپس بر اساس آن، تصمیم بگیرید که چه مقدار رم و چه سخت‌افزاری برای شما مناسب است. در بسیاری از موارد، اگر امکان ارتقاء سخت‌افزار شخصی وجود ندارد، استفاده از سرویس‌های ابری مثل Google Colab، AWS یا Azure می‌تواند جایگزین مناسبی باشد.در نهایت، انتخاب دقیق و متناسب با نیاز باعث می‌شود نه تنها هزینه‌ها کاهش یابد، بلکه بهره‌وری سیستم نیز افزایش پیدا کند.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟

برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟ این سوال بسیاری از کاربران ابزار های هوش مصنوعی می باشد. در سال‌های اخیر، هوش مصنوعی به یکی از موضوعات داغ در دنیای فناوری تبدیل شده است. بسیاری از افراد از ابزارهای مختلف هوش مصنوعی برای تولید متن، ترجمه، طراحی تصویر، و حتی تحلیل داده‌ها استفاده می‌کنند. این ابزارها سرعت انجام کارها را افزایش داده و باعث صرفه‌جویی در زمان می‌شوند. اما برای استفاده مؤثر از این ابزارها، باید به توانایی‌های سخت‌افزاری دستگاه نیز توجه کرد. یکی از مهم‌ترین بخش‌های سخت‌افزار که نقش زیادی در اجرای درست این برنامه‌ها دارد، حافظه رم است.

در این مقاله، بررسی می‌کنیم که رم چیست، چرا برای اجرای ابزارهای هوش مصنوعی اهمیت دارد، و برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟

رم  چیست و چه نقشی در اجرای برنامه‌ها دارد؟

رم یا حافظه دسترسی تصادفی ، یکی از اجزای اصلی هر رایانه یا لپ‌تاپ است. زمانی که یک برنامه یا ابزار را باز می‌کنید، اطلاعات مورد نیاز آن به‌طور موقت در رم ذخیره می‌شود تا سرعت اجرا و عملکرد آن بهتر باشد. در واقع، رم مانند یک میز کار برای پردازنده است. هرچه این میز بزرگ‌تر باشد، برنامه‌های بیشتری را می‌توان هم‌زمان و بدون کندی اجرا کرد.

برخلاف حافظه‌هایی مانند هارد یا SSD که اطلاعات را به‌صورت دائمی ذخیره می‌کنند، رم اطلاعات را فقط زمانی نگه می‌دارد که سیستم روشن باشد. به محض خاموش شدن دستگاه، اطلاعات موجود در رم پاک می‌شود.

هرچه یک برنامه پیچیده‌تر باشد یا نیاز به پردازش داده‌های بیشتری داشته باشد، مقدار بیشتری از رم را اشغال می‌کند. ابزارهای هوش مصنوعی، به دلیل حجم زیاد داده‌هایی که پردازش می‌کنند، معمولاً به رم بیشتری نسبت به برنامه‌های معمولی نیاز دارند. به همین دلیل، دانستن مقدار رم مناسب و اینکه برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟ برای این ابزارها اهمیت زیادی دارد.

چرا رم در اجرای ابزارهای هوش مصنوعی مهم است؟

سیستم های هوش مصنوعی برای انجام وظایف خود به مقدار زیادی داده نیاز دارند. این داده‌ها باید به‌سرعت پردازش، تحلیل و گاهی ذخیره شوند. رم به‌عنوان حافظه‌ای که دسترسی به آن سریع است، نقش کلیدی در این فرایند ایفا می‌کند. زمانی که یک ابزار هوش مصنوعی فعال می‌شود، داده‌ها به‌صورت موقت در رم بارگذاری می‌شوند تا پردازنده بتواند با سرعت بیشتری آن‌ها را بررسی کند.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

اگر رم سیستم شما کم باشد، اجرای ابزارهای هوش مصنوعی با کندی یا حتی اختلال مواجه خواهد شد. ممکن است برنامه باز نشود، به‌درستی اجرا نشود، یا هنگام انجام پردازش متوقف شود. از سوی دیگر، رم بیشتر به سیستم اجازه می‌دهد تا چندین برنامه یا فرایند را به‌صورت هم‌زمان و بدون کاهش سرعت اجرا کند.

همچنین، بسیاری از ابزارهای هوش مصنوعی، به‌ویژه در زمینه پردازش تصویر، ویدئو یا مدل‌های زبانی بزرگ، حجم زیادی از رم را مصرف می‌کنند. به همین دلیل، انتخاب مقدار مناسب رم برای نوع ابزاری که می‌خواهید اجرا کنید و اینکه برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم، موضوع بسیار مهمی است.

میزان رم مورد نیاز برای اجرای ابزارهای مختلف هوش مصنوعی

نیاز به رم در اجرای ابزارهای هوش مصنوعی به نوع و پیچیدگی آن‌ها بستگی دارد. برخی از این ابزارها به‌صورت آنلاین و ساده اجرا می‌شوند، در حالی که برخی دیگر، برای اجرای درست به سخت‌افزارهای قدرتمند و رم بالا نیاز دارند. در ادامه، این ابزارها را در سه سطح بررسی می‌کنیم.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

  • ابزارهای ساده و آنلاین

ابزارهایی مانند نسخه آنلاین ChatGPT، مترجم‌های مبتنی بر هوش مصنوعی، ابزارهای تولید متن یا تصویر ساده، معمولاً به سخت‌افزار قوی نیاز ندارند. این ابزارها بیشتر بر پایه اینترنت کار می‌کنند و پردازش اصلی روی سرورهای ابری انجام می‌شود.

رم پیشنهادی: ۴ تا ۸ گیگابایت

ویژگی‌ها: قابل استفاده در سیستم‌های معمولی یا لپ‌تاپ‌های دانشجویی

مثال‌ها: ChatGPT، Google Translate با هوش مصنوعی، ابزارهای نوشتن محتوا یا تولید کپشن آنلاین

  • ابزارهای نیمه‌حرفه‌ای

این دسته شامل برنامه‌هایی است که باید روی سیستم نصب شوند و برای پردازش‌های سنگین‌تر طراحی شده‌اند. ابزارهایی مانند نرم‌افزارهای پردازش تصویر یا صدا که از هوش مصنوعی استفاده می‌کنند، به رم بیشتری نیاز دارند.

رم پیشنهادی: ۸ تا ۱۶ گیگابایت

ویژگی‌ها: مناسب برای کاربران حرفه‌ای‌تر، تولیدکنندگان محتوا، طراحان یا پژوهشگران

مثال‌ها: نرم‌افزارهای ویرایش عکس با هوش مصنوعی، برنامه‌های تولید صدا یا حذف نویز با الگوریتم‌های هوشمند

  • ابزارهای پیشرفته و حرفه‌ای

مدل‌های زبانی بزرگ، ابزارهای یادگیری عمیق، برنامه‌هایی که نیاز به آموزش مدل دارند یا خروجی‌هایی با کیفیت بسیار بالا تولید می‌کنند، در این گروه قرار می‌گیرند. اجرای این ابزارها نیازمند سیستم قدرتمند، رم بالا و گاهی کارت گرافیک پیشرفته است.

رم پیشنهادی: ۱۶ تا ۳۲ گیگابایت (یا بیشتر)

ویژگی‌ها: مناسب برای پژوهشگران حوزه هوش مصنوعی، توسعه‌دهندگان مدل‌های یادگیری ماشین، یا کسانی که با مدل‌های مولد بزرگ کار می‌کنند

مثال‌ها: اجرای مدل GPT به‌صورت محلی، Stable Diffusion، آموزش مدل با کتابخانه‌های TensorFlow یا PyTorch

آیا داشتن رم بیشتر همیشه به معنای عملکرد بهتر است؟

در نگاه اول ممکن است تصور شود که هرچه میزان رم بیشتر باشد، عملکرد سیستم نیز بهتر خواهد بود. این موضوع تا حدی درست است، اما همیشه به این سادگی نیست. رم بیشتر، زمانی مفید است که سیستم بتواند از آن استفاده کند. اگر از ابزارهای ساده یا نیمه‌حرفه‌ای استفاده می‌کنید، داشتن رم بیش از حد معمول، لزوماً تاثیری در سرعت یا کیفیت اجرا نخواهد داشت.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

همچنین باید توجه داشت که رم باید با سایر اجزای سیستم هماهنگ باشد. اگر پردازنده (CPU) یا کارت گرافیک (GPU) ضعیف باشند، رم بیشتر نمی‌تواند به‌تنهایی باعث افزایش چشمگیر سرعت شود. به‌عبارت دیگر، تمام اجزای سیستم باید به‌صورت متعادل ارتقا یابند تا بهترین کارایی را ارائه دهند.

در برخی موارد نیز، سیستم‌عامل یا نرم‌افزارهای مورد استفاده، محدودیتی برای استفاده از رم دارند. برای مثال، برخی نسخه‌های سیستم‌عامل‌های ۳۲ بیتی نمی‌توانند از بیش از ۴ گیگابایت رم استفاده کنند.

در نتیجه، پیش از افزایش رم، بهتر است نیاز واقعی خود و توان سخت‌افزار سیستم را بررسی کنید. گاهی اوقات بهینه‌سازی نرم‌افزاری یا بستن برنامه‌های غیرضروری می‌تواند تأثیر بیشتری نسبت به ارتقای رم داشته باشد.

راه‌کارهایی برای استفاده بهتر و بهینه از رم

حتی اگر سیستم شما رم بالایی ندارد، با رعایت چند نکته ساده می‌توان عملکرد آن را تا حد زیادی بهبود داد. بسیاری از کاربران بدون نیاز به ارتقای سخت‌افزاری، فقط با بهینه‌سازی استفاده از رم، تجربه روان‌تری در کار با ابزارهای هوش مصنوعی خواهند داشت.

  • بستن برنامه‌های اضافی

هر برنامه‌ای که در پس‌زمینه باز است، بخشی از رم را اشغال می‌کند. بهتر است هنگام کار با ابزارهای هوش مصنوعی، سایر برنامه‌های غیرضروری را ببندید تا رم آزاد شود.

  • استفاده از سیستم‌عامل سبک‌تر

سیستم‌عامل‌های سبک‌تر مانند نسخه‌های بهینه‌سازی‌شده ویندوز یا توزیع‌های ساده لینوکس، رم کمتری مصرف می‌کنند و فضای بیشتری برای اجرای ابزارهای هوش مصنوعی باقی می‌گذارند.

  • ارتقای رم در صورت امکان

اگر سیستم شما امکان ارتقای رم دارد، این کار یکی از مؤثرترین روش‌ها برای افزایش سرعت و توانایی در اجرای برنامه‌های سنگین‌تر است.

  • استفاده از حافظه مجازی

در ویندوز و برخی دیگر از سیستم‌عامل‌ها می‌توان با تنظیم حافظه مجازی (یا فایل Swap)، بخشی از حافظه هارد را به‌عنوان رم استفاده کرد. این کار به‌ویژه در زمان‌هایی که رم واقعی پر شده است، کمک می‌کند سیستم از کار نیفتد.

  • استفاده از سرویس‌های ابری یا رایانش ابری

برای اجرای ابزارهای بسیار سنگین، می‌توان از سرورهای ابری مانند Google Colab، Microsoft Azure یا Amazon Web Services استفاده کرد. در این سرویس‌ها، پردازش و مصرف رم روی سرور انجام می‌شود و نیازی به سخت‌افزار قدرتمند در سیستم شخصی نخواهد بود.

جمع‌بندی

ابزارهای هوش مصنوعی برای اجرای درست و روان، به سخت‌افزار مناسب نیاز دارند و رم یکی از مهم‌ترین اجزای آن است. میزان رم مورد نیاز بستگی به نوع ابزاری دارد که از آن استفاده می‌کنید؛ از ابزارهای ساده‌ی آنلاین گرفته تا مدل‌های پیشرفته‌ی یادگیری ماشین.

اگرچه رم بالا می‌تواند به عملکرد بهتر کمک کند، اما تنها عامل تعیین‌کننده نیست. هماهنگی میان رم، پردازنده، و کارت گرافیک، و همچنین استفاده درست از منابع سیستم، تأثیر زیادی در نتیجه نهایی دارد.

پیش از ارتقای رم یا خرید سیستم جدید، بهتر است نیاز خود را بررسی کنید. گاهی با چند تنظیم ساده یا استفاده از خدمات ابری می‌توان بدون هزینه زیاد، از هوش مصنوعی بهره‌برداری کرد.

هوش مصنوعی بینگ

معرفی هوش مصنوعی بینگ

از دستیارهای صوتی گرفته تا پیشنهادهای هوشمند در شبکه‌های اجتماعی، تقریباً هر روز با نوعی از هوش مصنوعی سر و کار دارند. یکی از حوزه‌هایی که تغییرات چشم‌گیری داشته، موتورهای جست‌وجو هستند. شرکت‌های بزرگ فناوری تلاش کرده‌اند جست‌وجو را از حالت سنتی به گفت‌وگویی هوشمند تبدیل کنند.

مایکروسافت هم یکی از این شرکت‌هاست که با استفاده از هوش مصنوعی، نسخه‌ای جدید از موتور جست‌وجوی خود یعنی Bing را معرفی کرده است. Bing AI یا همان بینگ هوش‌مند، تنها یک ابزار جست‌وجو نیست؛ بلکه ترکیبی از یک موتور جست‌وجو، یک دستیار هوشمند، و یک گفت‌وگوی زنده است. در این مقاله، با Bing AI آشنا می‌شویم، ویژگی‌های آن را بررسی می‌کنیم و نگاهی به آینده‌ی این فناوری خواهیم داشت.

 Bing قبل از هوش مصنوعی

قبل از آن‌که Bing به هوش مصنوعی مجهز شود، مانند سایر موتورهای جست‌وجوی سنتی عمل می‌کرد. کاربران با وارد کردن عبارت مورد نظر خود، به فهرستی از نتایج وب‌سایت‌ها می‌رسیدند که باید در آن‌ها جست‌وجو می‌کردند تا پاسخ خود را پیدا کنند. تمرکز این مدل بیشتر روی نمایش لینک‌ها، تبلیغات و رتبه‌بندی صفحات بود.

مایکروسافت Bing را در سال ۲۰۰۹ معرفی کرد تا با گوگل رقابت کند. این موتور جست‌وجو از همان ابتدا تلاش داشت نتایجی دقیق‌تر، دسته‌بندی‌شده‌تر و کاربردی‌تر ارائه دهد. اما با وجود به‌روزرسانی‌های متعدد، برای مدت‌ها در سایه‌ی گوگل باقی ماند و کاربران کمتری از آن استفاده می‌کردند.

تا پیش از ورود فناوری‌های نوین هوش مصنوعی، تجربه‌ی جست‌وجو در Bing تفاوت زیادی با دیگر موتورهای جست‌وجو نداشت. کاربران همچنان باید خودشان اطلاعات را از میان ده‌ها لینک پیدا و جمع‌آوری می‌کردند. همین موضوع باعث شد که مایکروسافت به فکر تحول اساسی در Bing بیفتد — تحولی که با هوش مصنوعی ممکن شد.

 Bing AI چیست؟

Bing AI نسخه‌ی جدید و پیشرفته‌ای از موتور جست‌وجوی Bing است که با استفاده از هوش مصنوعی، تجربه‌ی جست‌وجو را هوشمندتر، سریع‌تر و تعاملی‌تر کرده است. در این نسخه، کاربران فقط یک عبارت را جست‌وجو نمی‌کنند، بلکه می‌توانند گفت‌وگویی واقعی با یک سیستم هوش مصنوعی داشته باشند.

هوش مصنوعی بینگ

مایکروسافت این نسخه را در سال ۲۰۲۳ معرفی کرد، درست زمانی که مدل‌های زبانی مثل GPT-4 به اوج توجه رسیده بودند. Bing AI با استفاده از این مدل‌ها، می‌تواند سوالات را بهتر درک کند، پاسخ‌های دقیق‌تر و منسجم‌تری بدهد و حتی موضوعات پیچیده را به زبان ساده توضیح دهد.

یکی از مهم‌ترین تفاوت‌های Bing AI با نسخه‌ی قدیمی، توانایی آن در پاسخ‌گویی با درک بیشتر از هدف کاربر است. مثلاً اگر بنویسید «برای تولد یک نوجوان چه هدیه‌ای بخرم؟»، Bing-AI صرفاً فهرستی از سایت‌های فروش هدیه را نمایش نمی‌دهد، بلکه چند پیشنهاد مشخص، همراه با توضیح دلیل مناسب بودن آن‌ها، ارائه می‌کند.

علاوه بر این، کاربران می‌توانند با Bing-AI مکالمه کنند، سوال‌های بعدی بپرسند، یا از آن بخواهند توضیح را ساده‌تر یا کامل‌تر کند. این ارتباط دوطرفه، تجربه‌ی جست‌وجو را به چیزی شبیه تعامل با یک مشاور تبدیل کرده است، نه فقط یک موتور نمایش لینک.

پشت‌صحنه‌ی Bing AI: همکاری با OpenAI

یکی از دلایل پیشرفت Bing AI، همکاری مایکروسافت با شرکت OpenAI است. OpenAI همان شرکتی است که مدل‌های معروف ChatGPT را توسعه داده است. مایکروسافت با سرمایه‌گذاری‌های بزرگ روی این شرکت، توانست از مدل‌های زبانی پیشرفته مانند GPT-4 در ساختار جدید Bing استفاده کند.

هوش مصنوعی بینگ

GPT-4 یک مدل زبانی قدرتمند است که می‌تواند زبان انسان را تا حد زیادی درک و تولید کند. Bing AI با ترکیب این مدل با داده‌های به‌روز اینترنت، توانسته هم هوشمند باشد، هم متصل به دنیای واقعی. این یعنی پاسخ‌هایی که Bing می‌دهد، فقط از اطلاعات آموزش‌دیده نیست، بلکه شامل اطلاعات جدید از وب نیز می‌شود.

به بیان ساده، مایکروسافت با کمک OpenAI موفق شده موتور جست‌وجویی بسازد که هم گفت‌وگومحور است، هم تحلیلی، هم به‌روز. این ترکیب باعث شده Bing AI از یک ابزار ساده جست‌وجو فراتر برود و به یک دستیار هوش‌مند واقعی نزدیک شود.

 قابلیت‌های Bing AI

Bing-AI امکاناتی فراتر از جست‌وجوی معمولی ارائه می‌دهد. این ابزار به کمک هوش مصنوعی توانسته جست‌وجو را به تجربه‌ای گفت‌وگومحور و شخصی‌تر تبدیل کند. در اینجا چند مورد از مهم‌ترین قابلیت‌های Bing AI را مرور می‌کنیم:

۱.گفت‌وگوی تعاملی

کاربر می‌تواند سؤال خود را به‌صورت طبیعی مطرح کند و منتظر پاسخ مستقیم، روشن و منظم از Bing AI باشد. اگر پاسخ کافی نبود، امکان طرح سؤال‌های بعدی و ادامه گفت‌وگو وجود دارد.

 ۲.پاسخ‌های ترکیبی

به‌جای نمایش فهرست بلندبالایی از لینک‌ها، Bing-AI اطلاعات را از منابع مختلف جمع‌آوری کرده و به‌صورت خلاصه‌شده و قابل فهم ارائه می‌دهد. این باعث صرفه‌جویی در زمان و تمرکز بیشتر روی اصل پاسخ می‌شود.

 ۳.تولید محتوا

Bing AI می‌تواند متن‌های ساده، خلاصه‌نویسی، معرفی کتاب، یا حتی کمک در نوشتن ایمیل یا پست‌های شبکه‌های اجتماعی ارائه دهد. این قابلیت برای کاربران عمومی و حتی دانشجویان بسیار کاربردی است.

۴.تولید تصویر با AI

در نسخه‌های جدیدتر، Bing AI امکان ساخت تصویر بر اساس توصیف متنی را فراهم کرده است. این قابلیت با کمک مدل‌های هوش مصنوعی تصویری مانند DALL·E انجام می‌شود و برای کارهای خلاقانه بسیار مفید است.

 ۵.ترجمه و خلاصه‌سازی

Bing می‌تواند متن‌ها را ترجمه کند، متن‌های طولانی را خلاصه کند یا حتی مفاهیم پیچیده را به زبان ساده توضیح دهد.

تفاوت Bing AI با چت‌جی‌پی‌تی و گوگل

در نگاه اول، Bing AI، ChatGPT و گوگل کار مشابهی انجام می‌دهند: کمک به یافتن اطلاعات. اما تفاوت‌هایی میان این سه ابزار وجود دارد که دانستن آن‌ها به انتخاب بهتر کمک می‌کند.

هوش مصنوعی بینگ

 تفاوت با ChatGPT

ChatGPT یک مدل گفت‌وگومحور است که به اینترنت متصل نیست (مگر در نسخه‌های خاص با قابلیت جست‌وجو). اطلاعات آن بر پایه داده‌هایی است که از قبل آموزش دیده است. در مقابل، Bing AI هم از مدل زبانی مشابه ChatGPT استفاده می‌کند، و هم به اینترنت متصل است. این یعنی می‌تواند پاسخ‌هایی بر اساس اطلاعات به‌روز وب بدهد و به لینک‌های معتبر ارجاع دهد.

 تفاوت با گوگل

گوگل هنوز بیشتر بر پایه نمایش لینک‌ها و رتبه‌بندی صفحات عمل می‌کند. پاسخ مستقیم در آن کمتر دیده می‌شود، مگر در بخش‌هایی مثل “People also ask” یا کادرهای ویژه. در Bing AI، تمرکز بر ارائه‌ی پاسخ آماده و خلاصه‌شده است، بدون نیاز به گشتن بین چندین سایت. این باعث می‌شود کاربران سریع‌تر به جواب برسند.

 انتخاب بین آن‌ها

اگر دنبال گفت‌وگویی ساده و بدون اینترنت هستید، ChatGPT گزینه‌ی خوبی است. اگر نیاز به جست‌وجوی زنده، خلاصه‌ی اطلاعات، و منابع واقعی دارید، Bing AI انتخاب مناسب‌تری خواهد بود. گوگل هم همچنان برای جست‌وجوهای دقیق و گسترده، ابزار قوی و قابل اعتمادی باقی مانده است.

 چالش‌ها و محدودیت‌های Bing AI

با وجود پیشرفت‌های چشم‌گیر، Bing AI هنوز بدون ایراد نیست و برخی چالش‌ها را با خود دارد.

یکی از مهم‌ترین محدودیت‌ها، وابستگی به اینترنت است. برخلاف برخی ابزارهای هوش مصنوعی که به صورت آفلاین توسط سیستم های هوش مصنوعی قدرتمند نیز تا حدی قابل استفاده هستند، Bing AI تنها در صورتی کار می‌کند که کاربر به اینترنت متصل باشد.

همچنین، کیفیت پاسخ‌ها همیشه یکسان نیست. گاهی Bing AI ممکن است اطلاعات نادرست یا ناقص ارائه دهد، به‌ویژه زمانی که موضوع پیچیده یا مبهم باشد. در بعضی موارد، متن‌های تولیدشده بیش از حد عمومی یا سطحی هستند و نیاز به بررسی و تکمیل دارند.

یکی دیگر از چالش‌ها، پیچیدگی برای برخی کاربران تازه‌کار است. افرادی که به موتورهای جست‌وجوی سنتی عادت دارند، ممکن است در ابتدای کار با ساختار چت‌محور کمی سردرگم شوند یا ندانند چطور درخواست خود را به‌درستی بیان کنند.

با این حال، مایکروسافت به‌طور مداوم در حال به‌روزرسانی Bing AI است و این مشکلات به مرور زمان در حال کاهش هستند.

نتیجه‌گیری

هوش مصنوعی Bing AI نشان می‌دهد که چگونه فناوری می‌تواند تجربه جست‌وجوی ما را بهتر و هوشمندتر کند. این ابزار فراتر از یک موتور جست‌وجوی ساده است و با قابلیت‌های گفت‌وگومحور و پاسخ‌های دقیق‌تر، نقش یک دستیار هوشمند را ایفا می‌کند.

با همکاری مایکروسافت و OpenAI، Bing AI توانسته به سرعت به روز شود و به کاربران امکان دهد اطلاعات را سریع‌تر، ساده‌تر و دقیق‌تر پیدا کنند. البته هنوز چالش‌ها و محدودیت‌هایی وجود دارد که با پیشرفت فناوری، کم‌رنگ‌تر خواهد شد.

در نهایت، آشنایی با ابزارهایی مانند Bing AI برای هر فردی اهمیت دارد، زیرا هوش مصنوعی به سرعت در زندگی روزمره ما نقش پررنگ‌تری پیدا می‌کند. استفاده هوشمندانه از این فناوری می‌تواند به ما کمک کند تا کارهای روزمره را آسان‌تر انجام دهیم و به اطلاعات بهتر و کامل‌تری دست پیدا کنیم.

هوش مصنوعی Grok

معرفی هوش مصنوعی Grok

هوش مصنوعی در سال‌های اخیر به بخشی مهم از زندگی ما تبدیل شده است. از موتورهای جست‌وجو گرفته تا چت‌بات‌ها، این فناوری هر روز پیشرفته‌تر می‌شود. یکی از ابزارهای جدید در این زمینه، Grok است. این هوش مصنوعی توسط شرکت xAI ساخته شده که بنیان‌گذار آن ایلان ماسک است. Grok با هدف ایجاد یک چت‌بات هوشمند، سریع و حتی تا حدی طنزآمیز طراحی شده است.

در این مقاله به‌صورت ساده و کاربردی، نگاهی خواهیم داشت به اینکه Grok چیست، چه ویژگی‌هایی دارد و چه تفاوتی با دیگر مدل‌های هوش مصنوعی دارد.

هوش مصنوعی Grok چیست؟

Grok یک چت‌بات هوش مصنوعی است که توسط شرکت xAI ساخته شده؛ شرکتی که در سال ۲۰۲۳ توسط ایلان ماسک تأسیس شد. هدف از ساخت Grok، ارائه‌ی مدلی متفاوت از چت‌بات‌های رایج مانند ChatGPT بود.

نام Grok از یک رمان علمی-تخیلی گرفته شده و به معنای “فهمیدن عمیق” است. این مدل طوری طراحی شده که بتواند با کاربران گفت‌وگو کند، اطلاعات زنده از شبکه‌ی اجتماعی X (توییتر سابق) دریافت کند و پاسخ‌هایی هوشمندانه و گاه طنزآمیز بدهد.

Grok فقط برای کاربران دارای اشتراک X Premium در دسترس است و بیشتر برای تعامل در فضای شبکه‌های اجتماعی طراحی شده است.

 ویژگی‌های اصلی Grok

Grok فقط یک چت‌بات معمولی نیست. این سیستم هوش مصنوعی چند ویژگی خاص دارد که آن را از دیگر ابزارهای مشابه متمایز می‌کند:

معرفی هوش مصنوعی GROK

  • دسترسی به داده‌های زنده

یکی از مهم‌ترین ویژگی‌های Grok، توانایی آن در دسترسی به اطلاعات زنده از شبکه اجتماعی X (توییتر سابق) است. این یعنی می‌تواند به سرعت به اخبار جدید، ترندها و اتفاقات روز واکنش نشان دهد؛ چیزی که بسیاری از مدل‌های دیگر ندارند.

  • سبک گفت‌وگوی آزاد و طنزآمیز

Grok طوری طراحی شده که گفت‌وگویی طبیعی، صمیمی و گاهی همراه با شوخی داشته باشد. این ویژگی باعث شده کاربران احساس راحتی بیشتری هنگام صحبت با آن داشته باشند.

  • مخصوص کاربران X Premium

Grok بخشی از خدمات ویژه‌ی اشتراک X Premium است. یعنی فقط کاربرانی که این اشتراک را دارند، می‌توانند از آن استفاده کنند. این ویژگی باعث شده Grok بیشتر با فضای شبکه‌های اجتماعی گره خورده باشد.

  • طراحی با تمرکز بر تعامل انسانی

برخلاف برخی از مدل‌های هوش مصنوعی که رسمی یا خشک صحبت می‌کنند، Grok سعی دارد مکالماتی شبیه گفت‌وگوی واقعی بین انسان‌ها ارائه دهد.

 مقایسه Grok با مدل‌های دیگر

در مقایسه با ابزارهایی مانند ChatGPT، Gemini و Claude، Grok تفاوت‌های جالبی دارد:

هوش مصنوعی Grok

هوش مصنوعی CHATGPT

ChatGPT (ساخته OpenAI) یک مدل همه‌کاره است که برای آموزش، نگارش، کدنویسی و پاسخ‌گویی دقیق طراحی شده و در محیط‌های رسمی کاربرد زیادی دارد.

هوش مصنوعی GEMINI

Gemini (گوگل) تمرکز زیادی روی ادغام با خدمات گوگل، تحلیل تصویر و متن هم‌زمان، و استفاده در ابزارهای تجاری دارد.

هوش مصنوعی Claude

Claude (Anthropic) روی اخلاق، شفافیت و پاسخ‌گویی امن تمرکز دارد.


در حالی که این مدل‌ها روی دقت، قابلیت تعمیم و امنیت تمرکز دارند، Grok تمرکز خود را روی تعامل، سبک مکالمه، و واکنش سریع به داده‌های روز گذاشته است.

 کاربردهای احتمالی Grok

Grok فقط یک ابزار برای چت کردن نیست. با توجه به ویژگی‌هایی که دارد، می‌توان از آن در زمینه‌های مختلفی استفاده کرد. در این بخش، به چند کاربرد مهم آن اشاره می‌کنیم:

هوش مصنوعی Grok

  • تحلیل اخبار و رویدادهای روز

با توجه به اینکه Grok به اطلاعات زنده از شبکه‌ی X دسترسی دارد، می‌تواند به‌سرعت درباره‌ی اخبار جدید، واکنش کاربران و روندهای اجتماعی تحلیل بدهد. این ویژگی برای خبرنگاران، تحلیل‌گران و حتی کاربران عادی بسیار مفید است.

  • تولید محتوا در شبکه‌های اجتماعی

کاربران می‌توانند از Grok برای نوشتن توییت، ایده‌پردازی، یا حتی پاسخ دادن به نظرات استفاده کنند. چون Grok سبک گفت‌وگوی آزاد و غیررسمی دارد، برای فضای غیررسمی شبکه‌های اجتماعی کاملاً مناسب است.

  • آموزش و یادگیری

هرچند Grok به‌صورت مستقیم برای آموزش طراحی نشده، اما کاربران می‌توانند از آن برای گرفتن پاسخ‌های سریع و ساده به سوال‌های عمومی استفاده کنند. البته در زمینه‌های تخصصی، مدل‌هایی مثل ChatGPT ممکن است پاسخ‌های دقیق‌تری بدهند.

  • سرگرمی و تعامل

سبک گفت‌وگوی Grok گاهی طنزآمیز و شوخ‌طبعانه است. این ویژگی باعث شده بعضی کاربران فقط برای سرگرمی با آن گفت‌وگو کنند و از مکالمه با یک «ربات بامزه» لذت ببرند.

  • پیگیری ترندها و بازار

برای کسانی که دنبال‌کننده‌ی بازارها، رمزارزها یا ترندهای اجتماعی هستند، Grok می‌تواند ابزاری سریع برای گرفتن اطلاعات لحظه‌ای باشد. البته همیشه باید اطلاعات آن را با منابع معتبر بررسی کرد.

 چالش‌ها و انتقادات درمورد GROK

هرچند Grok ابزار جالب و نوآورانه‌ای است، اما بدون مشکل هم نیست. در ادامه چند مورد از مهم‌ترین چالش‌ها و نگرانی‌ها را مرور می‌کنیم:

  • نگرانی درباره حریم خصوصی

یکی از انتقادهای اصلی به Grok، نگرانی درباره‌ی دسترسی آن به داده‌های شخصی یا فعالیت کاربران در X است. اگرچه هنوز اطلاعات دقیق زیادی در این مورد منتشر نشده، اما برخی کاربران نگرانند که اطلاعات‌شان بدون رضایت یا کنترل کافی پردازش شود.

  • احتمال ارائه اطلاعات نادرست

همانند بسیاری از مدل‌های هوش مصنوعی، Grok هم گاهی ممکن است اطلاعات اشتباه یا ناقص ارائه دهد. چون به داده‌های زنده دسترسی دارد، گاهی ممکن است بدون بررسی صحت آن‌ها، فقط اطلاعات ترند شده را بازتاب دهد.

  • لحن بیش از حد آزاد یا غیررسمی

سبک شوخ‌طبعانه و آزاد Grok برای همه مناسب نیست. برخی کاربران آن را بیش از حد خودمانی یا حتی نامناسب می‌دانند، به‌ویژه در مواردی که انتظار پاسخ رسمی یا دقیق دارند.

  • محدود بودن دسترسی

Grok فقط برای کاربران X Premium در دسترس است. این باعث شده که برخلاف ابزارهایی مثل ChatGPT که عمومی‌تر هستند، تعداد کاربران Grok محدودتر باشد و تجربه‌ی استفاده از آن گسترده نباشد.

  • وابستگی به پلتفرم X

چون Grok به‌طور مستقیم با شبکه‌ی X (توییتر) در ارتباط است، ممکن است نسبت به تصمیمات یا تغییرات این پلتفرم آسیب‌پذیر باشد. اگر مشکلی در X پیش بیاید یا محدودیتی اعمال شود، عملکرد Grok هم ممکن است تحت تأثیر قرار گیرد.

آینده‌ی Grok

گرچه هنوز Grok در مراحل اولیه قرار دارد، اما چند نکته درباره آینده‌ی آن قابل توجه است:

هوش مصنوعی Grok

  • برنامه‌های آینده xAI

شرکت xAI اعلام کرده که قصد دارد Grok را هوشمندتر، دقیق‌تر و کاربردی‌تر کند. به‌مرور، نسخه‌های پیشرفته‌تری از Grok منتشر خواهد شد که توانایی‌های بیشتری در درک زبان، تحلیل داده و حتی شخصی‌سازی گفت‌وگوها خواهند داشت.

  • رقابت در بازار هوش مصنوعی

Grok وارد میدان رقابت با غول‌هایی مانند ChatGPT، Gemini و Claude شده است. اگرچه در حال حاضر از نظر دقت و تنوع کاربرد، کمی عقب‌تر است، اما با توجه به منابع گسترده‌ای که پشت آن است (به‌ویژه پشتیبانی از سوی ایلان ماسک)، ممکن است به‌زودی جایگاه مهم‌تری پیدا کند.

  • نقش کاربران در بهبود مدل

هرچه کاربران بیشتری از Grok استفاده کنند، این مدل می‌تواند بازخورد بگیرد و هوشمندتر شود. رفتار کاربران، سبک پرسش‌ها و نیازهای آن‌ها، همگی در بهینه‌سازی مدل نقش دارند.

  • تلفیق با فناوری‌های دیگر

در آینده ممکن است Grok با ابزارهایی مانند خودروهای خودران، ربات‌های خانگی، یا حتی سیستم‌های آموزشی ترکیب شود. این تلفیق می‌تواند تجربه‌ی استفاده از هوش مصنوعی را شخصی‌تر و کاربردی‌تر کند.

  • دغدغه‌های اخلاقی و نظارتی

همزمان با رشد Grok، بحث‌های اخلاقی و حقوقی نیز بیشتر خواهد شد. از جمله اینکه چه داده‌هایی مجاز هستند، آیا مدل بی‌طرف باقی می‌ماند یا نه، و چگونه باید از سوءاستفاده از این ابزار جلوگیری کرد.

جمع‌بندی

هوش مصنوعی در حال تبدیل شدن به یکی از اصلی‌ترین ابزارهای زندگی روزمره ماست، و Grok یکی از تازه‌ترین نمونه‌های آن است. این مدل که توسط شرکت xAI و با هدایت ایلان ماسک ساخته شده، سعی دارد گفت‌وگو با هوش مصنوعی را واقعی‌تر، به‌روزتر و حتی سرگرم‌کننده‌تر کند.

در طول این مقاله از دیجی بینو دیدیم که Grok چه ویژگی‌هایی دارد، چه تفاوتی با مدل‌های دیگر مثل ChatGPT و Gemini دارد، و در چه زمینه‌هایی می‌تواند مفید باشد. همچنین به چالش‌ها، انتقادات و آینده‌ی احتمالی آن پرداختیم.

در نهایت، می‌توان گفت که Grok هنوز در حال رشد و توسعه است، اما پتانسیل بالایی دارد؛ به‌ویژه به‌خاطر اتصال مستقیم به پلتفرم X و سبک گفت‌وگوی متفاوتش. اینکه Grok بتواند در آینده جایگاه مهمی در بین ابزارهای هوش مصنوعی پیدا کند یا نه، تا حد زیادی به نحوه استفاده کاربران، کیفیت توسعه‌ی آن و اعتماد عمومی بستگی دارد.

نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

پنج نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

در دنیای امروز که ویدیوها بخش مهمی از زندگی دیجیتال ما را تشکیل می‌دهند، ویرایش فیلم دیگر فقط کار حرفه‌ای‌ها نیست. از تولیدکنندگان محتوا در یوتیوب و اینستاگرام گرفته تا معلمان و صاحبان کسب‌وکارهای کوچک، همه به نوعی با ادیت ویدیو سر و کار دارند. اما گاهی ویرایش فیلم زمان‌بر و پیچیده به نظر می‌رسد.

اینجاست که هوش مصنوعی وارد عمل می‌شود. هوش مصنوعی یا همان AI ، به زبان ساده یعنی توانایی کامپیوتر برای انجام کارهایی که قبلاً فقط انسان می‌توانست انجام دهد، مثل تشخیص چهره، درک صدا یا تصمیم‌گیری. این فناوری حالا به کمک ویرایش ویدیو آمده تا کار را سریع‌تر، ساده‌تر و حرفه‌ای‌تر کند.

در این مقاله، قرار است با پنج نرم‌افزار ادیت فیلم به کمک هوش مصنوعی آشنا شویم که از هوش مصنوعی برای ویرایش فیلم استفاده می‌کنند. این ابزارها می‌توانند به شما کمک کنند تا ویدیوهای بهتری بسازید، حتی اگر تجربه زیادی در تدوین نداشته باشید.

 چرا هوش مصنوعی در ویرایش فیلم مهم شده است؟

در گذشته، برای ویرایش یک فیلم کوتاه ممکن بود ساعت‌ها یا حتی روزها زمان صرف شود. کارهایی مثل برش صحنه‌ها، تنظیم نور و رنگ، حذف نویز صدا یا ساخت زیرنویس، همگی به مهارت و دقت بالا نیاز داشتند. اما امروزه با پیشرفت هوش مصنوعی، بسیاری از این کارها را می‌توان با چند کلیک ساده انجام داد.

هوش مصنوعی به‌طور خودکار و با دقت بالا می‌تواند تشخیص دهد که کدام صحنه مهم‌تر است، یا حتی کجا باید افکت خاصی اعمال شود. مثلاً اگر در یک ویدیو چند نفر صحبت می‌کنند، سیستم هوشمند می‌تواند به‌راحتی صدای هر فرد را جدا کند، زیرنویس دقیق بنویسد و حتی حرکت لب را با متن هماهنگ کند.

یکی از مزایای اصلی استفاده از AI در ویرایش فیلم، صرفه‌جویی در زمان است. کاری که قبلاً چند ساعت زمان می‌برد، حالا ممکن است در چند دقیقه انجام شود. همچنین دقت کار بالا می‌رود و احتمال خطاهای انسانی کمتر می‌شود.

دیگر ویژگی جذاب این فناوری، سادگی استفاده است. امروزه نرم‌افزارهایی وجود دارند که فقط با وارد کردن یک متن، برای شما یک ویدیوی کامل می‌سازند. یا ابزارهایی که پس‌زمینه ویدیو را بدون نیاز به پرده سبز، حذف می‌کنند.

با توجه به این مزایا، عجیب نیست که هوش مصنوعی به یکی از ابزارهای اصلی در ویرایش فیلم تبدیل شده و روز به روز محبوب‌تر می‌شود.

معرفی پنج نرم‌افزار برتر ویرایش فیلم با کمک هوش مصنوعی

در دنیای پرسرعت امروزی، نرم‌افزارهایی که کار ویرایش فیلم را ساده‌تر و سریع‌تر می‌کنند، بسیار ارزشمند هستند. در ادامه، پنج نرم‌افزار هوشمند را بررسی می‌کنیم که با استفاده از فناوری هوش مصنوعی، تدوین ویدیو را حتی برای مبتدیان هم ممکن کرده‌اند.

 Runway ML

Runway ML یک نرم‌افزار قدرتمند ابری (cloud-based) است که امکانات متنوعی برای ویرایش ویدیو با استفاده از مدل‌های یادگیری ماشین ارائه می‌دهد. این پلتفرم بیشتر برای پروژه‌های هنری، خلاقانه و محتوای دیجیتال استفاده می‌شود.

نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

ویژگی‌های برجسته:

قابلیت حذف پس‌زمینه و سوژه‌ها بدون نیاز به پرده سبز.

افکت‌های هوشمند مثل تار کردن پس‌زمینه، تعویض آسمان، تغییر سبک بصری.

امکان ایجاد ویدیوهای سورئال با مدل‌های هوش مصنوعی مانند Stable Diffusion یا StyleGAN

کاربردها:

افرادی که در زمینه‌ی طراحی گرافیکی، تولید محتوا یا تبلیغات فعالیت می‌کنند.

ساخت کلیپ‌های کوتاه با ظاهر حرفه‌ای بدون نیاز به تجهیزات پیشرفته.

 Adobe Premiere Pro (با فناوری Sensei)

Premiere Pro نرم‌افزاری است که اغلب فیلم‌سازان، تدوین‌گران و تولیدکنندگان محتوای حرفه‌ای از آن استفاده می‌کنند. Adobe با اضافه کردن فناوری Sensei به این نرم‌افزار، آن را هوشمندتر و کارآمدتر کرده است.

نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

امکانات هوش مصنوعی در Premiere Pro:

تنظیم خودکار رنگ و نور بر اساس صحنه.

Auto Reframe برای تنظیم اندازه تصویر برای شبکه‌های مختلف (مثلاً یوتیوب، اینستاگرام، تیک‌تاک).

حذف خودکار نویز صدا و انتخاب بهترین لحظات.

ساخت زیرنویس به‌صورت خودکار از فایل صوتی یا ویدیویی.

برای چه کسانی مناسب است؟

کاربران حرفه‌ای که به امکانات پیشرفته نیاز دارند.

کسانی که پروژه‌های طولانی و سنگین ویرایش می‌کنند.

تولیدکنندگان فیلم، ویدیوهای تبلیغاتی و یوتیوبرهای حرفه‌ای.

Descript

اگر دنبال راهی ساده و سریع برای تدوین ویدیوهای گفتاری مثل پادکست‌ها، ویدیوهای آموزشی یا مصاحبه‌ها هستید، Descript انتخاب هوشمندانه‌ای است.

چرا Descript خاص است؟

با تبدیل صدای ویدیو به متن، به شما این امکان را می‌دهد که فقط با ویرایش متن، ویدیو را هم ویرایش کنید.

حذف سکوت‌های طولانی یا کلمات زائد مثل «اِممم» به‌صورت خودکار.

تولید صدای مصنوعی از صدای شما با استفاده از تکنولوژی “Overdub”

مناسب چه افرادی است؟

کسانی که می‌خواهند سریع و ساده تدوین انجام دهند.

مدرسان آنلاین، پادکسترها، بلاگرها و سازندگان ویدیوهای آموزشی.

 Pictory

Pictory به شما اجازه می‌دهد از طریق متن، ویدیو بسازید. کافی است اسکریپت یا مقاله‌ی خود را وارد کنید، و این نرم‌افزار بر اساس آن تصاویر و کلیپ‌های مناسب را انتخاب کرده و یک ویدیوی کامل تولید می‌کند.

نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

امکانات کلیدی:

تبدیل مقاله یا متن به ویدیو در چند دقیقه.

افزودن خودکار زیرنویس، لوگو و موسیقی.

کتابخانه بزرگی از تصاویر و ویدیوهای آماده برای استفاده.

کاربردها:

بازاریاب‌های محتوا و دیجیتال مارکترها.

بلاگرها و افرادی که می‌خواهند از نوشته‌هایشان ویدیو بسازند.

مناسب برای تولید محتوای یوتیوب و اینستاگرام بدون نیاز به فیلم‌برداری.

Magisto

Magisto یک اپلیکیشن موبایلی است که ویرایش فیلم را به‌صورت تمام‌خودکار انجام می‌دهد. این برنامه برای کسانی طراحی شده که وقت یا مهارت تدوین ندارند اما می‌خواهند ویدیوی جذاب و تاثیرگذار بسازند.

نرم‌افزار ادیت فیلم به کمک هوش مصنوعی

ویژگی‌های هوشمند:

تحلیل خودکار محتوای تصویری و انتخاب بهترین صحنه‌ها.

تنظیم موزیک، افکت و برش صحنه‌ها به شکل خودکار.

تولید سریع ویدیو برای مناسبت‌های خاص، تبلیغات، معرفی محصول و…

مناسب برای:

کاربران شبکه‌های اجتماعی.

صاحبان کسب‌وکارهای کوچک.

افرادی که می‌خواهند روی گوشی خود به‌سرعت ویدیو بسازند.

مقایسه و جمع‌بندی نرم‌افزارها

نرم‌افزارهای معرفی‌شده در این مقاله هرکدام برای نیازهای خاصی طراحی شده‌اند.

اگر کار حرفه‌ای انجام می‌دهید و به امکانات پیشرفته نیاز دارید، Adobe Premiere Pro با کمک هوش مصنوعی Sensei بهترین انتخاب است. اگر به‌دنبال ابزار خلاقانه برای حذف پس‌زمینه یا افکت‌های خاص هستید، Runway ML را امتحان کنید.

برای تولیدکنندگان محتوای گفتاری، آموزشی یا پادکست، Descript یک راه‌حل ساده و متفاوت ارائه می‌دهد. در مقابل، اگر دنبال ساخت ویدیوی سریع و بدون دردسر هستید، Pictory برای تولید ویدیو از متن، و Magisto برای ساخت خودکار ویدیو در موبایل، گزینه‌های بسیار مناسبی هستند.

در کل، اگر تجربه و زمان کافی برای تدوین دارید، سراغ ابزارهای حرفه‌ای بروید؛ اما اگر به دنبال راهی ساده‌تر و سریع‌تر هستید، ابزارهای هوش مصنوعی کار را برایتان بسیار آسان کرده‌اند.

 نتیجه‌گیری

سیستم های هوش مصنوعی وارد دنیای ویرایش ویدیو شده اند و این کار را برای همه از مبتدی تا حرفه‌ای ساده‌تر کرده است. نرم‌افزارهایی مانند Premiere Pro و Runway ML برای کاربران حرفه‌ای امکانات پیشرفته‌ای فراهم می‌کنند، در حالی که ابزارهایی مثل Magisto، Descript و Pictory راه‌حل‌هایی ساده و سریع برای تولید محتوا ارائه می‌دهند.

انتخاب بهترین نرم‌افزار ادیت فیلم به کمک هوش مصنوعی به نیاز شما بستگی دارد: اگر دنبال کیفیت و کنترل کامل هستید، گزینه‌های حرفه‌ای مناسب‌ترند؛ اما اگر سرعت، سادگی و اتوماسیون برایتان مهم‌تر است، نرم‌افزارهای هوشمند سبک‌ کارتان را بسیار راحت‌تر می‌کنند.

در نهایت، هوش مصنوعی فرصت‌های تازه‌ای برای خلاقیت، صرفه‌جویی در زمان و تولید محتوای جذاب فراهم کرده است. فرصتی که بهتر است از آن استفاده کنیم.