Nvidia NGC

معرفی Nvidia NGC

Nvidia DSX platform در سال‌های اخیر به یکی از مهم‌ترین زیرساخت‌های سازمانی برای اجرای پروژه‌های هوش مصنوعی و پردازش‌های سنگین تبدیل شده است. در کنار این زیرساخت قدرتمند، Nvidia NGC به‌عنوان اکوسیستم نرم‌افزاری رسمی شرکت NVIDIA نقش کلیدی در توسعه، آموزش، استقرار و مدیریت مدل‌های هوش مصنوعی ایفا می‌کند. این پلتفرم مجموعه‌ای از کانتینرهای بهینه‌شده، مدل‌های از پیش آموزش‌دیده، SDKهای تخصصی، فریم‌ورک‌های محبوب و ابزارهای حرفه‌ای را در اختیار توسعه‌دهندگان قرار می‌دهد تا بدون درگیر شدن با پیچیدگی‌های نصب و پیکربندی، پروژه‌های خود را با حداکثر کارایی اجرا کنند.

امروزه سازمان‌ها برای آموزش مدل‌های زبانی بزرگ (LLM)، بینایی ماشین، پردازش زبان طبیعی، تحلیل داده‌های حجیم و شبیه‌سازی‌های علمی به زیرساختی نیاز دارند که علاوه بر قدرت پردازشی بالا، از نظر نرم‌افزاری نیز کاملاً بهینه باشد. Nvidia NGC دقیقاً با همین هدف طراحی شده است. زمانی که این پلتفرم در کنار Nvidia DSX platform قرار می‌گیرد، محیطی یکپارچه برای توسعه پروژه‌های هوش مصنوعی ایجاد می‌شود که هم از نظر عملکرد و هم از نظر مقیاس‌پذیری، پاسخگوی نیاز شرکت‌های بزرگ و مراکز تحقیقاتی است.

 Nvidia NGC چیست و چرا اهمیت زیادی دارد؟

NVIDIA GPU Cloud  یا همان Nvidia NGC  یک پلتفرم نرم‌افزاری مبتنی بر فضای ابری است که توسط شرکت NVIDIA توسعه یافته تا فرآیند ساخت، آموزش و استقرار مدل‌های هوش مصنوعی را ساده‌تر کند. این پلتفرم در حقیقت یک مخزن دانلود ساده نیست، بلکه اکوسیستمی کامل از ابزارهای تخصصی هوش مصنوعی محسوب می‌شود.

در گذشته توسعه‌دهندگان مجبور بودند نسخه‌های مختلف  CUDA، cuDNN، TensorRT، PyTorch، TensorFlow  و سایر کتابخانه‌ها را به‌صورت دستی نصب و هماهنگ کنند. این فرآیند علاوه بر زمان‌بر بودن، احتمال بروز خطا و ناسازگاری را نیز افزایش می‌داد. Nvidia NGC این مشکل را با ارائه کانتینرهای آماده برطرف کرده است.

از طرف دیگر، بسیاری از سازمان‌هایی که از Nvidia DSX platform  استفاده می‌کنند، به محیطی نیاز دارند که بتواند حداکثر توان  GPUهای حرفه‌ای مانند سری H100 ، B200، RTX PRO و Blackwell را در اختیار آن‌ها قرار دهد. Nvidia NGC  دقیقاً برای همین منظور طراحی شده و تمامی ابزارهای موجود در آن توسط مهندسان NVIDIA تست و بهینه‌سازی شده‌اند.

قابلیت‌های Nvidia NGC در کنار Nvidia DSX platform

یکی از مهم‌ترین دلایل محبوبیت  Nvidia NGC، تنوع بالای ابزارها و سرویس‌هایی است که در اختیار کاربران قرار می‌دهد. این پلتفرم تقریباً تمام نیازهای توسعه‌دهندگان سیستم های هوش مصنوعی را پوشش می‌دهد و باعث می‌شود تیم‌های فنی بتوانند با سرعت بیشتری پروژه‌های خود را توسعه دهند.

Nvidia NGC

مهم‌ترین امکانات Nvidia NGC عبارت‌اند از:

  • کانتینرهای Docker کاملاً بهینه‌شده برای  GPU
  • مدل‌های آماده هوش مصنوعی
  • فریم‌ورک‌های  TensorFlow، PyTorch، MXNet و RAPIDS
  • کتابخانه‌های CUDA و cuDNN
  • TensorRT  برای افزایش سرعت استنتاج
  • Triton Inference Server  برای استقرار مدل‌ها
  • NVIDIA NeMo  برای توسعه مدل‌های زبانی بزرگ
  •  NVIDIA TAO Toolkit برای آموزش مدل‌ها بدون نیاز به کدنویسی پیچیده
  • ابزارهای مانیتورینگ GPU
  • SDKهای تخصصی پردازش تصویر، ویدئو و گفتار

زمانی که این مجموعه نرم‌افزاری روی Nvidia DSX platform ا جرا می‌شود، کاربران می‌توانند بدون نیاز به نصب دستی نرم‌افزارها، تنها در چند دقیقه محیط توسعه خود را آماده کنند. این موضوع زمان آماده‌سازی پروژه را به شکل محسوسی کاهش می‌دهد.

مزایای استفاده از Nvidia NGC روی Nvidia DSX platform

ترکیب Nvidia NGC با Nvidia DSX platform  مزایای فراوانی برای شرکت‌ها، دانشگاه‌ها و مراکز تحقیقاتی دارد. مهم‌ترین مزیت این راهکار، یکپارچگی کامل سخت‌افزار و نرم‌افزار است.

از مهم‌ترین مزایای این ترکیب می‌توان به موارد زیر اشاره کرد:

  • راه‌اندازی سریع محیط توسعه
  • حذف مشکلات ناسازگاری نسخه‌های نرم‌افزاری
  • بهره‌برداری حداکثری از توان GPU
  • بهینه‌سازی برای آموزش مدل‌های بسیار بزرگ
  • پشتیبانی از اجرای هم‌زمان چندین پروژه
  • امنیت بالا در سطح سازمانی
  • بروزرسانی منظم کانتینرها
  • استقرار آسان روی Kubernetes
  • امکان اجرا در دیتاسنتر یا فضای ابری
  • کاهش هزینه‌های نگهداری زیرساخت

به کمک این مزایا، سازمان‌ها می‌توانند پروژه‌های پیچیده هوش مصنوعی را با سرعت بیشتر و هزینه کمتر توسعه دهند. همچنین توسعه‌دهندگان زمان خود را به جای رفع مشکلات نرم‌افزاری، صرف طراحی مدل‌ها و بهینه‌سازی الگوریتم‌ها می‌کنند.

کاربردهای Nvidia NGC در پروژه‌های سازمانی با Nvidia DSX platform

Nvidia NGC  در صنایع مختلف کاربرد دارد و تقریباً هر پروژه‌ای که به پردازش GPU نیاز داشته باشد، می‌تواند از این پلتفرم بهره ببرد.

Nvidia NGC

برخی از مهم‌ترین کاربردها عبارت‌اند از:

  • آموزش مدل‌های یادگیری عمیق
  • توسعه مدل‌ها ی مولد هوش مصنوعی (Generative AI)
  • پردازش زبان طبیعی (NLP)
  • بینایی ماشین
  • تشخیص اشیا
  • تحلیل تصاویر پزشکی
  • خودروهای خودران
  • رباتیک
  • پردازش داده‌های مالی
  • تحلیل داده‌های بزرگ
  • شبیه‌سازی‌های علمی
  • مدل‌سازی آب‌وهوا
  • تحقیقات دانشگاهی
  • محاسبات HPC

در تمامی این کاربردها، Nvidia DSX platform نقش موتور پردازشی را بر عهده دارد و Nvidia NGC ابزارهای مورد نیاز برای آموزش و استقرار مدل‌ها را فراهم می‌کند.

چرا سازمان‌های بزرگ از Nvidia NGC استفاده می‌کنند؟

امروزه بسیاری از شرکت‌های فعال در حوزه هوش مصنوعی، مراکز تحقیقاتی و ارائه‌دهندگان خدمات ابری از Nvidia NGC استفاده می‌کنند. دلیل اصلی این موضوع، کاهش زمان توسعه پروژه‌ها و افزایش بهره‌وری تیم‌های فنی است.

پشتیبانی رسمی   NVIDIA، بروزرسانی مداوم، امنیت بالا، عملکرد پایدار و سازگاری کامل با جدیدترین معماری‌های GPU باعث شده است Nvidia NGC  به انتخاب اول بسیاری از سازمان‌ها تبدیل شود.

از سوی دیگر، زمانی که این پلتفرم روی  Nvidia DSX platform اجرا می‌شود، مدیران زیرساخت می‌توانند منابع پردازشی را به‌صورت متمرکز مدیریت کرده و پروژه‌های مختلف را بدون افت عملکرد اجرا کنند. این ویژگی برای شرکت‌هایی که چندین تیم توسعه هوش مصنوعی دارند، اهمیت بسیار زیادی دارد.

تفاوت Nvidia NGC با نصب سنتی ابزارهای هوش مصنوعی

در روش سنتی، توسعه‌دهندگان باید هر یک از ابزارهای موردنیاز مانند  CUDA، cuDNN، TensorFlow، PyTorch  و سایر کتابخانه‌ها را جداگانه نصب و پیکربندی کنند. این فرآیند علاوه بر صرف زمان زیاد، احتمال بروز ناسازگاری میان نسخه‌ها را نیز افزایش می‌دهد.

Nvidia NGC

اما در Nvidia NGC، تمامی این ابزارها به‌صورت یکپارچه و از پیش بهینه‌سازی‌شده در قالب کانتینرهای آماده ارائه می‌شوند. این رویکرد نه‌تنها سرعت راه‌اندازی پروژه را افزایش می‌دهد، بلکه عملکرد مدل‌ها را نیز بهبود می‌بخشد. هنگامی که این کانتینرها روی Nvidia DSX platform  اجرا می‌شوند، توسعه‌دهندگان می‌توانند بدون نگرانی از تنظیمات پیچیده، از حداکثر توان پردازشی GPUها بهره ببرند.

سخن آخر

Nvidia NGC یکی از کامل‌ترین اکوسیستم‌های نرم‌افزاری برای توسعه، آموزش و استقرار پروژه‌های هوش مصنوعی است. این پلتفرم با ارائه کانتینرهای آماده، مدل‌های از پیش آموزش‌دیده، SDKهای تخصصی و ابزارهای بهینه‌شده، فرآیند توسعه را سریع‌تر، ساده‌تر و مطمئن‌تر می‌کند.

در کنار آن، Nvidia DSX platform  به‌عنوان زیرساخت سخت‌افزاری قدرتمند، بستری مناسب برای اجرای پروژه‌های سنگین هوش مصنوعی، یادگیری عمیق و محاسبات HPC فراهم می‌آورد. ترکیب این دو راهکار، محیطی یکپارچه، پایدار و مقیاس‌پذیر ایجاد می‌کند که پاسخگوی نیاز شرکت‌های فناوری، مراکز داده، دانشگاه‌ها و سازمان‌های بزرگ است.

اگر هدف شما ایجاد زیرساختی حرفه‌ای برای پروژه‌های هوش مصنوعی، مدل‌های زبانی بزرگ، پردازش تصویر یا تحلیل داده‌های حجیم است، استفاده از Nvidia NGC در کنار Nvidia DSX platform  یکی از بهترین و آینده‌نگرانه‌ترین انتخاب‌های موجود خواهد بود.
معماری Blackwell

معرفی معماری Black well

معماری Blackwell نقطه عطف جدیدی در دنیای پردازش‌های هوش مصنوعی و محاسبات سنگین محسوب می‌شود و انویدیا با معرفی این معماری، فصل تازه‌ای در توسعه مراکز داده، مدل‌های زبانی بزرگ و پردازش‌های گرافیکی پیشرفته آغاز کرده است. در سال‌های اخیر رشد سریع هوش مصنوعی باعث شده نیاز به سخت‌افزارهای قدرتمندتر از همیشه احساس شود و به همین دلیل معماری Black well با هدف ارائه توان پردازشی بیشتر، مصرف انرژی بهینه‌تر و عملکرد بالاتر طراحی شده است.

این معماری که جانشین نسل Hopper محسوب می‌شود، نه تنها در زمینه آموزش مدل‌های هوش مصنوعی عملکرد فوق‌العاده‌ای ارائه می‌دهد، بلکه برای استنتاج (Inference)، تحلیل داده‌های عظیم و پردازش‌های علمی نیز گزینه‌ای ایده‌آل به شمار می‌رود. بسیاری از شرکت‌های فعال در حوزه هوش مصنوعی، رایانش ابری و مراکز داده اکنون توجه ویژه‌ای به معماری Blackwell دارند.

معماری Blackwell چیست؟

معماری Blackwell جدیدترین معماری پردازشی شرکت انویدیا است که برای پاسخگویی به نیازهای نسل آینده هوش مصنوعی توسعه یافته است. این معماری به افتخار ریاضیدان برجسته آمریکایی «دیوید بلک‌ول» نام‌گذاری شده و تمرکز اصلی آن بر افزایش توان پردازش مدل‌های هوش مصنوعی در مقیاس بسیار بزرگ است.

در معماری Blackwell از فناوری‌های پیشرفته‌ای استفاده شده که امکان پردازش تریلیون‌ها پارامتر را فراهم می‌کند. این موضوع برای مدل‌های زبانی بزرگ، سیستم‌های مولد محتوا، پردازش تصویر، بینایی ماشین و تحلیل داده اهمیت بسیار زیادی دارد.

معماری Blackwell

یکی از مهم‌ترین ویژگی‌های این معماری، استفاده از طراحی چند تراشه‌ای یا Multi-Die است. در این ساختار، چندین بخش پردازشی از طریق ارتباطات فوق سریع به یکدیگر متصل می‌شوند و مانند یک پردازنده واحد عمل می‌کنند. این روش باعث افزایش چشمگیر کارایی و بهره‌وری می‌شود.

علاوه بر این، معماری Blackwell از نسل جدید Tensor Core ها بهره می‌برد که برای پردازش عملیات مرتبط با هوش مصنوعی طراحی شده‌اند. این هسته‌ها عملکرد مدل‌های یادگیری عمیق را به شکل قابل توجهی افزایش می‌دهند و زمان آموزش مدل‌ها را کاهش می‌دهند.

ویژگی‌های مهم معماری Blackwell

یکی از دلایل اهمیت معماری Blackwell مجموعه‌ای از قابلیت‌های فنی پیشرفته آن است که نسبت به نسل قبل پیشرفت چشمگیری دارند.

اولین ویژگی مهم، افزایش توان پردازشی است. پردازنده‌های مبتنی بر این معماری قادر هستند حجم عظیمی از داده‌ها را در زمان بسیار کوتاه پردازش کنند. این موضوع برای مراکز داده و شرکت‌های فعال در حوزه هوش مصنوعی اهمیت حیاتی دارد.

دومین ویژگی، پشتیبانی از محاسبات FP4 است. این فناوری امکان اجرای مدل‌های هوش مصنوعی را با دقت مناسب و سرعت بسیار بالاتر فراهم می‌کند. نتیجه این موضوع کاهش هزینه پردازش و افزایش بهره‌وری مراکز داده خواهد بود.

سومین ویژگی، ارتباط فوق سریع میان تراشه‌ها است. فناوری NVLink در این نسل ارتقا یافته و پهنای باند بسیار بیشتری نسبت به نسل Hopper ارائه می‌دهد. این مسئله باعث می‌شود چندین پردازنده گرافیکی بتوانند به‌صورت هماهنگ روی پروژه‌های عظیم هوش مصنوعی فعالیت کنند.

ویژگی دیگر معماری Blackwell کاهش مصرف انرژی در مقایسه با قدرت پردازشی ارائه شده است. شرکت‌ها اکنون می‌توانند با مصرف انرژی کمتر، مدل‌های بزرگ‌تر و پیچیده‌تری را اجرا کنند که از نظر اقتصادی اهمیت فراوانی دارد.

D:\digibino\posts\معرفی معماری Black well

معماری Black well و نقش آن در توسعه هوش مصنوعی

امروزه رشد سریع هوش مصنوعی باعث شده نیاز به سخت‌افزارهای قدرتمند به شدت افزایش پیدا کند. معماری Blackwell دقیقاً برای پاسخ به این نیاز طراحی شده است.

مدل‌های زبانی مدرن مانند سیستم‌های تولید متن، تصویر و ویدئو به میلیاردها یا حتی تریلیون‌ها پارامتر نیاز دارند. پردازش چنین مدل‌هایی بدون استفاده از سخت‌افزارهای قدرتمند تقریباً غیرممکن است. معماری Blackwell با ارائه قدرت پردازشی فوق‌العاده، امکان آموزش و اجرای این مدل‌ها را فراهم می‌کند.

یکی دیگر از مزایای مهم این معماری، بهبود فرآیند استنتاج است. بسیاری از سرویس‌های هوش مصنوعی روزانه میلیون‌ها درخواست کاربران را پردازش می‌کنند. هرچه سرعت استنتاج بیشتر باشد، کاربران پاسخ سریع‌تری دریافت می‌کنند و هزینه‌های عملیاتی کاهش می‌یابد.

همچنین معماری Blackwell در حوزه‌هایی مانند خودروهای خودران، پزشکی، امنیت سایبری، شبیه‌سازی‌های علمی و تحلیل داده‌های کلان نیز کاربرد گسترده‌ای دارد. این معماری می‌تواند حجم عظیمی از داده‌ها را در مدت زمان کوتاهی پردازش کند و تصمیم‌گیری هوشمند را بهبود دهد.

کارشناسان معتقدند معماری Blackwell یکی از مهم‌ترین زیرساخت‌های نسل آینده هوش مصنوعی خواهد بود و بسیاری از فناوری‌های نوظهور بر پایه توان پردازشی آن توسعه پیدا خواهند کرد.

مقایسه معماری Blackwell با معماری Hopper

برای درک بهتر ارزش معماری Blackwell باید آن را با نسل قبلی یعنی Hopper مقایسه کنیم.

معماری Hopper در زمان معرفی خود تحول بزرگی در صنعت پردازش هوش مصنوعی ایجاد کرد، اما افزایش ابعاد مدل‌های زبانی باعث شد نیاز به نسل جدیدی از پردازنده‌ها به وجود آید. معماری Blackwell دقیقاً برای رفع این محدودیت‌ها توسعه پیدا کرده است.

در بخش قدرت پردازش، نسل جدید چندین برابر عملکرد بالاتری ارائه می‌دهد. همچنین استفاده از فناوری FP4 باعث افزایش سرعت پردازش مدل‌های هوش مصنوعی شده است.

در زمینه ارتباط میان پردازنده‌ها نیز NVLink جدید پهنای باند بیشتری فراهم می‌کند. این موضوع برای خوشه‌های پردازشی بزرگ اهمیت بسیار زیادی دارد.

از نظر مصرف انرژی نیز معماری Blackwell عملکرد بهینه‌تری نسبت به Hopper ارائه می‌دهد. این مزیت به شرکت‌ها کمک می‌کند هزینه‌های عملیاتی خود را کاهش دهند و بهره‌وری بیشتری داشته باشند.

معماری Blackwell

به طور کلی می‌توان گفت معماری Blackwell نه تنها یک ارتقای ساده نیست، بلکه یک جهش بزرگ در دنیای پردازش‌های مبتنی بر هوش مصنوعی محسوب می‌شود.

آینده معماری Blackwell در صنعت فناوری

بسیاری از تحلیلگران معتقدند معماری Blackwell نقش مهمی در آینده صنعت فناوری ایفا خواهد کرد. افزایش تقاضا برای سیستم های هوش مصنوعی، رایانش ابری و پردازش داده‌های عظیم باعث شده نیاز به سخت‌افزارهای قدرتمندتر هر روز بیشتر شود.

شرکت‌های فعال در حوزه فناوری به دنبال زیرساخت‌هایی هستند که بتوانند حجم بالای پردازش را با هزینه مناسب انجام دهند. معماری Black well یکی از بهترین گزینه‌ها برای پاسخ به این نیاز است.

معماری Blackwell

علاوه بر مراکز داده، انتظار می‌رود این معماری در حوزه رباتیک، خودروهای هوشمند، شبیه‌سازی صنعتی، طراحی دارو، تحقیقات علمی و پردازش‌های مالی نیز کاربرد گسترده‌ای پیدا کند.

با توجه به روند فعلی بازار، معماری Blackwell احتمالاً به یکی از مهم‌ترین استانداردهای پردازش هوش مصنوعی در سال‌های آینده تبدیل خواهد شد و نقش کلیدی در توسعه نسل بعدی فناوری‌های مبتنی بر هوش مصنوعی ایفا می‌کند.

سخن آخر

معماری Blackwell را می‌توان یکی از مهم‌ترین دستاوردهای جدید صنعت پردازش گرافیکی و هوش مصنوعی دانست. این معماری با ارائه توان پردازشی بسیار بالا، مصرف انرژی بهینه، فناوری‌های جدید Tensor Core و ارتباطات پرسرعت میان تراشه‌ها، بستری مناسب برای توسعه نسل آینده هوش مصنوعی فراهم کرده است.

با گسترش کاربردهای هوش مصنوعی در صنایع مختلف، اهمیت سخت‌افزارهای قدرتمند بیش از گذشته شده است. در این میان، معماری Blackwell می‌تواند نقش کلیدی در آموزش مدل‌های بزرگ، پردازش داده‌های پیچیده و ارائه سرویس‌های هوشمند ایفا کند. به همین دلیل بسیاری از کارشناسان آن را یکی از مهم‌ترین فناوری‌های سال‌های اخیر در حوزه پردازش پیشرفته می‌دانند.

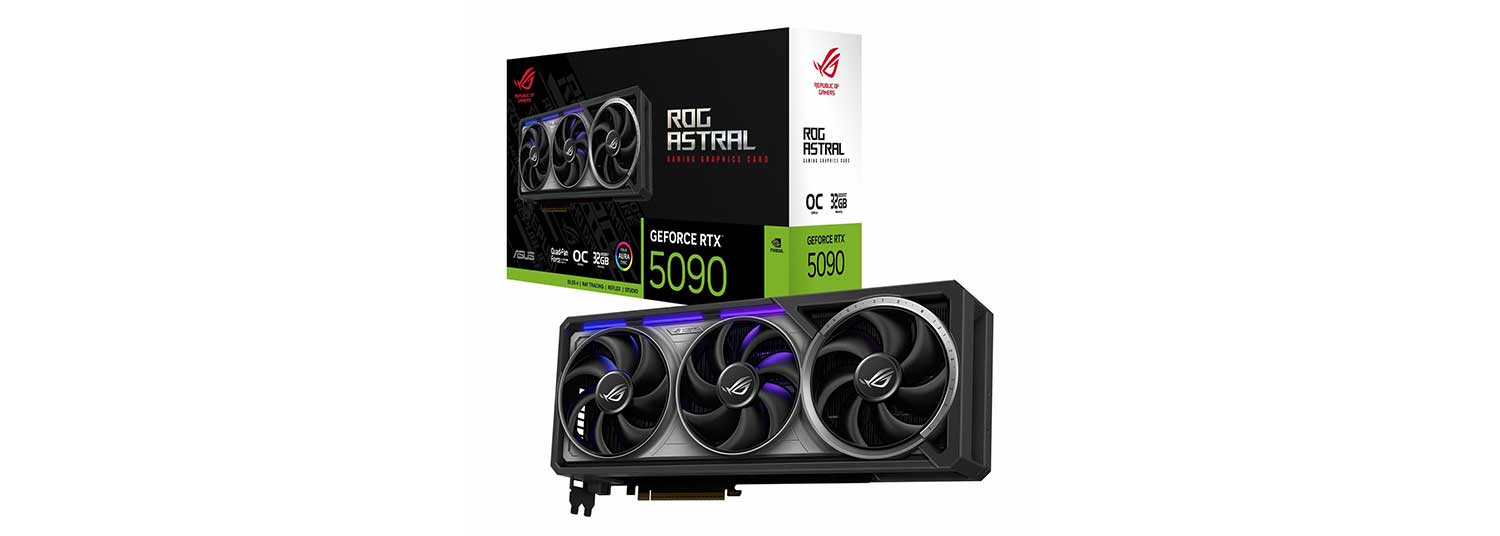
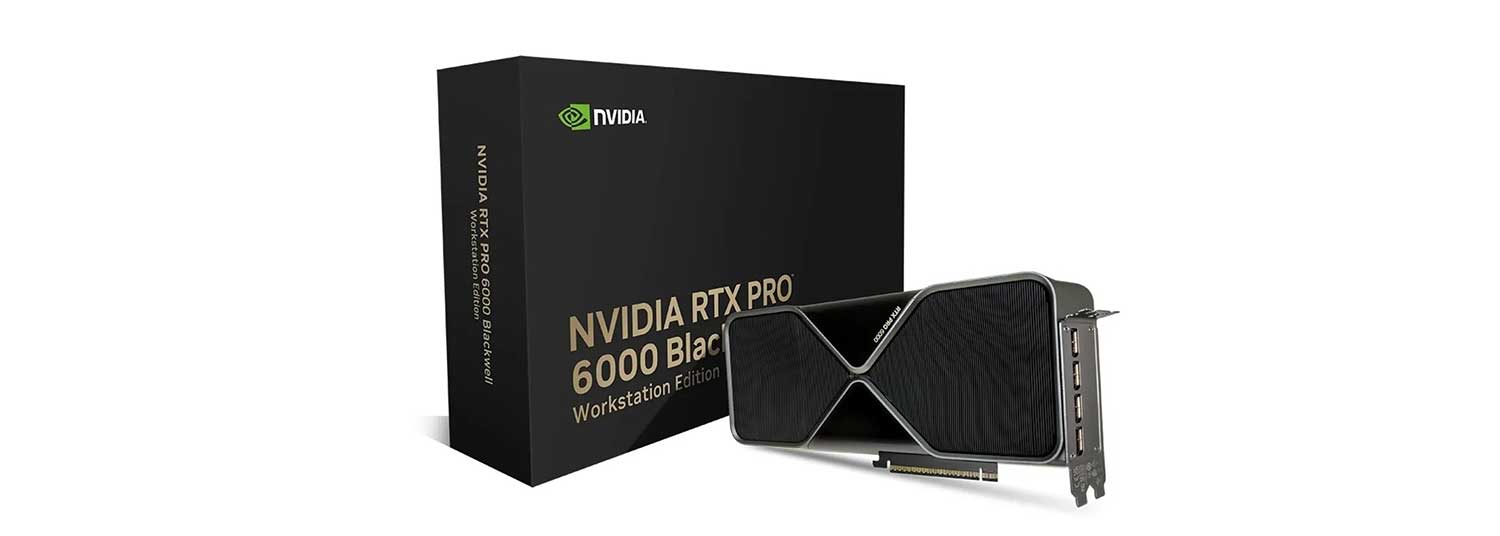
مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

پردازنده‌های گرافیکی امروزی تنها برای اجرای بازی‌های رایانه‌ای طراحی نشده‌اند. این قطعات، نقش اصلی را در پردازش‌های سنگین هوش مصنوعی، رندرینگ سه‌بعدی، شبیه‌سازی‌های علمی و تحلیل داده‌های کلان ایفا می‌کنند.

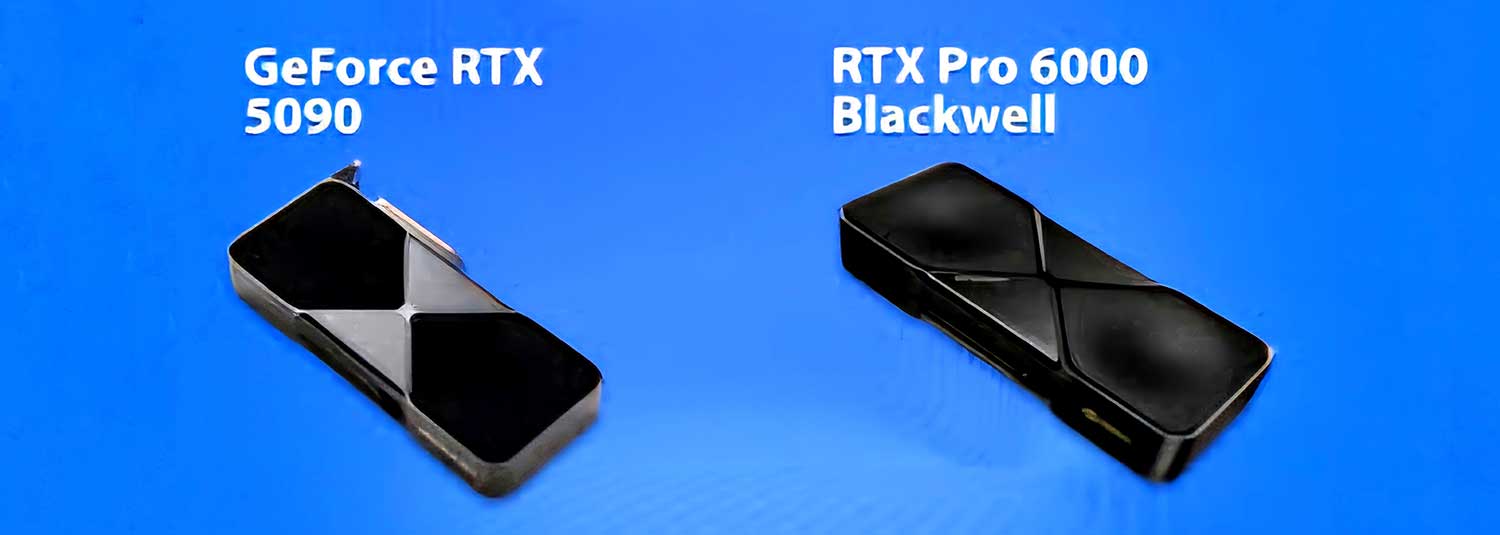
شرکت انویدیا با معرفی معماری جدید خود به نام بلک‌ول (Blackwell)، دو محصول برجسته را روانه بازار کرده است: یکی GeForce RTX 5090 که برای کاربران عادی، گیمرها و تولیدکنندگان محتوای حرفه‌ای طراحی شده، و دیگری RTX 6000 Pro Blackwell که در دسته محصولات ایستگاه‌های کاری حرفه‌ای و سرورهای سازمانی جای می‌گیرد.

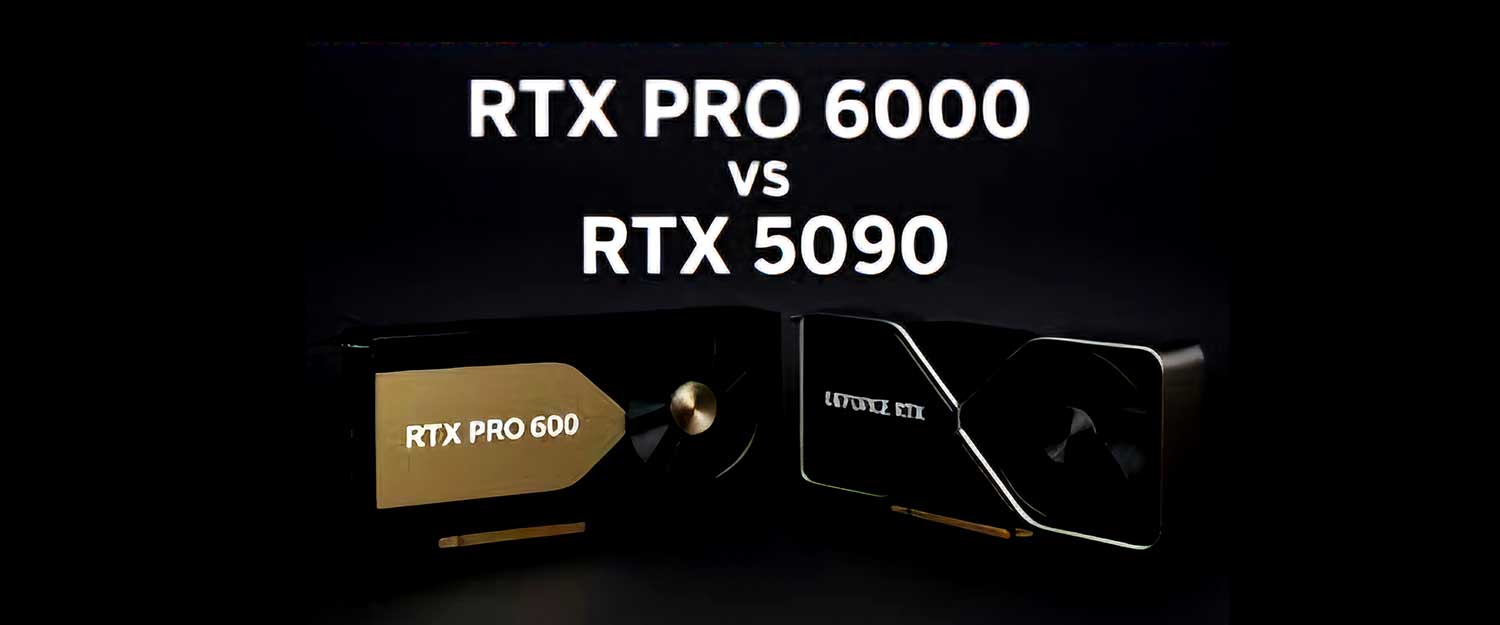
بسیاری از خریداران حرفه‌ای تصور می‌کنند که RTX 5090 به دلیل قیمت پایین‌تر، گزینه منطقی‌تری است، اما واقعیت آن است که این دو محصول تفاوت‌های بنیادینی در سخت‌افزار، حافظه، قابلیت‌های محاسباتی و کاربرد نهایی دارند. در ادامه به مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 می پردازیم.

معماری یکسان، اما پیکربندی متفاوت

هر دو کارت گرافیک بر پایه همان تراشه مرکزی یعنی GB202 ساخته شده‌اند که انویدیا آن را برای نسل بلک‌ول طراحی کرده است. با این حال، شرکت انویدیا برای محصولات حرفه‌ایی خود از تمام توان این تراشه استفاده می‌کند، در حالی که در نسخه مصرفی، برخی از واحدهای محاسباتی غیرفعال می‌شوند.

به عبارت دیگر، RTX 6000 Pro Blackwell از همه هسته‌های موجود روی تراشه بهره می‌برد، در حالی که RTX 5090 با تعدادی هسته کمتر عرضه می‌شود. این تفاوت در عمل به معنای برتری محسوس مدل حرفه‌ای در عملیات موازی و محاسبات سنگین است.

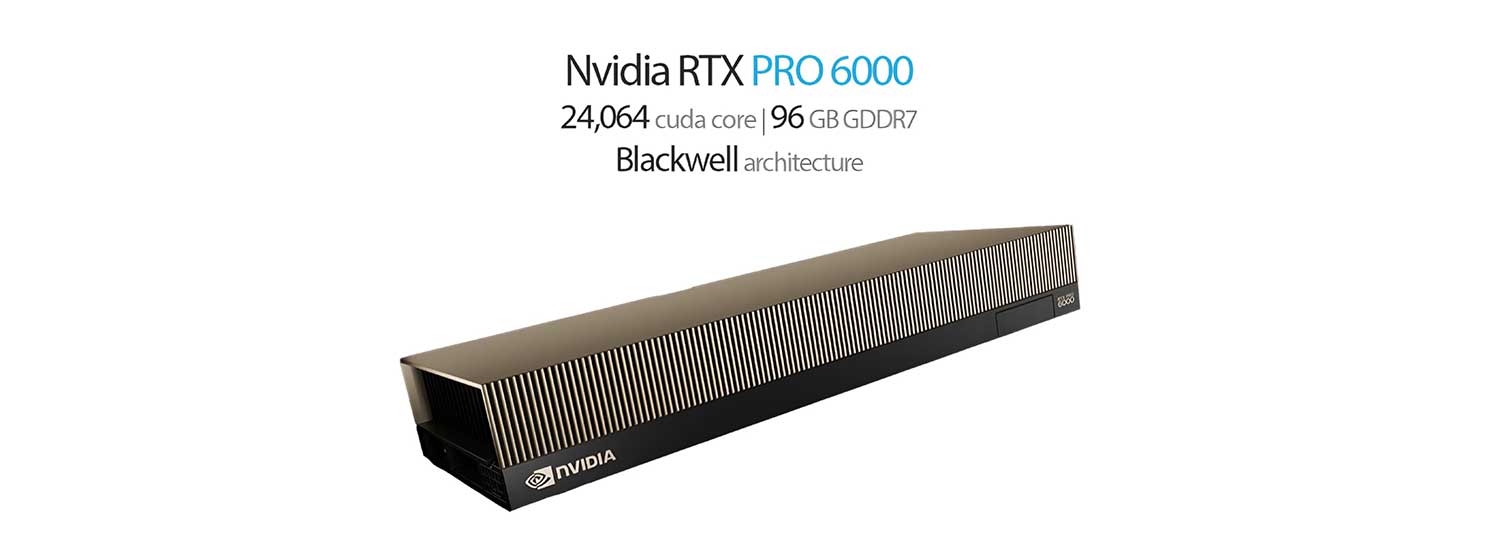
اگر به اعداد دقیق توجه کنیم، RTX 6000 Pro Blackwell دارای ۲۴,۰۶۴ هسته کودا (CUDA) است. این هسته‌ها واحدهای اصلی انجام محاسبات ممیز شناور هستند. در سوی مقابل، RTX 5090 به ۲۱,۷۶۰ هسته کودا مجهز شده است. بنابراین مدل حرفه‌ای حدود ۱۰٫۵ درصد هسته بیشتر دارد. همین نسبت در مورد هسته‌های تنسور نسل پنجم و هسته‌های رهگیری پرتو نسل چهارم نیز صادق است. هسته‌های تنسور در RTX 6000 Pro Blackwell تعداد ۷۵۲ واحد و در RTX 5090 تعداد ۶۸۰ واحد است. هسته‌های رهگیری پرتو نیز به ترتیب ۱۸۸ و ۱۷۰ عدد می‌باشند. این اختلاف اگرچه در نگاه اول کوچک به نظر می‌رسد، اما در بارهای کاری حرفه‌ای که روزها یا هفته‌ها طول می‌کشند، تفاوت چشمگیری در زمان اتمام محاسبات ایجاد می‌کند.

تفاوت حیاتی در حافظه گرافیکی (VRAM)

در مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 مهم‌ترین و تعیین‌کننده‌ترین تفاوت میان این دو محصول، مقدار و نوع حافظه گرافیکی است. RTX 5090 به ۳۲ گیگابایت حافظه از نوع GDDR7 مجهز شده است. این مقدار برای اجرای بازی‌های امروزی با وضوح ۴K و حتی ۸K و همچنین برای بسیاری از کارهای حرفه‌ای مانند ویرایش ویدیو یا رندر سه‌بعدی کاملاً مناسب است. اما RTX 6000 Pro Blackwell از ۹۶ گیگابایت حافظه GDDR7 بهره می‌برد. این مقدار دقیقاً سه برابر مدل مصرفی است. افزون بر این، حافظه مدل حرفه‌ای از قابلیت تصحیح خطا (ECC) پشتیبانی می‌کند. قابلیت ECC برای محاسبات علمی و مالی که حتی یک بیت خطا می‌تواند نتیجه نهایی را به کلی تغییر دهد، ضروری است. در حالی که RTX 5090 چنین قابلیتی ندارد.

این تفاوت سه برابری در حافظه، مرز میان «می‌توانم این کار را انجام دهم» و «نمی‌توانم انجام دهم» را تعیین می‌کند. برای مثال، اگر یک مهندس یا پژوهشگر بخواهد یک مدل بزرگ زبانی با ۷۰ میلیارد پارامتر را به صورت محلی اجرا کند، مدلی مانند Llama 3 70B به حدود ۶۰ تا ۷۰ گیگابایت حافظه گرافیکی نیاز دارد. RTX 5090 با ۳۲ گیگابایت حافظه، به هیچ وجه قادر به بارگذاری کامل این مدل نیست و کاربر مجبور است از روش‌های کاهش دقت یا پارتیشن‌بندی مدل روی چند کارت استفاده کند. اما RTX 6000 Pro Blackwell به راحتی این مدل را در خود جای می‌دهد و فضای کافی برای بافرها و داده‌های میانی نیز باقی می‌گذارد. به همین دلیل، در مراکز تحقیقاتی هوش مصنوعی و شرکت‌های بزرگ فناوری، مدل حرفه‌ای تقاضای بسیار بالایی دارد.

پهنای باند حافظه گرافیکی

در مورد پهنای باند حافظه، هر دو کارت از یک نسل حافظه و یک رابط مشابه بهره می‌برند و پهنای باند هر دو به ۱,۷۹۲ گیگابایت بر ثانیه می‌رسد. یعنی سرعت انتقال داده بین حافظه و پردازنده در هر دو کارت یکسان است. اما حجم بیشتر حافظه در RTX 6000 Pro Blackwell اجازه می‌دهد که مجموعه داده‌های بزرگتر بدون نیاز به تبادل مداوم با حافظه اصلی سیستم، درون خود کارت باقی بمانند. این ویژگی به ویژه در یادگیری ماشین و شبیه‌سازی‌های علمی که با دیتاست‌های چند ترابایتی سروکار دارند، بسیار ارزشمند است.

عملکرد محاسباتی و هوش مصنوعی

در حوزه محاسبات ممیز شناور با دقت تکی (FP32) که مبنای بسیاری از الگوریتم‌های علمی و مهندسی است، RTX 6000 Pro Blackwell عملکردی در حدود ۱۲۵ ترافلاپس ارائه می‌دهد. RTX 5090 نیز با حدود ۱۰۵ ترافلاپس، همچنان بسیار قدرتمند است اما از رقیب حرفه‌ای خود عقب می‌ماند. این اختلاف حدود ۱۹ درصدی در کنار اختلاف تعداد هسته‌ها، مدل حرفه‌ای را برای محاسبات سنگین و طولانی مدت مناسب‌تر می‌سازد.

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

اما تفاوت اصلی در محاسبات مرتبط با هوش مصنوعی و به ویژه دقت FP4 پدیدار می‌شود. معماری بلک‌ول قابلیت تازه‌ای به نام FP4 را به هسته‌های تنسور افزوده است. این دقت پایین، امکان پردازش مدل‌های بسیار بزرگ با مصرف حافظه کمتر و سرعت بالاتر را فراهم می‌کند. RTX 5090 در بار FP4 حدود ۸۳۸ ترا عملیات در ثانیه (TOPS) را ثبت می‌کند. این رقم برای بسیاری از برنامه‌های هوش مصنوعی در سطح یک ایستگاه کاری شخصی عالی است. اما RTX 6000 Pro Blackwell به لطف تعداد بیشتر هسته‌های تنسور و حافظه عظیم خود، تا ۴,۰۰۰ ترا عملیات در ثانیه دست می‌یابد. این عدد تقریبا ۴٫۸ برابر مدل مصرفی است. بنابراین هر پژوهشی که با مدل‌های بزرگ زبانی یا شبکه‌های عصبی عمیق سروکار داشته باشد، مدل حرفه‌ای را بسیار برتر خواهد یافت.

مصرف انرژی و خنک‌سازی

مصرف انرژی هر دو کارت بسیار بالاست و این موضوع برای کاربران خانگی و حرفه‌ای به یک اندازه چالش‌برانگیز است. RTX 5090 دارای توان مصرفی حداکثر ۵۷۵ وات است. RTX 6000 Pro Blackwell نیز توان مصرفی حدود ۶۰۰ وات دارد. بنابراین تفاوت محسوسی در مصرف انرژی میان این دو وجود ندارد. با این حال، مدل حرفه‌ای معمولاً با طراحی حرارتی انعطاف‌پذیرتری عرضه می‌شود و می‌توان آن را در محدوده‌ای بین ۴۵۰ تا ۶۰۰ وات پیکربندی کرد. این قابلیت در سرورها که دهها کارت در کنار یکدیگر کار می‌کنند، بسیار حیاتی است. در مقابل، RTX 5090 برای نصب در کیس‌های معمولی و با فن‌های اختصاصی خود طراحی شده و قابلیت کاهش مصرف به آن شکل را ندارد. همچنین خنک‌سازی RTX 6000 Pro Blackwell اغلب از نوع بلوئر (خروج هوا از پشت کارت) است تا هوای گرم مستقیماً از محفظه سرور خارج شود، در حالی که RTX 5090 از فن‌های محوری بزرگ استفاده می‌کند که هوای گرم را درون کیس پخش می‌کنند.

قابلیت‌های ویژه مدیریت و مجازی‌سازی

یکی از ویژگی‌های انحصاری سری RTX PRO، پشتیبانی از فناوری MIG یا Multi-Instance GPU است. این فناوری اجازه می‌دهد تا یک کارت گرافیک فیزیکی به حداکثر چهار کارت مجازی و کاملاً ایزوله تقسیم شود. هر یک از این کارت‌های مجازی حافظه و هسته‌های محاسباتی اختصاصی خود را دارند و می‌توانند به طور همزمان بارهای کاری متفاوتی را اجرا کنند. این ویژگی در دیتاسنترها و محیط‌های ابری که چند کاربر یا چند ماشین مجازی باید از یک کارت گرافیک استفاده کنند، حیاتی است. در RTX 5090 چنین قابلیتی وجود ندارد و کل کارت فقط به یک سیستم میزبان اختصاص دارد. همچنین RTX 6000 Pro Blackwell از درایورهای گواهی‌شده ISV (فروشندگان نرم‌افزارهای مستقل) پشتیبانی می‌کند. این درایورها برای نرم‌افزارهای حرفه‌ای مانند سالیدورکس، اتودسک، انسیمس و کتیا تست شده‌اند و پایداری صد در صدی را تضمین می‌کنند. RTX 5090 از چنین گواهی‌هایی برخوردار نیست و ممکن است در برخی نرم‌افزارهای مهندسی دچار ناپایداری یا عملکرد ضعیف شود.

قیمت و ارزش خرید

هنگام بررسی قیمت، اختلاف بسیار زیادی دیده می‌شود. RTX 5090 که برای بازار مصرف طراحی شده، در زمان عرضه با قیمت پایه ۲,۰۰۰ دلار روانه بازار شد. اما به دلیل افزایش قیمت حافظه‌های GDDR7 و تقاضای بسیار بالا، قیمت واقعی آن در بازار آزاد اکنون بین ۲,۵۰۰ تا ۳,۵۰۰ دلار و گاهی بیشتر نوسان می‌کند. در مقابل، RTX 6000 Pro Blackwell یک محصول حرفه‌ایی است که از کانال‌های توزیع اختصاصی و با قیمتی حدود ۸,۵۰۰ دلار به فروش می‌رسد. این قیمت بیش از دو برابر گران‌ترین قیمت RTX 5090 است. آیا این تفاوت قیمت توجیه‌پذیر است؟ پاسخ بستگی کامل به کاربر دارد. برای یک گیمر یا حتی یک طراح سه‌بعدی که مدل‌های او به بیش از ۳۲ گیگابایت حافظه نیاز ندارند، پرداخت ۵,۰۰۰ دلار اضافه بیهوده است. اما برای یک شرکت فعال در زمینه هوش مصنوعی که مدل ۷۰ میلیارد پارامتری را بارها در روز اجرا می‌کند، نبود حافظه کافی یعنی توقف کار. در چنین شرایطی، ۸,۵۰۰ دلار برای یک کارت که جایگزین چندین کارت کوچک‌تر و پیچیدگی‌های نرم‌افزاری آن می‌شود، هزینه منطقی به شمار می‌رود.

کاربردهای پیشنهادی برای هر کارت

با توجه به تمام موارد گفته شده، می‌توان توصیه‌های روشنی ارائه داد. GeForce RTX 5090 مناسب گروه‌های زیر است:

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

  • گیمرهای حرفه‌ای که به دنبال بالاترین نرخ فریم در بازی‌های جدید با رهگیری پرتو و وضوح ۴K و ۸K هستند.
  • تولیدکنندگان محتوای ویدیویی که با وضوح ۸K و نرم‌افزارهایی مانند پریمیر پرو یا داوینچی ریزالو کار می‌کنند.
  • هنرمندان سه‌بعدی که صحنه‌های پیچیده با حجم بافت بالا رندر می‌کنند اما اندازه پروژه آن‌ها در ۳۲ گیگابایت حافظه جا می‌شود.
  • توسعه‌دهندگان هوش مصنوعی در سطح متوسط که با مدل‌های کوچک تا حدود ۲۰ میلیارد پارامتر کار می‌کنند.

و اما RTX 6000 Pro Blackwell برای گروه‌های زیر طراحی شده است:

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

  • پژوهشگران هوش مصنوعی که با مدل‌های بزرگ زبانی با بیش از ۵۰ میلیارد پارامتر به صورت محلی سروکار دارند.
  • مراکز داده و سرورهایی که نیاز به مجازی‌سازی کارت‌های گرافیک با فناوری MIG دارند.
  • مهندسان و دانشمندانی که شبیه‌سازی‌های علمی با مجموعه داده‌های بزرگتر از ۳۲ گیگابایت انجام می‌دهند.
  • شرکت‌هایی که نرم‌افزارهای مهندسی نیازمند گواهی ISV را اجرا می‌کنند و پایداری مطلق برای آن‌ها حیاتی است.
  • هر کاربری که نیاز به حافظه ECC برای جلوگیری از خطاهای محاسباتی دارد.

جمع‌بندی نهایی

در مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 باید گفت هر دو محصولاتی شگفت‌انگیز از نسل بلک‌ول انویدیا هستند. هیچ یک از این دو به طور مطلق از دیگری بهتر نیست.

انتخاب صحیح کاملاً به نیازی بستگی دارد که کاربر دنبال می‌کند. RTX 5090 یک ابرقهرمان در دنیای بازی و تولید محتواست و قیمت مناسبی برای یک کاربر حرفه‌ای منفرد دارد.

RTX 6000 Pro Blackwell یک ابررایانه کوچک بر روی یک برد است که برای بارهای کاری سنگین علمی، مهندسی و تجاری طراحی شده و هزینه بالای آن به دلیل حافظه عظیم، قابلیت ECC، پشتیبانی از مجازی‌سازی و درایورهای معتبر است.

مصرف‌کننده نهایی باید پیش از خرید، دقیقاً محاسبه کند که آیا نرم‌افزارهای مورد استفاده او به بیش از ۳۲ گیگابایت حافظه و قابلیت‌های حرفه‌ای نیاز دارند یا خیر. اگر پاسخ منفی است، RTX 5090 انتخابی هوشمندانه خواهد بود و اگر پاسخ مثبت است، هیچ جایگزینی به جز RTX 6000 Pro Blackwell نمی‌تواند نیاز را برآورده سازد.

در هر صورت، سرمایه‌گذاری روی هر یک از این دو قطعه، تا چندین سال قدرت پردازشی بی‌نظیری را در اختیار کاربر قرار می‌دهد.

LLM

سیستم‌های مناسب برای LLM

در سال‌های اخیر، مدل‌های زبانی بزرگ که به اختصار LLM نامیده می‌شوند، به عنوان یکی از پیشرفت‌های بنیادین در حوزه هوش مصنوعی مطرح شده‌اند. این مدل‌ها توانایی تولید متن، پاسخ به پرسش‌ها، خلاصه‌سازی محتوا و حتی انجام استدلال‌های پیچیده را دارند.

با این حال، توسعه و اجرای این LLMها بدون وجود سیستم‌های فنی مناسب تقریبا غیرممکن است. مدل‌های زبانی بزرگ به دلیل حجم عظیم داده‌های آموزشی، تعداد بسیار زیاد پارامترها و نیاز به توان محاسباتی بالا، به زیرساخت‌های ویژه‌ای نیاز دارند.

سیستم‌های محاسباتی سخت‌افزاری برای LLM

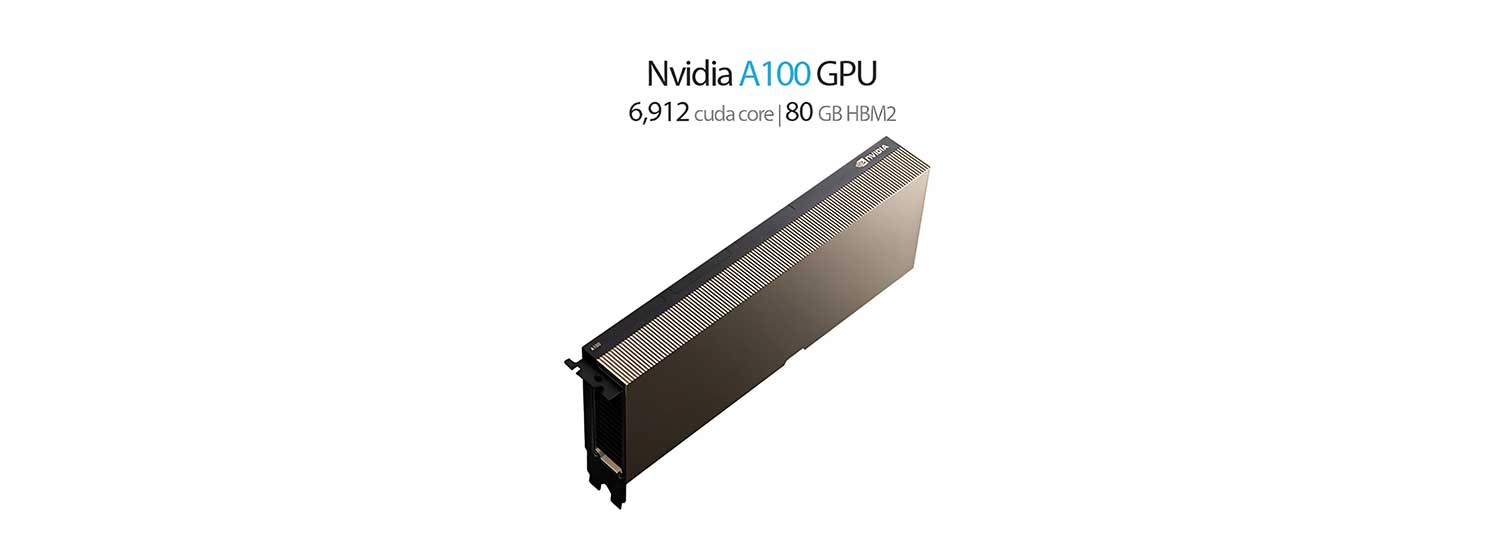
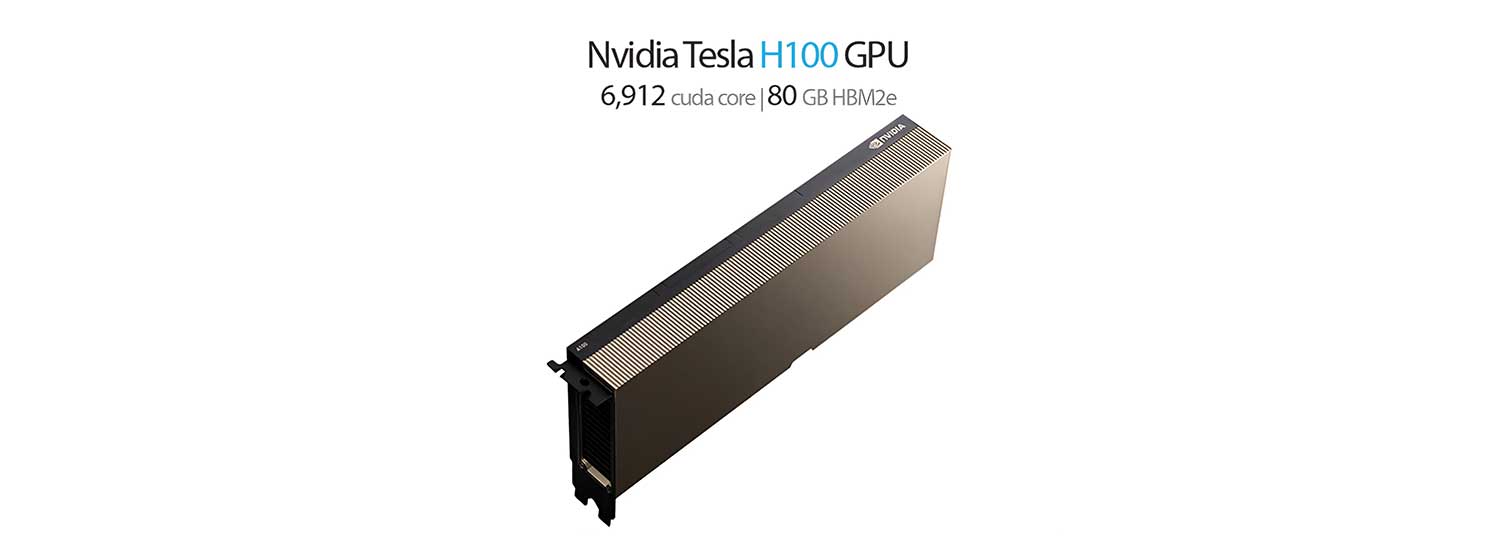
اصلی‌ترین نیاز مدل‌های زبانی بزرگ، توان پردازشی بسیار بالا است. پردازنده‌های مرکزی معمولی برای آموزش یا حتی اجرای یک LLM با صدها میلیارد پارامتر کافی نیستند. به همین دلیل، استفاده از واحدهای پردازش گرافیکی پیشرفته به یک استاندارد تبدیل شده است. شرکت انویدیا با تولید محصولاتی مانند سری A100 و H100، توانسته است نیاز صنعت LLM را تا حد زیادی تأمین کند. این پردازنده‌های گرافیکی دارای هزاران هسته محاسباتی هستند که می‌توانند عملیات ضرب ماتریسی را که بخش عمده محاسبات شبکه‌های عصبی در یک LLM است، با سرعت بسیار بالا انجام دهند. در مقاله مقایسه کارت گرافیک A100 , H100 , RTX 6000 PRO Blackwell  به بررسی این پردازنده های گرافیکی پرداختیم.

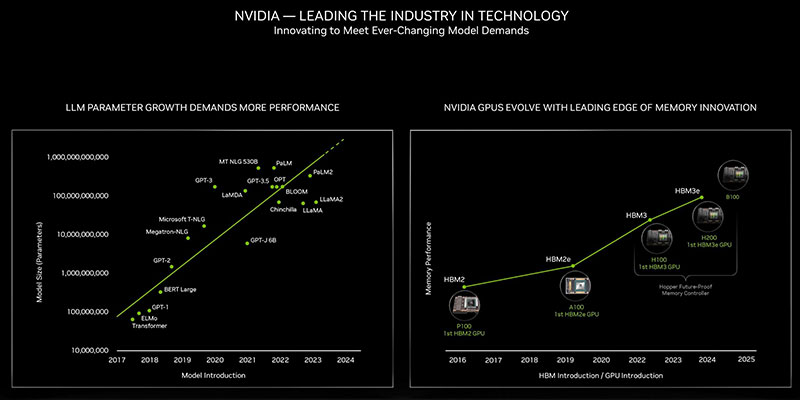
علاوه بر پردازنده‌های گرافیکی، حافظه با پهنای باند بالا نیز یکی دیگر از اجزای حیاتی برای اجرای LLM محسوب می‌شود. مدل‌های زبانی بزرگ باید به صورت کامل یا بخشی از آن در حافظه جانبی پردازنده‌ها قرار گیرد تا عملیات استنتاج یا آموزش به صورت پیوسته انجام شود. برای مثال، یک LLM با ۱۷۵ میلیارد پارامتر به چندین ترابایت حافظه نیاز دارد. بنابراین، استفاده از حافظه‌های اچ‌بی‌ام یا حافظه‌های با پهنای باند بسیار بالا و همچنین چیدمان بهینه حافظه در میان چندین پردازنده گرافیکی برای بهینه‌سازی کارایی LLM ضروری است.

در سطح بالاتر، سیستم‌های توزیع شده که متشکل از صدها یا هزاران پردازنده گرافیکی هستند، برای آموزش LLMهایی مانند جی‌پی‌تی-۴ یا لاما استفاده می‌شوند. این خوشه‌های محاسباتی باید از طریق شبکه‌های پرسرعت مانند اینفینی‌باند به یکدیگر متصل شوند تا تأخیر در انتقال داده‌ها برای همگام‌سازی اجزای مختلف مدل زبانی بزرگ به حداقل برسد. بدون چنین اتصالات پرسرعتی، همگام‌سازی میان پردازنده‌ها به یک گلوگاه بزرگ تبدیل خواهد شد و کارایی سیستم LLM به شدت کاهش می‌یابد.

سیستم‌های ذخیره‌سازی و مدیریت داده برای LLM

دومین جزء مهم در معماری یک LLM، سیستم ذخیره‌سازی داده است. مدل‌های زبانی بزرگ بر روی حجم عظیمی از داده‌های متنی آموزش داده می‌شوند. این داده‌ها معمولا شامل کتاب‌ها، مقالات وب، کدهای برنامه‌نویسی و محتوای علمی هستند که جمعا به چندین ده ترابایت می‌رسند. دسترسی سریع و قابل اعتماد به این داده‌ها در طول فرآیند آموزش یک LLM اهمیت بالایی دارد. سیستم‌های ذخیره‌سازی توزیع شده مانند اچ‌دی‌اف‌اس یا سیستم‌های مدرن مبتنی بر آبجکت استوریج، امکان خواندن همزمان داده توسط صدها پردازنده را برای تغذیه مدل زبانی بزرگ فراهم می‌کنند.

علاوه بر ذخیره‌سازی خام داده، نیاز به سیستم‌های مدیریت داده برای پیش‌پردازش و پاکسازی متن‌های مورد استفاده در LLM وجود دارد. داده‌های متنی خام معمولا دارای نویز، کاراکترهای تکراری، اطلاعات تکراری یا محتوای نامرتبط هستند. سیستم‌های مناسب برای آموزش یک LLM باید شامل ابزارهایی برای توکن‌سازی، نرمال‌سازی، حذف داده‌های بی‌کیفیت و ایجاد بسته‌های داده با طول یکسان باشند. برای این منظور، پلتفرم‌هایی مانند اسپارک یا سیستم‌های پردازش داده موازی کاربرد فراوان دارند و به کارآمدی مدل‌های زبانی بزرگ کمک می‌کنند.

همچنین در مرحله اجرا و ارائه خدمات توسط یک LLM، ذخیره‌سازی کش برای پاسخ‌های مکرر یا محاسبات میانی اهمیت پیدا می‌کند. بسیاری از سوالات کاربران از یک مدل زبانی بزرگ تکراری هستند. اگر پاسخ هر سوال برای مدت معینی در حافظه کش ذخیره شود، می‌توان از محاسبات مجدد توسط LLM جلوگیری کرد و هزینه و زمان پاسخگویی را کاهش داد. بنابراین، سیستم‌های کش توزیع شده مانند ردیس معمولا در معماری خدماتی مدل‌های زبانی بزرگ گنجانده می‌شوند.

سیستم‌های نرم‌افزاری و فریم‌ورک‌های مخصوص LLM

برای استفاده کارآمد از سخت‌افزارهای قدرتمند در راستای اجرای یک LLM، به فریم‌ورک‌های نرم‌افزاری تخصصی نیاز است. در حال حاضر، فریم‌ورک‌هایی مانند پایتورچ و تنسورفلو دو ابزار اصلی برای توسعه و آموزش مدل‌های زبانی بزرگ هستند.

LLM

این فریم‌ ورک‌ها قابلیت‌هایی مانند محاسبات خودکار گرادیان، مدیریت حافظه، و پشتیبانی از موازی‌سازی را ارائه می‌دهند. بدون این ابزارها، پیاده‌سازی دستوری الگوریتم‌های بهینه‌سازی برای یک LLM تقریبا غیرممکن خواهد بود.

فراتر از فریم‌ورک‌های پایه، کتابخانه‌ها و ابزارهای خاصی برای مدل‌های زبانی بزرگ توسعه یافته‌اند. برای مثال، کتابخانه «دیکپ‌اسپید» از شرکت مایکروسافت، روش‌های موازی‌سازی پیشرفته‌ای مانند موازی‌سازی داده، موازی‌سازی لوله‌ای و موازی‌سازی تانسور را برای آموزش LLM ارائه می‌دهد. همچنین کتابخانه «ترنسفورمرز» از هاگینگ‌فیس، دسترسی به مدل‌های زبانی بزرگ از پیش آموزش دیده و ابزارهای ارزیابی را ساده کرده است. این کتابخانه‌ها شامل توابعی برای بارگذاری یک LLM، توکن‌سازی متن و تولید متن با تنظیمات مختلف هستند.

یک سیستم نرم‌افزاری مناسب برای مدل زبانی بزرگ باید شامل ماژول پایش و ثبت وقایع نیز باشد. آموزش یک LLM ممکن است هفته‌ها یا ماه‌ها طول بکشد. در این مدت، احتمال بروز خطاهای سخت‌افزاری یا نرم‌افزاری وجود دارد. سیستم‌های پایش پیشرفته می‌توانند دمای پردازنده‌ها، مصرف حافظه، نرخ استفاده از واحد محاسباتی و همچنین معیارهای آموزشی LLM مانند میزان خطا و دقت را در زمان واقعی نمایش دهند. در صورت بروز مشکل، این سیستم‌ها قادر به ذخیره وضعیت فعلی آموزش مدل زبانی بزرگ و بازیابی از نقاط بازبینی هستند.

سیستم‌های استنتاج و بهینه‌سازی برای کاربردی شدن LLM

پس از آموزش یک مدل زبانی بزرگ، مرحله مهم بعدی، استنتاج یا استفاده عملی از LLM است. در این مرحله، سیستم باید بتواند به درخواست‌های کاربران در زمان کوتاه پاسخ دهد. تفاوت اصلی میان مرحله آموزش و استنتاج در این است که در استنتاج، تأخیر بسیار حیاتی و توان عملیاتی بالا برای پاسخگویی LLM اهمیت دارد. برای این منظور، تکنیک‌های بهینه‌سازی مختلفی به کار می‌روند.

LLM

یکی از مهمترین روش‌های بهینه‌سازی برای استنتاج یک LLM، استفاده از کمینه‌سازی اعداد با دقت کمتر است. به جای ذخیره پارامترهای مدل زبانی بزرگ با دقت ممیز شناور ۳۲ بیتی، می‌توان آن‌ها را با دقت ۱۶ بیتی یا حتی ۸ و ۴ بیتی ذخیره کرد. این کار باعث کاهش چشمگیر حافظه مورد نیاز و افزایش سرعت محاسبات LLM می‌شود، هرچند که ممکن است دقت مدل را اندکی کاهش دهد. روش دیگر، تقطیر مدل زبانی بزرگ است که در آن یک مدل کوچک‌تر را آموزش می‌دهیم تا خروجی‌های LLM بزرگ را تقلید کند.

همچنین سیستم‌های استنتاج برای مدل‌های زبانی بزرگ معمولا از مکانیزم‌های کش برداری استفاده می‌کنند. در بسیاری از کاربردهای مبتنی بر LLM مانند سیستم‌های پرسش و پاسخ یا دستیارهای مجازی، درخواست‌های مشابه بارها تکرار می‌شوند. با ذخیره بردارهای نمایش متن در یک پایگاه داده برداری، می‌توان به جای اجرای کامل مدل زبانی بزرگ، پاسخ‌های مشابه را بازیابی کرد. این روش به خصوص برای LLMهای تولید افزایشیافته با بازیابی بسیار مؤثر است.

سیستم‌های امنیتی و حریم خصوصی برای LLM

بدون شک، پیاده‌سازی مدل‌های زبانی بزرگ در محیط‌های واقعی مستلزم رعایت اصول امنیتی و حریم خصوصی است. بسیاری از کاربردهای تجاری LLM شامل داده‌های حساس کاربران مانند اطلاعات پزشکی، مالی یا محرمانه سازمانی هستند. بنابراین، سیستم‌های مناسب برای مدل زبانی بزرگ باید قابلیت اجرای مدل به صورت محلی را داشته باشند. در این مدل استقرار محلی، داده‌های کاربران از سیستم LLM خارج نمی‌شوند و کنترل کامل در اختیار مالک داده است.

علاوه بر استقرار محلی LLM، استفاده از روش‌های رمزنگاری پیشرفته مانند محاسبات چندجانبه ایمن یا رمزنگاری همومورفیک در حال توسعه است. این روش‌ها امکان محاسبه بر روی داده‌های رمز شده توسط یک مدل زبانی بزرگ بدون نیاز به رمزگشایی را فراهم می‌کنند. البته در حال حاضر این روش‌ها بسیار کند هستند و برای LLMهای بزرگ به بلوغ کامل نرسیده‌اند. اما به عنوان یک سیستم مناسب برای حفاظت از مدل‌های زبانی بزرگ در آینده نقش مهمی ایفا خواهند کرد.

همچنین سیستم‌های ثبت و پایش درخواست‌ها از نظر امنیتی برای LLM ضروری هستند. ثبت اطلاعاتی مانند کاربر درخواست‌کننده، زمان درخواست، نوع پرسش و پاسخ تولید شده توسط مدل زبانی بزرگ، به تشخیص حملات مخرب یا نشت اطلاعات کمک می‌کند. یک سیستم مناسب برای LLM باید توانایی تشخیص الگوهای غیرعادی مانند درخواست‌های مکرر برای استخراج داده‌های آموزش یا تلاش برای شکستن محدودیت‌های محتوایی مدل زبانی بزرگ را داشته باشد.

نتیجه‌گیری

LLMها به ترکیبی هماهنگ از سخت‌افزارهای قدرتمند مانند پردازنده‌های گرافیکی پیشرفته، سیستم‌های ذخیره‌سازی توزیع شده با دسترسی سریع به داده، فریم‌ورک‌های نرم‌افزاری به ینه‌سازی شده، روش‌های استنتاج با تأخیر کم و همچنین سازوکارهای امنیتی مناسب نیاز دارند. هیچ کدام از این اجزا به تنهایی برای اجرای یک مدل زبانی بزرگ کافی نیستند و یک سیستم کارآمد باید تمامی این لایه‌ها را به صورت یکپارچه پوشش دهد.

با توجه به سرعت پیشرفت فناوری LLM، انتظار می‌رود سیستم‌های مناسب برای مدل‌های زبانی بزرگ نیز به سرعت تکامل یابند. کاهش هزینه‌های محاسباتی، افزایش کارایی انرژی، بهبود روش‌های فشرده‌سازی LLM و توسعه سخت‌افزارهای اختصاصی برای محاسبات عصبی مرتبط با مدل‌های زبانی بزرگ، از جمله روندهایی هستند که آینده این حوزه را شکل خواهند داد. درک صحیح این سیستم‌ها برای پژوهشگران، مهندسان و مدیرانی که قصد بهره‌گیری از توان LLMها را دارند، امری ضروری و اجتناب‌ناپذیر است.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell برای کاربردهای هوش مصنوعی

انتخاب پردازنده گرافیکی مناسب برای پروژه‌های هوش مصنوعی، به ویژه در حوزه مدل‌های زبانی بزرگ، تصمیمی سرنوشت‌ساز و پیچیده است. هر یک از سه کارت گرافیک مورد بررسی، اگرچه محصولی از انویدیا هستند، اما برای کاربردها و بودجه‌بندی متفاوتی طراحی شده‌اند.

انویدیا A100 به عنوان استاندارد طلایی سابق،H100 به عنوان راهکار غالب مراکز داده در سال‌های اخیر و RTX 6000 PRO Blackwell به عنوان تازه‌واردی با معماری به روز و حافظه بالا، گزینه‌های پیش روی مهندسان و پژوهشگران هستند.

مشخصات فنی و معماری

برای درک تفاوت عملکرد، ابتدا باید به تفاوت‌های بنیادین در معماری و مشخصات فنی این سه محصول نگاه کرد. هر یک از این کارت‌گرافیک‌ها بر پایه یک معماری خاص طراحی شده و ویژگی‌های منحصر به فردی را ارائه می‌دهد.

۱. کارت گرافیک A100 با معماری آمپر

معماری آمپر انقلابی در محاسبات هوش مصنوعی ایجاد کرد. این کارت‌گرافیک از نسل سوم هسته‌های تانسور بهره می‌برد و قابلیت‌هایی مانند تی‌اف۳۲ و اسپارسیتی را معرفی نمود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

رایج‌ترین نسخه کارت گرافیک A100، مدل ۸۰ گیگابایتی با حافظه نوع اچ‌بی‌ام۲ئی و پهنای باند ۲ ترابایت بر ثانیه است. فرم فاکتور این محصول از نوع اس‌اکس‌ام بوده و برای نصب در مراکز داده تخصصی طراحی شده است. این کارت همچنین از فناوری ام‌آی‌جی پشتیبانی می‌کند که به کاربران اجازه می‌دهد یک کارت گرافیک را به چندین بخش مجزا و ایمن تقسیم نمایند.

۲. کارت‌گرافیک‌ H100 با معماری هاپر

معماری هاپر پیشرفتی قابل توجه نسبت به نسل قبل است. کارت‌گرافیک‌ H100 از نسل چهارم هسته‌های تانسور و نوع داده اف‌پی۸ پشتیبانی می‌کند که عملاً توان محاسباتی را برای این نوع داده نسبت به ای۱۰۰ دوچندان می‌نماید.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

مدل اس‌اکس‌ام این محصول دارای ۸۰ گیگابایت حافظه نوع اچ‌بی‌ام۳ با پهنای باند ۳.۳۵ ترابایت بر ثانیه است که از ای۱۰۰ سریع‌تر می‌باشد. فرم فاکتور این محصول نیز از نوع اس‌اکس‌ام بوده و به سیستم‌های خنک‌کننده پیشرفته نیاز دارد. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول به ۹۸۹ ترافلاپس می‌رسد که رقمی بسیار چشمگیر است.

۳. انویدیا RTX 6000 PRO Blackwell با معماری بلک‌ول

جدیدترین محصول این خانواده یعنی کارت گرافیک RTX 6000 PRO Blackwell بر پایه معماری بلک‌ول ساخته شده است. تفاوت کلیدی این محصول در نوع حافظه آن است. بر خلاف دو مدل قبلی که از حافظه اچ‌بی‌ام استفاده می‌کردند، آرتی‌ایکس ۶۰۰۰ پرو از ۹۶ گیگابایت حافظه نوع جی‌دی‌دی‌آر۷ با پهنای باند ۱.۷۹۲ ترابایت بر ثانیه بهره می‌برد.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

فرم فاکتور این محصول از نوع پی‌سی‌آی‌اکسپرس است که امکان نصب آن را در ایستگاه‌های کاری معمولی و سیستم های هوش مصنوعی معمولی را فراهم می‌کند. این محصول از نسل پنجم هسته‌های تانسور و نوع داده اف‌پی۴ پشتیبانی می‌کند که پیشرفته‌ترین فناوری روز برای شتاب‌دهی به استنتاج مدل‌های عظیم محسوب می‌شود. توان محاسباتی هسته‌های تانسور در دقت اف‌پی۱۶ برای این محصول حدود ۱۲۶ ترافلاپس است که در مقایسه با اچ‌۱۰۰ پایین‌تر به نظر می‌رسد، اما این کاهش توان با بهره‌وری انرژی بالاتر و حافظه بیشتر جبران شده است.

 تحلیل مقایسه‌ای مشخصات کلیدی

از نظر معماری، کارت گرافیک A100 متعلق به نسل آمپر، کارت‌گرافیک‌ H100 متعلق به نسل هاپر و کارت گرافیک RTX 6000 PRO Blackwell متعلق به جدیدترین نسل یعنی بلک‌ول است. هر نسل جدید بهبودهای قابل توجهی در بهره‌وری انرژی و توان محاسباتی به همراه داشته است.

از نظر مقدار حافظه، کارت گرافیک A100 و کارت‌گرافیک‌ H100 هر دو ۸۰ گیگابایت حافظه در اختیار کاربر قرار می‌دهند، در حالی که کارت گرافیک RTX 6000 PRO Blackwell با ۹۶ گیگابایت حافظه، برتری محسوسی در این زمینه دارد. این ۱۶ گیگابایت اضافی می‌تواند تفاوت زیادی در اجرای مدل‌های بسیار بزرگ ایجاد کند.

از نظر نوع حافظه، کارت گرافیک A100 از نوع اچ‌بی‌ام۲ئی، کارت‌گرافیک‌ H100 از نوع اچ‌بی‌ام۳ و کارت گرافیک RTX 6000 PRO Blackwell از نوع جی‌دی‌دی‌آر۷ استفاده می‌کند. حافظه اچ‌بی‌ام پهنای باند بالاتری دارد اما گران‌تر است، در حالی که جی‌دی‌دی‌آر۷ اگرچه پهنای باند کمتری ارائه می‌دهد، اما مقرون به صرفه‌تر و در دسترس‌تر است.

از نظر پهنای باند حافظه، کارت گرافیک A100 با ۲ ترابایت بر ثانیه، اچ‌۱۰۰ با ۳.۳۵ ترابایت بر ثانیه و کارت گرافیک RTX 6000 PRO Blackwell با ۱.۷۹۲ ترابایت بر ثانیه عمل می‌کند. اچ‌۱۰۰ در این شاخص به وضوح برتر است و برای بارهای کاری حساس به پهنای باند مانند آموزش مدل‌های بزرگ، بهترین انتخاب محسوب می‌شود.

از نظر قیمت تقریبی، کارت‌گرافیک‌ H100 گران‌ترین گزینه است و قیمت آن در بازار آزاد به چند ده هزار دلار می‌رسد. کارت گرافیک A100 قیمت متوسطی دارد و در بازار دست دوم با قیمت‌های معقول‌تری یافت می‌شود. کارت گرافیک RTX 6000 PRO Blackwell از نظر قیمت خرید، گزینه‌ای بین این دو محسوب می‌شود و نسبت به کارت‌گرافیک‌ H100 مقرون به صرفه‌تر است.

تحلیل عملکرد برای هوش مصنوعی

عملکرد این کارت‌ها بسته به نوع بار کاری، یعنی آموزش یا استنتاج و همچنین اندازه مدل، تفاوت چشمگیری دارد.

۱. عملکرد در مرحله آموزش مدل

در حوزه آموزش مدل‌های بزرگ، همواره پهنای باند حافظه و توان محاسباتی خام حرف اول را می‌زند. کارت‌گرافیک‌ H100 در این بخش برتری مطلق دارد. پهنای باند بالای اچ‌بی‌ام۳ و توان محاسباتی عظیم اف‌پی۸ آن باعث می‌شود آموزش مدل‌هایی مانند جی‌پی‌تی-۳ تا ۴ برابر سریع‌تر از ای۱۰۰ انجام شود. برای یک تیم تحقیقاتی که قصد آموزش یک مدل بزرگ از ابتدا را دارد، کارت‌گرافیک‌ H100 می‌تواند هفته‌ها زمان را صرفه‌جویی کند.

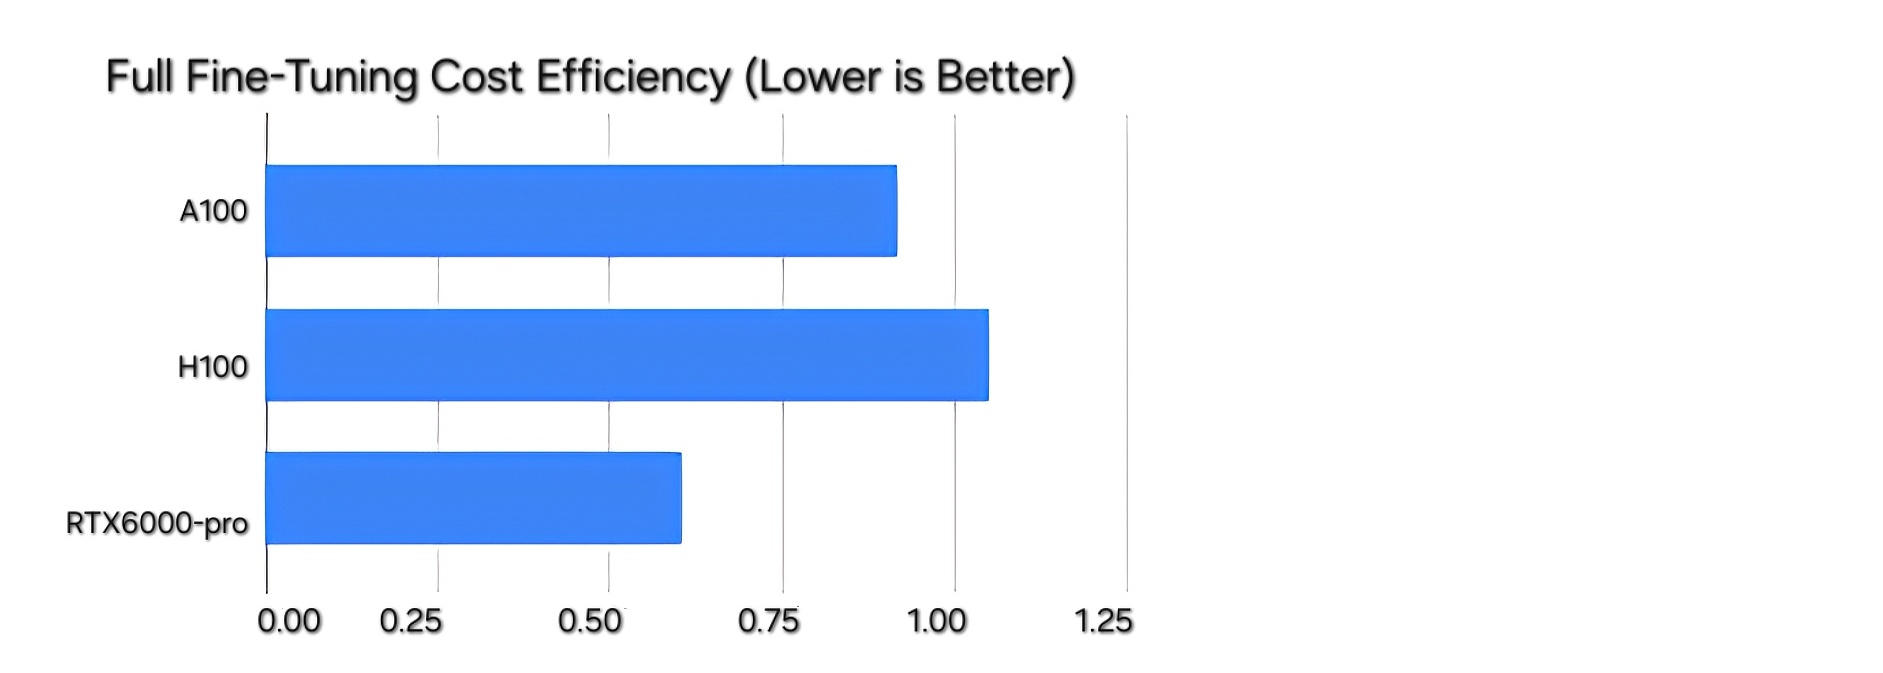
ای۱۰۰ اگرچه سرعتی معادل یک‌چهارم اچ‌۱۰۰ در برخی بارها دارد، اما به دلیل بلوغ نرم‌افزاری و هزینه کمتر، گزینه‌ای مقرون به صرفه برای تیم‌های متوسط محسوب می‌شود. طبق بنچمارک‌های معتبر، هزینه اجرای یک دوره آموزشی روی ای۱۰۰ تقریباً نصف اچ‌۱۰۰ تمام می‌شود، چراکه اچ‌۱۰۰ برای مدل‌های کوچک به طور کامل اشباع نمی‌گردد.

اما جایگاه کارت گرافیک RTX 6000 PRO Blackwell در این بخش چیست؟ این کارت با داشتن حافظه جی‌دی‌دی‌آر۷، پهنای باند کمتری نسبت به اچ‌۱۰۰ دارد. همچنین توان محاسباتی اف‌پی۱۶ آن در مقایسه با اچ‌۱۰۰ بسیار پایین‌تر است. با این حال، یک مزیت بزرگ دارد و آن ۹۶ گیگابایت حافظه است. معماری بلک‌ول در این کارت به گونه‌ای طراحی شده که برای استنتاج بهینه است، نه آموزش حجیم. برای آموزش مدل‌های بسیار بزرگ، اچ‌۱۰۰ همچنان پادشاه بلامنازع باقی می‌ماند.

۲.عملکرد در مرحله استنتاج

بخش جذاب ماجرا به استنتاج مربوط می‌شود، جایی که آرتی‌ایکس ۶۰۰۰ پرو می‌تواند بدرخشد. بزرگترین چالش در استنتاج مدل‌های زبانی بزرگ، ظرفیت حافظه است. برای اجرای یک مدل ۷۰ میلیارد پارامتری در دقت اف‌پی۸، تقریباً به ۷۰ گیگابایت حافظه نیاز خواهد بود.

انویدیا ای۱۰۰ و اچ‌۱۰۰ هر دو ۸۰ گیگابایت حافظه دارند. این مقدار برای اجرای نسخه اف‌پی۸ مدل ۷۰ میلیاردی کافی است، اما فضای بسیار کمی برای حافظه میانی باقی می‌گذارد. این موضوع سرعت را در توالی‌های طولانی کاهش می‌دهد و امکان استفاده از سایز بچ بزرگ را محدود می‌کند.

در سوی دیگر، انویدیا آرتی‌ایکس ۶۰۰۰ پرو با ۹۶ گیگابایت حافظه، فضای تنفس بیشتری دارد. این یعنی می‌تواند همین مدل ۷۰ میلیاردی را با سایز بچ بزرگ‌تر و سرعت بالاتر، بدون نیاز به دو کارت گرافیک و ارتباطات پرسرعت بین آنها اجرا کند. این ویژگی برای استقرار مدل در محیط تولیدی یک مزیت رقابتی بزرگ محسوب می‌شود.

بنچمارک‌های مستقل نشان می‌دهند که این کارت در دقت اف‌پی۸ عملکرد بسیار خوبی دارد و در برخی تست‌ها به ۸,۴۰۰ توکن در ثانیه روی مدل ۳۰ میلیاردی دست یافته است. این رقم تقریباً برابر با عملکرد چهار کارت آرتی‌ایکس ۴۰۹۰ است. اگرچه اچ‌۱۰۰ در حالت تئوری توان محاسباتی اف‌پی۸ بالاتری دارد، اما آرتی‌ایکس ۶۰۰۰ پرو با ارائه حافظه بیشتر، امکان اجرای روان‌تر مدل‌های حجیم را با هزینه سخت‌افزاری کمتر فراهم می‌کند.

علاوه بر این، پشتیبانی از نوع داده اف‌پی۴ در معماری بلک‌ول، یک برگ برنده بزرگ است. استفاده از اف‌پی۴ به طور تئوری توان خروجی را نسبت به اف‌پی۸ دو برابر می‌کند. این قابلیت، آرتی‌ایکس ۶۰۰۰ پرو را به گزینه‌ای ایده‌آل برای اجرای مدل‌های بسیار بزرگ در آینده تبدیل می‌کند، کاری که از اچ‌۱۰۰ یا ای۱۰۰ برنمی‌آید.

 تحلیل هزینه و صرفه اقتصادی

در نگاه اول، قیمت خرید اچ‌۱۰۰ بسیار بالا است و بسیاری از تیم‌ها توانایی تهیه آن را ندارند. اما در محاسبات ابری یا کرایه‌ای، قضیه متفاوت است. نرخ کرایه ساعتی اچ‌۱۰۰ بالاست و حدود ۲ دلار به ازای هر ساعت برای مدل پی‌سی‌آی‌اکسپرس برآورد می‌شود.

مقایسه کارت‌گرافیک‌های H100، A100 و RTX 6000 PRO Blackwell

در مقابل، آرتی‌ایکس ۶۰۰۰ پرو به دلیل ماهیت ورکاستیشن بودن و عدم نیاز به زیرساخت خنک‌کننده گران‌قیمت مرکز داده، کرایه ساعتی بسیار کمتری دارد. این نرخ به حدود ۰.۷ دلار به ازای هر ساعت می‌رسد. برای اجرای یک ای‌پی‌آی استنتاج، استفاده از آرتی‌ایکس ۶۰۰۰ پرو می‌تواند هزینه به ازای هر یک میلیون توکن را تا یک‌سوم اچ‌۱۰۰ کاهش دهد.

برای مدل‌های ۳۰ میلیاردی، هزینه استنتاج با آرتی‌ایکس ۶۰۰۰ پرو حدود ۰.۰۲ دلار به ازای هر یک میلیون توکن تخمین زده می‌شود. این رقم بسیار رقابتی است و به کسب‌وکارهای کوچک و متوسط اجازه می‌دهد بدون صرف هزینه‌های سرسام‌آور، مدل‌های هوش مصنوعی خود را به صورت زنده ارائه دهند.

نتیجه‌گیری

کدام یک برای هوش مصنوعی بهتر است؟

پاسخ به این سؤال کاملاً به نیاز خاص شما بستگی دارد و هیچ پاسخ یکسانی برای همه وجود ندارد.

اگر شما در حال آموزش یک مدل زبانی بزرگ از صفر هستید یا به حداکثر توان محاسباتی برای کاهش زمان آموزش نیاز دارید، انویدیا اچ‌۱۰۰ بدون شک بهترین انتخاب است. هیچ کارت دیگری در این رده قیمتی توان عملیاتی اف‌پی۸ و پهنای باند معادل اچ‌۱۰۰ را برای محیط‌های صنعتی و تحقیقاتی بزرگ ارائه نمی‌دهد. این کارت برای شرکت‌های بزرگ و مراکز تحقیقاتی پیشرفته طراحی شده است.

اگر هدف شما اجرا و استقرار مدل در محیط تولیدی به صورت مقرون به صرفه است، انویدیا آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول انتخاب هوشمندانه‌تری محسوب می‌شود. حافظه ۹۶ گیگابایتی آن بستری ایده‌آل برای اجرای مدل‌های تا ۷۰ میلیارد پارامتر با دقت مناسب فراهم می‌کند. هزینه عملیاتی پایین‌تر و پشتیبانی از فناوری جدید اف‌پی۴، آن را به سرمایه‌ای مناسب برای چند سال آینده تبدیل می‌کند. این کارت گزینه‌ای عالی برای استارتاپ‌ها و تیم‌هایی است که می‌خواهند مدل خود را با بودجه معقول به صورت زنده اجرا کنند.

اگر بودجه محدودی دارید و به دنبال یک گزینه متعادل برای آموزش و استنتاج مدل‌های نسبتاً بزرگ هستید، انویدیا ای۱۰۰ هنوز هم انتخاب قابل قبولی است. این کارت دیگر گزینه‌ای برای پیشرفته‌ترین پروژه‌ها نیست، اما با توجه به قیمت دست دوم مناسب و پایداری بالای نرم‌افزار، همچنان در بسیاری از مراکز داده به عنوان یک اسب کار قابل اعتماد فعالیت می‌کند.

در یک جمله خلاصه:

برای آموزش، اچ‌۱۰۰ برنده بی‌رقابت است. برای استنتاج با حجم بالا و بودجه بهینه، آرتی‌ایکس ۶۰۰۰ پرو بلک‌ول گزینه‌ای بهتر و آینده‌نگرانه‌تر به شمار می‌رود. انتخاب نهایی به بودجه، نوع پروژه و اولویت‌های شما بستگی دارد.

فناوری NVLink

معرفی فناوری NVLink شرکت انویدیا

در عصر کنونی که حجم داده‌های تولیدشده روزبه‌روز افزایش می‌یابد و مدل‌های هوش مصنوعی به مرزهای تریلیون‌ها پارامتر نزدیک می‌شوند، زیرساخت‌های محاسباتی سنتی با چالش‌های بنیادین مواجه هستند. یکی از حیاتی‌ترین این چالش‌ها، مسئله ارتباط بین پردازنده‌های گرافیکی یا همان GPUها در سامانه‌های چندپردازنده‌ای است.

فنّاوری NVLink که توسط شرکت انویدیا طراحی و توسعه یافته است، پاسخی نوآورانه به این نیاز رو به رشد محسوب می‌شود.

ضرورت پیدایش NVLink

به‌طور سنتی، ارتباط بین GPUها در یک سرور از طریق گذرگاه استاندارد PCI Express یا همان PCIe انجام می‌شده است. این گذرگاه از ابتدای معرفی خود در اوایل دهه ۲۰۰۰، نقش اصلی را در اتصال دستگاه‌های جانبی به پردازنده مرکزی ایفا کرده است. اگرچه نسل‌های مختلف PCIe بهبودهایی در پهنای باند داشته‌اند، اما این گذرگاه به‌عنوان یک گلوگاه اساسی در سامانه‌های سنگین محاسباتی شناخته می‌شود. برای نمونه، گذرگاه PCIe نسل پنجم حداکثر پهنای باند دوطرفه در حدود ۱۲۸ گیگابایت بر ثانیه ارائه می‌دهد. این میزان برای اجرای مدل‌های پیچیده هوش مصنوعی که نیازمند تبادل لحظه‌ای حجم عظیمی از داده میان ده‌ها یا صدها GPU هستند، کافی نیست. یک مدل زبانی بزرگ با یک تریلیون پارامتر، هنگام آموزش، نیاز دارد که هر میلی‌ثانیه، گرادیان‌ها و به‌روزرسانی‌های وزن میان تمام پردازنده‌ها مبادله شود. در چنین شرایطی، پهنای باند محدود PCIe باعث می‌شود تا بخش قابل توجهی از زمان پردازش به جای محاسبه، صرف انتظار برای انتقال داده گردد.

افزون بر محدودیت پهنای باند، معماری مبتنی بر PCIe نیازمند دخالت پردازنده مرکزی یا CPU در فرآیند انتقال داده است. در این معماری، هنگامی که دو GPU می‌خواهند داده‌ای را مبادله کنند، ابتدا داده باید از حافظه GPU مبدأ به حافظه اصلی سیستم منتقل شود، سپس CPU آن را مسیریابی کرده و در نهایت به GPU مقصد برسد. این فرآیند چندمرحله‌ای باعث افزایش تأخیر یا Latency می‌شود و همچنین بار اضافی قابل توجهی بر روی CPU تحمیل می‌کند. در سامانه‌های بزرگ، CPU که خود مسئولیت مدیریت سیستم عامل و برنامه‌ریزی فرآیندها را بر عهده دارد، نمی‌تواند به طور مؤثر از عهده مدیریت حجم عظیم ترافیک داده میان ده‌ها GPU برآید. به همین دلایل، انویدیا تصمیم به خلق یک رابط اختصاصی و کارآمد برای شبکه‌سازی درون‌راکی یا Scale-up گرفت و NVLink را برای نخستین بار در سال ۲۰۱۶ و همزمان با معماری Pascal معرفی کرد.

مفهوم و معماری NVLink

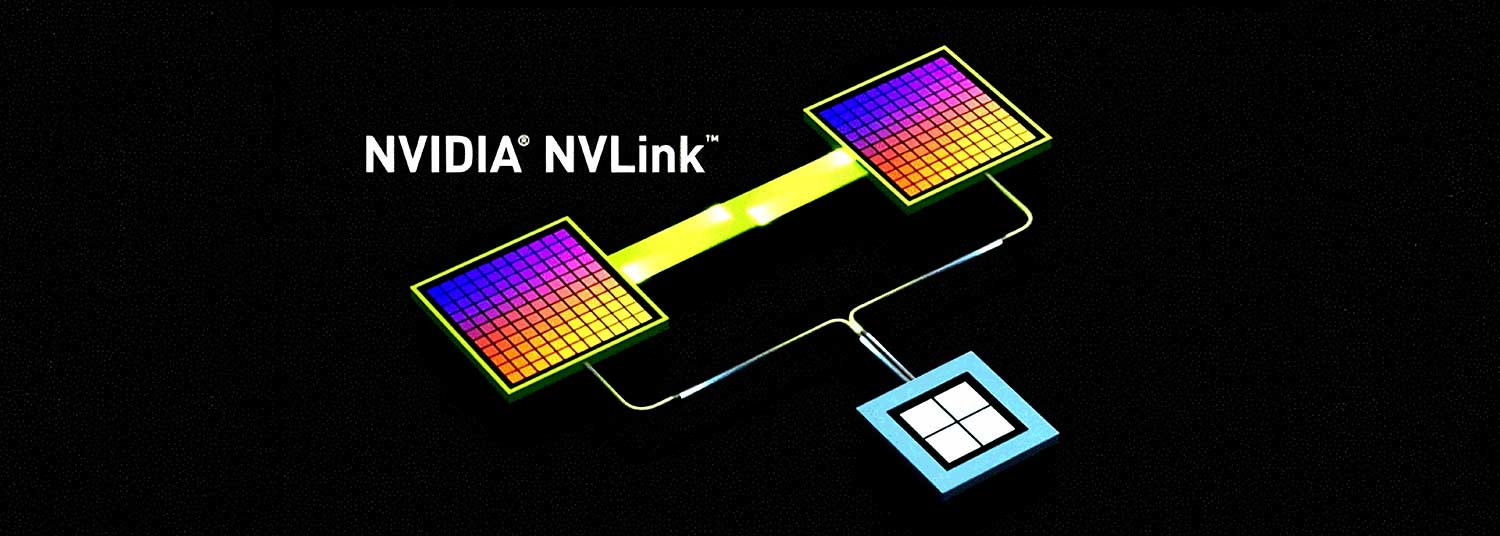
NVLink یک رابط ارتباطی پرسرعت با تأخیر بسیار پایین است که به‌طور خاص برای ارتباط مستقیم GPUها با یکدیگر و همچنین اتصال GPUها به CPUهای سازگار طراحی شده است. کلید واژه در این تعریف، کلمه «مستقیم» است. برخلاف معماری متمرکز PCIe که داده‌ها باید از پل ارتباطی چیپ‌ست و گذرگاه‌های اشتراکی عبور کنند، NVLink امکان برقراری ارتباطی مشبک یا Mesh-style را فراهم می‌آورد. این ارتباط مستقیم، مزیت دوچندان دارد: نخست آنکه پهنای باند قابل‌دسترس برای هر GPU به طور چشمگیری افزایش می‌یابد و هر جفت از GPUها می‌توانند بدون رقابت بر سر منابع مشترک با یکدیگر تبادل داده کنند. دوم آنکه تأخیر ناشی از دخالت CPU و گذر از لایه‌های نرم‌افزاری میانی حذف می‌شود. در عمل، تأخیر ارتباطی در NVLink به کمتر از یک میکروثانیه می‌رسد که در مقایسه با ده‌ها میکروثانیه PCIe، یک پیشرفت انقلابی است.

فناوری NVLink

این فناوری تنها به یک کابل ارتباطی ساده محدود نمی‌شود، بلکه یک مجموعه سخت‌افزاری و نرم‌افزاری کامل است. هسته اصلی این فناوری در سامانه‌های بزرگ، تراشه‌های NVLink Switch هستند. این تراشه‌ها با ایجاد یک شبکه تماماً متصل یا All-to-All میان GPUها، امکان می‌دهند تا هر جفت از GPUها با حداکثر سرعت ممکن با یکدیگر تبادل داده کنند. به عبارت دیگر، در یک سامانه مجهز به NVLink Switch، دیگر خبری از گلوگاه اشتراک‌گذاری پهنای باند میان چندین GPU نیست. هر GPU می‌تواند به طور همزمان با تمام GPUهای دیگر در بالاترین نرخ ممکن ارتباط برقرار کند. این قابلیت برای الگوریتم‌هایی مانند کاهش توزیع‌شده یا All-Reduce که در آموزش مدل‌های عمیق بسیار پرکاربرد هستند، حیاتی است.

تکامل نسل‌ها و پهنای باند

فناوری NVLink از زمان معرفی تاکنون دستخوش تحولات سریعی بوده است. هر نسل از این فناوری تقریباً دو برابر نسل قبل پهنای باند ارائه داده است و انویدیا را قادر ساخته تا همگام با رشد تصاعدی نیازهای محاسباتی حرکت کند.

فناوری NVLink

نسل اول NVLink که در سال ۲۰۱۶ عرضه شد، پهنای باند ۱۶۰ گیگابایت بر ثانیه به ازای هر GPU ارائه می‌داد که در آن زمان، جهشی چشمگیر نسبت به PCIe نسل سوم محسوب می‌شد.

نسل دوم با معماری Volta در سال ۲۰۱۷، این رقم را به ۳۰۰ گیگابایت بر ثانیه رساند. نسل سوم که در معماری Ampere در سال ۲۰۲۰ معرفی شد، پهنای باند ۶۰۰ گیگابایت بر ثانیه را ارائه کرد. در نسل چهارم که با معماری NVIDIA Hopper معرفی شد، پهنای باند هر GPU به ۹۰۰ گیگابایت بر ثانیه رسید.

نسل پنجم که هم‌زمان با معماری NVIDIA Blackwell عرضه شد، این رقم را به یک هزار و هشتصد گیگابایت بر ثانیه یا ۱.۸ ترابایت بر ثانیه افزایش داد. اخیراً نیز نسل ششم این فناوری برای پلتفرم NVIDIA Rubin معرفی شده است که پهنای باند استثنایی سه هزار و ششصد گیگابایت بر ثانیه یا ۳.۶ ترابایت بر ثانیه به ازای هر GPU ارائه می‌کند.

این میزان پهنای باند بیش از چهارده برابر استاندارد PCIe نسل ششم است که حداکثر ۲۵۶ گیگابایت بر ثانیه پهنای باند دوطرفه دارد.

برای درک بهتر این اعداد، باید به توان تجمیع‌شده در یک سامانه کامل توجه کرد. برای نمونه، در سامانه مرجع GB200 NVL72 که از ۷۲ GPU و ۳۶ پردازنده مرکزی Grace استفاده می‌کند، پهنای باند کل تجمیع‌شده به یکصد و سی ترابایت بر ثانیه می‌رسد. این میزان پهنای باند عظیم امکان هماهنگی لحظه‌ای میان همه پردازنده‌ها را در حین اجرای مدل‌های بزرگ هوش مصنوعی فراهم می‌سازد.

مزایای کلیدی و قابلیت‌های نرم‌افزاری

افزایش صرف پهنای باند، تنها مزیت NVLink نیست. این فناوری با ایجاد فضای آدرس حافظه یکپارچه یا Unified Memory Space میان GPUهای متصل، برنامه‌نویسی را برای توسعه‌دهندگان ساده‌تر می‌کند. در این مدل، برنامه‌نویس می‌تواند بدون نگرانی از محل فیزیکی داده، به یک آدرس حافظه واحد در سراسر همه GPUها دسترسی داشته باشد. سخت‌افزار NVLink به طور خودکار ترجمه آدرس و انتقال داده‌ها را در پس‌زمینه انجام می‌دهد. همچنین، مکانیزم‌های توکار برای تحمل خطا و Resiliency در نظر گرفته شده است که امکان تعویض قطعات بدون خاموش کردن سامانه یا Hot-swapping را فراهم می‌کند. در یک مرکز داده بزرگ، قابلیت تعویض یک ماژول معیوب بدون توقف محاسبات روی هزاران GPU دیگر، ارزش اقتصادی عظیمی دارد.

از منظر نرم‌افزاری، انویدیا کتابخانه‌های ارتباطی قدرتمندی مانند NCCL یا NVIDIA Collective Communications Library را ارائه داده است. این کتابخانه‌ها به‌طور خودکار از توپولوژی NVLink برای بهینه‌سازی عملیات جمعی مانند All-Reduce، Broadcast و Scatter-Gather بهره می‌برند. سرویس دیگری به نام IMEX یا Internode Memory Exchange نیز مدیریت حافظه اشتراکی میان گره‌های مختلف را تسهیل می‌کند. این لایه نرم‌افزاری باعث می‌شود تا برنامه‌های کاربردی بدون تغییر در کد اصلی، از مزایای پهنای باند بالای NVLink بهره‌مند شوند. در مجموع، NVLink ترکیبی از سخت‌افزار پیشرفته و نرم‌افزار هوشمند است که شکاف میان قابلیت‌های فیزیکی و کاربردپذیری عملی را پر می‌کند.

NVLink Fusion و چشم‌انداز آینده

انویدیا به تازگی توسعه فناوری جدیدی به نام NVLink Fusion را آغاز کرده است. این فناوری به شرکت‌های بزرگ فعال در حوزه ابری و ابرمقیاس یا Hyperscalerها اجازه می‌دهد تا پردازنده‌های سفارشی خود را نیز به شبکه NVLink متصل کنند.

با استفاده از استانداردهای باز مانند UCIe یا Universal Chiplet Interconnect Express، این شرکت‌ها می‌توانند پردازنده‌های اختصاصی یا XPU خود را طراحی کرده و آن‌ها را با استفاده از تراشه‌های NVLink به GPUهای انویدیا متصل نمایند.

این رویکرد، بسته‌ای بودن اکوسیستم انویدیا را تا حدی کاهش می‌دهد و امکان سفارشی‌سازی برای نیازهای خاص هر مشتری را فراهم می‌کند. در آینده، می‌توان انتظار داشت که NVLink به استانداردی واقعی برای ارتباطات درونی در مراکز داده تبدیل شود، جایگاهی که امروز InfiniBand و Ethernet برای ارتباط بین‌راکی دارند.

نتیجه‌گیری

فناوری NVLink تحولی بنیادین در نحوه ارتباط پردازنده‌های گرافیکی در مراکز داده مدرن ایجاد کرده است. این فناوری با غلبه بر محدودیت‌های ذاتی گذرگاه PCIe از طریق ارائه پهنای باند بسیار بالا، تأخیر فوق‌العاده پایین و ایجاد فضای حافظه یکپارچه، نیازهای شدید محاسباتی برنامه‌های پیشرفته برای سیستم های هوش مصنوعی و شبیه‌سازی‌های علمی را برآورده می‌سازد.

فناوری NVLink

از سامانه‌های کوچک چهار GPU تا اَبَررایانه‌های غول‌پیکر متشکل از هفتاد و دو GPU در یک شاسی، NVLink به عنوان ستون فقرات محاسباتی عمل می‌کند.

با معرفی قابلیت‌هایی مانند NVLink Fusion، این فناوری مسیر خود را به سوی آینده‌ای بازتر و قابل سفارشی‌سازی ادامه می‌دهد و نقش محوری خود را در عصر هوش مصنوعی و محاسبات با عملکرد بالا تثبیت می‌کند. بدون شک، پیشرفت‌های آینده در زمینه هوش مصنوعی، تا حد زیادی مرهون توانایی فنّاوری‌هایی مانند NVLink در هماهنگ‌سازی هزاران پردازنده به صورت یکپارچه و کارآمد خواهد بود.

سرورهای DGX انویدیا

معرفی سرورهای DGX انویدیا

در عصر کنونی، هوش مصنوعی به عنوان نیروی محرکه تحول دیجیتال در صنایع مختلف ظهور یافته است. با این حال، پیاده‌سازی و مقیاس‌پذیری زیرساخت‌های هوش مصنوعی همواره با چالش‌های قابل توجهی از جمله پیچیدگی یکپارچه‌سازی سخت‌افزار و نرم‌افزار، هزینه‌های سنگین مهندسی، و زمان‌بر بودن فرآیند راه‌اندازی همراه بوده است. سرورهای DGX شرکت انویدیا به عنوان راهکاری جامع و یکپارچه برای رفع این موانع طراحی شده‌اند.

پیشرفت‌های سریع در حوزه هوش مصنوعی، به ویژه در زمینه یادگیری عمیق و مدل‌های زبانی بزرگ، تقاضا برای توان محاسباتی بی‌سابقه‌ای را ایجاد کرده است. سازمان‌ها و پژوهشگران برای آموزش مدل‌هایی با میلیاردها پارامتر به زیرساختی نیاز دارند که فراتر از توان سرورهای سنتی باشد.

با این حال، مسیر دستیابی به چنین زیرساختی اغلب با دشواری‌هایی نظیر ناسازگاری اجزای سخت‌افزاری، پیچیدگی پیکربندی نرم‌افزارهای متن‌باز، و هزینه‌های بالای نگهداری همراه است. در این راستا، شرکت انویدیا خانواده سرورهای DGX را به عنوان «مولفه هوش مصنوعی» یا «ماشین هوش مصنوعی» یکپارچه معرفی کرده است.

هدف این دستگاه‌ها، ارائه یک راه حل کلید در دست است که پیچیدگی‌های ساخت و راه‌اندازی زیرساخت سیستم های هوش مصنوعی را از دوش کاربران بردارد .

مفهوم و جایگاه سرورهای DGX

سرورهای DGX که مخفف عبارت «مولفه هوش مصنوعی» هستند، دستگاه‌هایی از پیش پیکربندی شده و بهینه‌سازی شده‌اند که به طور اختصاصی برای اجرای بارهای کاری سنگین هوش مصنوعی و یادگیری ماشین طراحی شده‌اند.

سرورهای DGX انویدیا

برخلاف سرورهای معمولی و سیستم های رندرینگ اسمبل شده که ممکن است ترکیبی از قطعات مختلف تولیدکنندگان گوناگون باشند، سرور DGX به عنوان یک دستگاه یکپارچه یا «مولفه» عرضه می‌شود.

این بدان معناست که شرکت انویدیا تمام اجزا از جمله پردازنده‌های گرافیکی، پردازنده‌های مرکزی، حافظه، ذخیره‌سازی، اتصالات شبکه و مهمتر از همه، پشته نرم‌افزاری را از پیش انتخاب و بهینه‌سازی کرده است . نخستین نسخه از این سرورها با نام DGX-1 در سال ۲۰۱۶ معرفی شد و از آن زمان تاکنون، این خانواده همواره در خط مقدم تحول سخت‌افزاری هوش مصنوعی قرار داشته است .

معماری فنی و اجزای کلیدی سرورهای DGX انویدیا

قلب تپنده سرورهای نسل جدید DGX، از جمله مدل H100 و H200، توسط هشت پردازنده گرافیکی H100 یا H200 شرکت انویدیا تشکیل شده است. مدل H100 دارای ۶۴۰ گیگابایت حافظه مجتمع است، در حالی که مدل H200 این مقدار را به ۱۱۲۸ گیگابایت افزایش می‌دهد .

افزون بر این، دو پردازنده مرکزی Intel Xeon، مجموعاً ۲ ترابایت حافظه سیستم و ۳۰ ترابایت حافظه ذخیره‌سازی NVMe SSD در این سرورها تعبیه شده است .

سرورهای DGX انویدیا

با این حال، آنچه سرورهای DGX را از مجموعه‌ای از قطعات مجزا متمایز می‌کند، فناوری ارتباطی اختصاصی به کار رفته در آن است. هر یک از هشت پردازنده گرافیکی از طریق چهار سوئیچ NVSwitch نسل چهارم و فناوری NVLink به یکدیگر متصل می‌شوند .

این معماری، پهنای باند دوسویه بسیار بالایی به میزان ۹۰۰ گیگابایت بر ثانیه بین هر جفت پردازنده گرافیکی فراهم می‌آورد. چنین سرعت ارتباطی برای آموزش مدل‌های بزرگ که نیازمند تبادل مداوم داده میان پردازنده‌ها هستند، نقشی حیاتی دارد. در غیر این صورت، بخش قابل توجهی از زمان پردازش صرف ارتباطات می‌شود .

در بخش شبکه خارجی نیز این سرورها مجهز به کارت‌های شبکه ConnectX-7 با سرعت ۴۰۰ گیگابیت بر ثانیه هستند که امکان ایجاد خوشه‌های قدرتمند از چندین دستگاه DGX را فراهم می‌آورد .

نرم‌افزار؛ عامل تمایز اصلی

اگرچه سخت‌افزار قدرتمند ستون فقرات این سرورها را تشکیل می‌دهد، اما ارزش واقعی سرورهای DGX در بسته نرم‌افزاری یکپارچه آن‌ها نهفته است. این دستگاه‌ها به صورت پیش‌فرض با مجموعه نرم‌افزاری NVIDIA AI Enterprise عرضه می‌شوند.

این مجموعه شامل کتابخانه‌هایی همچون CUDA و cuDNN، فریمورک‌های بهینه‌سازی شده یادگیری عمیق، و ابزارهای مدیریت کانتینر مانند Docker و Kubernetes است .

این رویکرد «کلید در دست» بدان معناست که سازمان‌ها بلافاصله پس از نصب فیزیکی سرور، بدون نیاز به صرف ماه‌ها زمان برای کامپایل و پیکربندی کتابخانه‌های متن‌باز و رفع تداخلات نرم‌افزاری، قادر به اجرای مدل‌های خود خواهند بود.

همچنین، داشتن قرارداد پشتیبانی از سوی انویدیا، دسترسی به تیمی از متخصصان به نام DGXpert را فراهم می‌آورد که در بهینه‌سازی عملکرد و عیب‌یابی سیستم به کاربران یاری می‌رسانند .

مقیاس‌پذیری از میز کار تا ابررایانه

خانواده DGX تنها به دستگاه‌های مرکز داده محدود نمی‌شود و نیازهای متنوع کاربران را پوشش می‌دهد. برای توسعه‌دهندگان و پژوهشگرانی که به یک ایس تگاه کاری قدرتمند روی میز نیاز دارند، مدل‌هایی مانند DGX Station و DGX Spark (که پیش‌تر با نام DGX Orin شناخته می‌شد) طراحی شده‌اند.

سرورهای DGX انویدیا

این دستگاه‌های رومیزی که از ابرتراشه Grace Blackwell بهره می‌برند، امکان توسعه و آزمایش مدل‌های هوش مصنوعی را در محیط محلی فراهم می‌کنند و سپس قابلیت انتقال آسان آن مدل‌ها به خوشه‌های بزرگ‌تر را دارند .

در سوی دیگر طیف، سرورهای DGX قابلیت تجمیع در معماری‌های بزرگ‌تری به نام SuperPOD را دارند. یک ابرخوشه DGX SuperPOD می‌تواند شامل صدها گره DGX باشد که توسط شبکه‌های پرسرعت InfiniBand به هم متصل شده و به عنوان یک ابررایانه غول‌پیکر عمل می‌کنند.

جالب توجه است که در زمان معرفی، برخی از این ابرخوشه‌ها در فهرست سریع‌ترین ابررایانه‌های جهان قرار گرفته‌اند . جدیدترین نسل این سامانه‌ها از خنک‌کنندگی مایع برای مدیریت حرارت بالای تولید شده توسط تراشه‌های قدرتمند استفاده می‌کنند .

کاربردها و چشم‌انداز آینده

سرورهای DGX در صنایع گوناگونی از جمله داروسازی برای کشف دارو، خودروسازی برای توسعه خودروهای خودران، و خدمات مالی برای تشخیص تقلب مورد استفاده قرار می‌گیرند .

افزون بر استقرار در محل سازمان‌ها، شرکت انویدیا سرویس DGX Cloud را نیز ارائه می‌دهد که به مشتریان اجازه می‌دهد از همین معماری قدرتمند به صورت اجاره‌ای در ابرسرویس‌هایی همچون Microsoft Azure و Oracle Cloud Infrastructure استفاده کنند .

نتیجه‌گیری

سرورهای DGX انویدیا پاسخی کامل به نیاز روزافزون به زیرساخت یکپارچه و کارآمد هوش مصنوعی هستند. این سامانه‌ها با ترکیب پردازنده‌های گرافیکی پیشرفته، معماری ارتباطی با پهنای باند بسیار بالا، حافظه و ذخیره‌سازی سریع، و مهمتر از همه، مجموعه نرم‌افزاری بهینه‌سازی شده، راه حلی کلید در دست ارائه می‌دهند.

این یکپارچگی عمیق، زمان لازم برای راه‌اندازی و آموزش مدل‌های هوش مصنوعی را از چند ماه به چند روز کاهش می‌دهد. با ظهور نسل‌های جدید مانند سکوی Grace Blackwell و افزایش قابلیت مقیاس‌پذیری تا سطح ابررایانه‌های عظیم، خانواده DGX همچنان به عنوان معیاری برای کارایی و قابلیت اطمینان در عصر کارخانه‌های هوش مصنوعی باقی خواهند ماند.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

در سال 2025 که هوش مصنوعی حتی دنیای پردازنده ها رو هم تحت تاثیر خودش قرار داده شرکت های محبوبی مثل AMD و Intel بیکار نمونده و با عرضه ی بهترین پردازنده ها با پشتیبانی از هوش مصنوعی به کاربر کمک میکنن تا بتونه مدل ها و پروژه های AI رو با سرعت و قدرت بالا اجرا کنه.

مثلا اینتل با معرفی Core i7 و Core i9 تجربه ای روان و سریع به کاربران هوش مصنوعی دسکتاپ و لپتاپ ها میده و واسه ی سرورها و دیتاسنتر هم Xeon Scalable رو ارائه کرده.

تازه به فکر دستگاه های کوچک هم بوده تا بدون مصرف بالای انرژی بتونن برای اجرای پروژه های هوش مصنوعی از سری Atom استفاده کنند. در کنار اینتل رقیب همیشگیش یعنی ای ام دی هم دست به کار شده و پردازنده هایی مثل  Ryzen 7 7700X، Ryzen 9 7950X، Threadripper PRO 7995WX و EPYC 9654 رو عرضه کرده.

حتی شتاب دهنده هایی مثل Habana Gaudi 2 هم واسه دیتاسنترها و اجرای بدون مشکل کارهای Ai عرضه شده اند که خوبه با ویژگی، قابلیتها و حتی معایبشون آشنا بشی و واسه همین هم ازت میخوام تا آخر این مقاله از دیجی بینو همراهم باشی 😍.

بهترین سی پی یو برای هوش مصنوعی

در ادامه بهترین و قویترین پردازنده های هوش مصنوعی از شرکت های ای ام دی و اینتل برای سیستم های مخصوص هوش مصنوعی و سیستم های رندرینگ رو بهت معرفی کردم، پس بزن بریم… ✌

AMD Ryzen 7 7700X: پردازنده مقرون به صرفه

اگه با بودجه ی محدود دنبال یه پردازنده واسه اجرای پروژه های هوش مصنوعی هستی بهت ای ام دی مدل Ryzen 7 7700X رو پیشنهاد میکنم، این قطعه با 8 هسته و 16 رشته، توان پردازشی بالایی داره.

اگه بخوام از مشخصات این پردازنده بیشتر واست توضیح بدم باید بدونی که فرکانس پایه آن 4.5 گیگاهرتز هستش و در حالت بوست به 5.4 گیگاهرتز هم میرسه.

AMD Ryzen 7 7700X مجهز به حافظه ی DDR5 بوده و با پشتیبانی از رم 128 گیگابایتی و واحد گرافیکی AMD Radeon Graphics عملکرد قابل قبولی در پروژه های هوش مصنوعی داره و دیگه نیازی به خرید کارت گرافیک مجزا نیست.

راستی توان مصرفی این پردازنده 105 بوده که در مقایسه با سریهای قبل عدد قابل توجهی است و تازه واسه گیمینگ 🎮 و تولید محتوا هم انتخاب خوبیه.

 AMD Ryzen Threadripper PRO 7995WX: غول پردازشهای سنگین

اگه دنبال پردازنده ای با قدرت بسیار بالا هستی بهت Ryzen Threadripper PRO 7995WX از ای ام دی رو پیشنهاد میکنم، ببین همونطور که بهت گفتم با یه پردازنده ی قوی طرفی که ازش در مراکز داده، تیم های تحقیقاتی و ایستگاه های کاری پیشرفته استفاده میشه.

این پردازنده با معماری Zen 4 و به صورت 96 هسته و 192 رشته ای طراحی شده و واسه پردازش های سنگین، پروژه های هوش مصنوعی، رندرینگ و… مناسبه.

البته باید بدونی که قیمت این پردازنده با توجه به کارایی آن کمی گرونه 💰.

این cpu با داشتن هسته های زیاد و توان پردازش عالی بهترین گزینه برای پردازشهای سنگین و مدلهای هوش مصنوعی متوسط تا سنگین است.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

AMD Ryzen 9 7950X: ایده آل برای AI و گیمینگ

و اما یکی دیگه از پردازنده های قدرتمند باز هم از شرکت ای ام دی از سری 7000 با نام AMD Ryzen 9 7950X است که مجهز به 16 هسته و 32 رشته بوده و بهترین انتخاب برای پروژه های هوش مصنوعی به حساب میاد، این قطعه کش بالایی داشته و عملکرد قوی چند رشته ای آن باعث عملکرد روان و راحت میشه.

از ویژگیهای دیگه ی AMD RYZEN 9 7950X میتونم به لیتوگرافی 5 نانومتری، فرکانس پایه 4.5 گیگاهرتز و فرکانس بوست 5.7 گیگاهرتزی اشاره کنم.

پردازنده ی Ryzen 9 7950X مجهز به واحد NPU داخلی بوده و میتونه پروژه های AI سبک تا متوسط رو اجرا کنه.

این قطعه برای گیمینگ و تولید محتوا هم انتخاب خوبیه.

AMD EPYC 9654 : مناسب پروژه های بزرگ هوش مصنوعی!

به طور کلی پردازنده های سری EPYC واسه پروژه های بزرگ و استفاده در سرورها و دیتاسنترها طراحی شدند و EPYC 9654 ای ام دی هم دارای 96 هسته و 192 رشته پردازشی است؛ این قطعه با فناوری ساخت 5 نانومتری بهترین انتخاب برای تیم ها و شرکت هایی است که میخوان پروژه های هوش مصنوعی رو با حجم داده های خیلی زیاد اجرا کنند.

اگه بخوام از مزیتهای این پردازنده بهت بگم میتونم به قدرت بالا در اجرای برنامه های سنگین و پیچیده، کش بالا، پردازش حجم بالا و مصرف بهینه ی انرژی اشاره کنم.

Intel Core i7 و i9: سبک و سریع

نسلهای جدید پردازنده های Core i7  و i9 به دلیل اینکه مجهز به واحد پردازش عصبی هستند میتونن پروژه های هوش مصنوعی سبک تا متوسط رو اجرا کنند.

در واقع این نسل از پردازنده های اینتل مجهز به NPU داخلی بوده و توان پردازش AI رو دارند و ویژگی هایی مثل مصرف انرژی کم، سازگاری خوب با نرم افزارهای مختلف آنها رو به بهترین پردازنده با پشتیبانی از هوش مصنوعی از شرکت اینتل تبدیل کرده است.

این CPU ها واسه کاربران دسکتاپ و لپتاپ که نمیخواهند مدلهای سنگین رو اجرا کنند انتخاب خوبی خواهد بود اما همونطور که بهت گفتم این سخت افزارها امکان پردازش های خیلی سنگین AI رو ندارند.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

نسل Sapphire Rapids: قدرت بالای AI برای سرورها

پردازنده ی بعدی که میخوام بهت معرفی کنم به عنوان پردازنده های سروری و مخصوص دیتا سنترها طراحی شده اند که یکسری از مدل ها مثل Intel Xeon Scalable برای پردازش های هوش مصنوعی بهینه شده و قادر به انجام پردازش های سنگین هستند.

پشتیبانی از نرم افزارهای سروری و قدرت پردازش بالا در داده ها رو میشه به عنوان اصلی ترین مزیت این قطعه نام برد اما باید بدونی که این پردازنده قیمت و مصرف انرژی بالایی داره.

Intel Atom: کم مصرف

یکی دیگه از CPU هایی که از هوش مصنوعی پشتیبانی میکنه و باز هم از شرکت اینتل است پردازنده های Atom بوده که مصرف انرژی پایینی دارند و مناسب پردازشهای هوش مصنوعی سبک هستند.

پس اگه دنبال یک پردازنده واسه اجرای پروژه های AI سبک واسه دستگاه های کم مصرف هستی پردازنده های  Atom انتخاب خوبی خواهند بود.

Habana Gaudi 2: پردازش سریع هوش مصنوعی

ببین Habana Gaudi 2 توسط زیر مجموعه ی اینتل طراحی و عرضه شده و میشه بهش گفت یک شتاب دهنده AI که میتونه در اجرای مدل های هوش مصنوعی بهت کمک کنه.

این قطعه توان پردازشی بالایی برای هوش مصنوعی داره اما مصرف بالای انرژی رو میشه یکی از معایب آن دانست.

AMD Ryzen AI 9 9950X (سری 9000): اجرای روان با قدرت بالا

یکی دیگه از پردازنده های قدرتمند با پشتیبانی از هوش مصنوعی Ryzen AI 9 9950X نام داره که مجهز به NPU داخلی اختصاصی است و میتونه مدل های سنگین AI رو اجرا کنه.

از جمله مهمترین مزیت های این CPU میتونم به توان پردازشی بالا و اجرای روان هوش مصنوعی اشاره کنم. البته باید بدونی که پردازنده قیمت بالایی داشته و نیاز به سیستم خنک کننده ی مناسب داره.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

چرا پردازنده مناسب برای هوش مصنوعی اهمیت دارد؟

همونطور که میدونی پردازنده ها مغز سیستم هستند و قدرت بالای آن ها به پردازش سریع داده ها کمک میکنه و واسه اجرای مدل های AI حتما باید بری سراغ CPU هایی که از هوش مصنوعی پشتیبانی میکنند.

حالا میدونی چرا بهت میگم پردازنده های مرکزی با پشتیبانی از هوش مصنوعی رو انتخاب کنی؟

✓ قدرت پردازشی بالا

از آنجایی که الگوریتم های هوش مصنوعی و یادگیری ماشین نیاز به توان محاسباتی بالایی داره باید از پردازنده های مرکزی استفاده کنی که از هوش مصنوعی پشتیبانی می کنند.

✓ بهره وری بیش تر و مصرف انرژی کمتر

از دیگر دلایل استفاده از سی پی یوهای مبتنی بر هوش مصنوعی اینه که این قطعات واسه اجرای پروژه های هوش مصنوعی طراحی شده اند و به دلیل دارا بودن NPU (واحد پردازش عصبی) میتونن مدل های AI رو با مصرف انرژی کمتر و به صورت بهینه اجرا کنند.

✓ کاربرد گسترده

با کمک cpu های هوش مصنوعی میتونی علاوه بر مدل های AI به راحتی پروژه های شبیه سازی، طراحی های سه بعدی رو اجرا کنی تازه این پردازنده های مرکزی انتخاب خوبی واسه گیمینگ هستند.

فاکتورهای مهم در انتخاب پردازنده هوش مصنوعی

حالا که بهترین پردازنده ها با پشتیبانی از هوش مصنوعی آشنا شدی و فهمیدی سیستم مورد نیاز برای هوش مصنوعی نیاز به چه سی پی یوهایی داره لازمه که بهت بگم اصلی ترین فاکتورها در انتخاب پردازنده مرکزی چیاس! پس با من همراه باش… 😊

  • توان پردازشی

قطعا اولین و مهمترین فاکتور، قدرت پردازشی سی پی یو است، در واقع هر چه این سخت افزار هوش مصنوعی قدرتمندتر باشه میتونه داده های پیچیده و مدل های بزرگ هوش مصنوعی رو با سرعت بالا پردازش کنه و این خییییلی جذابهههه… 😍

  • تعداد هسته ها

همونطور که میدونی خیلی از الگوریتم های AI نیاز به انجام عملیات مختلف همزمان دارند و واسه همین هم آن دسته از پردازنده ها که هسته های بیش تری داشته و از فناوری هایی مثل Hyper-Threading یا SMT پشتیبانی میکنند انتخاب بهتری خواهند بود.

  • میزان مصرف انرژی

نکته ی مهم دیگه مصرف بهینه ی انرژی است که البته در پروژه های بزرگ اهمیت بیشتری پیدا میکنه، بهت گفتم که پردازنده هوش مصنوعی قدرت بالای پردازش داره و خوبه که در حین قدرت بالا مصرف انرژی کمی داشته باشه.

  • حافظه

وجود پهنای باند مناسب و حافظه کش زیاد به جابه جایی سریع داده ها بین هسته و حافظه و اجرای روان پروژه ها کمک خواهد کرد.


  • هماهنگی با دیگر قطعات سخت افزاری

یک CPU مناسب باید با دیگر قطعات سخت افزاری هماهنگی کاملی داشته باشه تا سرعت اجرای مدل ها افزایش پیدا کنه، حالا اگه دوست داری با بهترین کارت گرافیک برای هوش مصنوعی و البته ارزونترینشون آشنا بشی حتما سری به مقاله ی “هفت کارت گرافیک ارزان برای هوش مصنوعی” بزن که به دردت میخوره.

بهترین پردازنده ها با پشتیبانی از هوش مصنوعی

نتیجه گیری:

اگه کاربر عادی هستی و واسه لپتاپ و اجرای هوش مصنوعی های سبک دنبال سی پی یو هستی Intel Core i7/i9 و  AMD Ryzen 7 7700Xانتخاب خوبیه ولی اگه هدفت اجرای AI های سنگین تره میتونی بری سراغ Ryzen Threadripper PRO و Ryzen AI 9 9950X.

و اما در آخر…

از اینکه تا آخر این مقاله همراهم بودی ازت ممنونم، امیدوارم الان با بهترین پردازنده ها با پشتیبانی از هوش مصنوعی آشنا شده باشی، اگه دنبال خرید بهترین لپ تاپ با هوش مصنوعی یا کیس هوش مصنوعی هستی بهت پیشنهاد میکنم واسه خرید سیستم هوش مصنوعی با مناسب ترین قیمت سری به صفحه ی سیستم های هوش مصنوعی دیجیبینو بزنی؛ مطمئنم میتونی سیستم دلخواهت رو با قیمت مناسب خریداری کنی، راستی اگه نیاز به مشاوره هم داری کافیه با کارشناسان ما در ارتباط باشی، به همین سادگی! 😉

رم برای سیستم‌های هوش مصنوعی

چه میزان رم برای سیستم‌های هوش مصنوعی لازم است؟

در سال‌های اخیر، هوش مصنوعی به یکی از مهم‌ترین بخش‌های فناوری تبدیل شده است. از تشخیص چهره در گوشی‌های هوشمند گرفته تا ترجمه متون و حتی خودروهای خودران، همه این‌ها با کمک هوش مصنوعی ممکن شده‌اند. اما برای اجرای این فناوری‌ها، تنها داشتن نرم‌افزار کافی نیست. سخت‌افزار مناسب هم نقش بسیار مهمی دارد.

یکی از مهم‌ترین بخش‌های سخت‌افزار در این زمینه، حافظه رم (RAM) است. رم جایی است که اطلاعات در زمان اجرای برنامه‌ها به صورت موقت ذخیره می‌شود. اگر مقدار رم کافی نباشد، حتی بهترین الگوریتم‌ها هم به کندی اجرا می‌شوند یا اصلاً اجرا نمی‌شوند.

در این مقاله می‌خواهیم بررسی کنیم که برای اجرای پروژه‌های مختلف در زمینه هوش مصنوعی، چه مقدار رم برای سیستم های هوش مصنوعی لازم است. از کارهای ساده مثل اجرای یک چت‌بات گرفته تا آموزش مدل‌های پیچیده یادگیری عمیق، در هر مورد بررسی خواهیم کرد که چقدر رم نیاز دارید و چرا.

رم چیست و چه نقشی در سیستم دارد؟

رم یا همان حافظه موقت (Random Access Memory) یکی از اصلی‌ترین اجزای سخت‌افزار در هر کامپیوتر یا لپ‌تاپ است.

رم برای سیستم‌های هوش مصنوعی

برخلاف هارد دیسک یا حافظه SSD که اطلاعات را به صورت دائمی ذخیره می‌کنند، رم فقط برای ذخیره‌سازی موقتی اطلاعات در زمان اجرای برنامه‌ها استفاده می‌شود.

وقتی یک برنامه را باز می‌کنید یا یک مدل هوش مصنوعی را اجرا می‌کنید، بخش زیادی از داده‌ها و دستورها وارد رم می‌شوند. به این ترتیب، پردازنده می‌تواند با سرعت بالا به اطلاعات دسترسی پیدا کند و کارها را سریع‌تر انجام دهد. اگر رم کافی نباشد، سیستم به حافظه‌های کندتر مثل هارد دیسک مراجعه می‌کند که باعث کاهش شدید سرعت می‌شود.

در پروژه‌های هوش مصنوعی، معمولاً حجم زیادی از داده‌ها باید هم‌زمان پردازش شوند. مدل‌های یادگیری ماشین و یادگیری عمیق نیز نیاز به بارگذاری بخش زیادی از اطلاعات در حافظه دارند. به همین دلیل، رم نقش حیاتی در اجرای روان و سریع این برنامه‌ها دارد.

انواع کاربردهای هوش مصنوعی و نیازهای رم هرکدام

میزان رم مورد نیاز در پروژه‌های هوش مصنوعی بستگی مستقیم به نوع کار، حجم داده‌ها و پیچیدگی مدل دارد. در این بخش، کاربردهای رایج را به سه دسته کلی تقسیم می‌کنیم:

رم برای سیستم‌های هوش مصنوعی

  • کاربردهای سبک: نیاز به رم ۸ تا ۱۶ گیگابایت

در این دسته، پروژه‌هایی قرار دارند که حجم داده‌ در آن‌ها کم است و پردازش‌ها ساده‌اند. مثلاً:

طراحی چت‌بات‌های ساده

تحلیل اولیه داده‌ها با پایتون و کتابخانه‌هایی مثل Pandas

استفاده از مدل‌های آماده با داده‌های محدود (مثلاً طبقه‌بندی متن‌های کوتاه)

در این موارد، یک سیستم با ۸ تا ۱۶ گیگابایت رم معمولاً کافی است. البته اگر چند برنامه هم‌زمان اجرا شوند یا حجم فایل‌ها بیشتر از حد معمول باشد، ممکن است به رم بالاتر نیاز باشد.

  • کاربردهای متوسط: نیاز به رم ۱۶ تا ۳۲ گیگابایت

وقتی وارد پروژه‌هایی می‌شویم که نیاز به پردازش تصویر، تحلیل صوت یا اجرای مدل‌های یادگیری ماشین متوسط دارند، نیاز به رم هم افزایش پیدا می‌کند. برای مثال:

شناسایی اشیا در تصاویر با مدل‌های آماده مثل YOLO یا MobileNet

تحلیل صوت و گفتار

آموزش مدل‌های سبک با داده‌های واقعی

استفاده از فریم‌ورک‌هایی مثل TensorFlow یا PyTorch برای پروژه‌های متوسط

در این موارد، رم بین ۱۶ تا ۳۲ گیگابایت توصیه می‌شود تا هم اجرای مدل روان باشد و هم سیستم دچار کندی یا هنگ نشود.

  • کاربردهای سنگین: نیاز به رم ۶۴ گیگابایت یا بیشتر

در پروژه‌هایی که شامل یادگیری عمیق (Deep Learning) یا پردازش حجم بزرگی از داده‌ها هستند، نیاز به رم به‌طور چشمگیری افزایش می‌یابد. این کاربردها شامل موارد زیر هستند:

آموزش شبکه‌های عصبی بزرگ مثل Transformer یا مدل‌های زبان پیشرفته

پردازش و تحلیل ویدیو با کیفیت بالا

کار با دیتاست‌های سنگین مانند ImageNet یا دیتاست‌های پزشکی

استفاده از چند GPU به‌صورت هم‌زمان

در این شرایط، رم ۶۴ گیگابایت یا حتی بیشتر (۱۲۸ گیگابایت یا بالاتر) ممکن است ضروری باشد. حتی با وجود GPU قدرتمند، اگر رم کافی نباشد، سیستم نمی‌تواند اطلاعات مورد نیاز را به‌موقع به GPU منتقل کند و راندمان کار پایین می‌آید.

در نتیجه، انتخاب میزان رم مناسب کاملاً بستگی به نوع پروژه و منابع مورد استفاده دارد.

رم مورد نیاز برای آموزش مدل در برابر اجرای مدل

در پروژه‌های هوش مصنوعی، معمولاً دو مرحله اصلی وجود دارد: مرحله آموزش (Training) و مرحله اجرا یا پیش‌بینی (Inference).

رم برای سیستم‌های هوش مصنوعی

هر یک از این مراحل، نیازهای سخت‌افزاری متفاوتی دارند، به‌ویژه از نظر رم.

  • آموزش مدل (Training): نیاز به رم بالا

در مرحله آموزش، مدل باید داده‌های زیادی را بارها و بارها پردازش کند تا الگوها را یاد بگیرد. این فرآیند پیچیده و زمان‌بر است و معمولاً به رم زیادی نیاز دارد. به ویژه اگر:

اندازه دیتاست بزرگ باشد

مدل ساختار پیچیده‌ای داشته باشد (مثل شبکه‌های عمیق یا مدل‌های زبانی)

از تکنیک‌هایی مثل پردازش موازی یا چند GPU استفاده شود

برای این نوع پروژه‌ها، رم کمتر از ۳۲ یا ۶۴ گیگابایت معمولاً کافی نیست. در موارد حرفه‌ای، حتی رم‌های ۱۲۸ گیگابایتی یا بیشتر استفاده می‌شود. نبود رم کافی در این مرحله می‌تواند باعث کندی شدید، خطای اجرا یا شکست کامل فرآیند آموزش شود.

  • اجرای مدل (Inference): نیاز به رم کمتر

در مرحله اجرای مدل، سیستم از مدل آموزش‌دیده برای پیش‌بینی یا تحلیل استفاده می‌کند. دراین حالت، داده‌ها معمولاً کوچک‌تر هستند و مدل فقط یک‌بار آن‌ها را پردازش می‌کند.

نتیجه اینکه، میزان رم مورد نیاز بسیار کمتر از مرحله آموزش است. در بسیاری از موارد، حتی با رم ۸ تا ۱۶ گیگابایت هم می‌توان مدل‌های نسبتاً پیشرفته را اجرا کرد. برای مثال:

اجرای یک مدل طبقه‌بندی تصویر از پیش آموزش‌دیده

پاسخ‌گویی یک چت‌بات با مدل زبان آماده

تحلیل ساده متن یا عدد

البته اگر مدل بسیار بزرگ باشد (مثلاً مدل‌های زبانی جدید)، ممکن است حتی اجرای آن هم نیاز به رم بالا داشته باشد. اما در کل، Inference نسبت به Training رم کمتری مصرف می‌کند.

سایر عوامل مؤثر بر عملکرد کنار رم

در اجرای پروژه‌های هوش مصنوعی، رم یکی از عوامل کلیدی است؛ اما تنها عامل نیست. حتی اگر رم زیادی داشته باشید، اگر دیگر بخش‌های سیستم متناسب نباشند، باز هم با کندی یا خطا روبه‌رو می‌شوید. در این بخش، به چند عامل مهم دیگر اشاره می‌کنیم:

  • کارت گرافیک (GPU) و حافظه گرافیکی (VRAM)

در بسیاری از پروژه‌های یادگیری ماشین و به‌ویژه یادگیری عمیق، بخش زیادی از محاسبات توسط کارت گرافیک انجام می‌شود. کارت‌های گرافیکی مخصوص محاسبات (مثل سری NVIDIA RTX یا H100) دارای حافظه مخصوص به نام VRAM هستند.

اگر VRAM کافی نباشد، مدل‌های سنگین قابل آموزش یا اجرا نخواهند بود. حتی اگر رم سیستم زیاد باشد، اما کارت گرافیک ضعیف یا کم‌حافظه باشد، عملکرد به‌شدت کاهش می‌یابد.

  • پردازنده (CPU) مناسب

CPU یا همان پردازنده مرکزی، در کنار GPU وظیفه پردازش اطلاعات را دارد. در کارهایی که از GPU استفاده نمی‌شود، سرعت و قدرت CPU بسیار مهم می‌شود. پردازنده‌های چند هسته‌ای با فرکانس بالا می‌توانند فرآیندهای موازی را بهتر مدیریت کنند.

  • دیسک سخت و سرعت خواندن/نوشتن

اگر داده‌ها روی هارد دیسک‌های قدیمی (HDD) ذخیره شوند، سرعت بارگذاری آن‌ها به رم پایین خواهد بود. استفاده از حافظه‌های SSD به‌ویژه نوع NVMe می‌تواند سرعت سیستم را به شکل قابل توجهی افزایش دهد. این موضوع در پروژه‌هایی با حجم بالای داده بسیار اهمیت دارد.

  • بهینه‌سازی نرم‌افزاری

گاهی با وجود سخت‌افزار مناسب، کد پروژه بهینه نیست و منابع را به‌درستی استفاده نمی‌کند. استفاده از تکنیک‌هایی مانند:

Mini-batch processing

کاهش دقت مدل (مثلاً استفاده از float16 به‌جای float32)

استفاده از حافظه اشتراکی بین GPU و CPU

می‌تواند مصرف رم و منابع دیگر را کاهش دهد.

در نتیجه، هنگام بررسی عملکرد سیستم در پروژه‌های هوش مصنوعی، بهتر است همه اجزای سخت‌افزار و حتی شیوه کدنویسی را در نظر گرفت، نه فقط مقدار رم.

نتیجه‌گیری و پیشنهاد نهایی

هوش مصنوعی به بخشی جدانشدنی از فناوری امروز تبدیل شده و برای اجرای موفق پروژه‌های مرتبط با آن، تنها داشتن دانش برنامه‌نویسی کافی نیست. سخت‌افزار مناسب، به‌ویژه مقدار رم، نقش بسیار مهمی در سرعت، دقت و پایداری اجرای پروژه‌ها دارد.

در این مقاله دیدیم که:

  • پروژه‌های سبک با رم ۸ تا ۱۶ گیگابایت قابل اجرا هستند.
  • برای پروژه‌های متوسط، رم بین ۱۶ تا ۳۲ گیگابایت پیشنهاد می‌شود.
  • پروژه‌های سنگین مانند آموزش مدل‌های یادگیری عمیق به رم ۶۴ گیگابایت یا بیشتر نیاز دارند.
  • مرحله آموزش مدل معمولاً رم بیشتری نسبت به مرحله اجرا (Inference) مصرف می‌کند.

سایر عوامل مانند کارت گرافیک، پردازنده، حافظه SSD و بهینه‌سازی نرم‌افزاری نیز تأثیر مستقیم بر عملکرد دارند.اگر در حال برنامه‌ریزی برای شروع یک پروژه هوش مصنوعی هستید، بهتر است ابتدا نوع پروژه و نیازهای دقیق آن را مشخص کنید. سپس بر اساس آن، تصمیم بگیرید که چه مقدار رم و چه سخت‌افزاری برای شما مناسب است. در بسیاری از موارد، اگر امکان ارتقاء سخت‌افزار شخصی وجود ندارد، استفاده از سرویس‌های ابری مثل Google Colab، AWS یا Azure می‌تواند جایگزین مناسبی باشد.در نهایت، انتخاب دقیق و متناسب با نیاز باعث می‌شود نه تنها هزینه‌ها کاهش یابد، بلکه بهره‌وری سیستم نیز افزایش پیدا کند.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟

برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟ این سوال بسیاری از کاربران ابزار های هوش مصنوعی می باشد. در سال‌های اخیر، هوش مصنوعی به یکی از موضوعات داغ در دنیای فناوری تبدیل شده است. بسیاری از افراد از ابزارهای مختلف هوش مصنوعی برای تولید متن، ترجمه، طراحی تصویر، و حتی تحلیل داده‌ها استفاده می‌کنند. این ابزارها سرعت انجام کارها را افزایش داده و باعث صرفه‌جویی در زمان می‌شوند. اما برای استفاده مؤثر از این ابزارها، باید به توانایی‌های سخت‌افزاری دستگاه نیز توجه کرد. یکی از مهم‌ترین بخش‌های سخت‌افزار که نقش زیادی در اجرای درست این برنامه‌ها دارد، حافظه رم است.

در این مقاله، بررسی می‌کنیم که رم چیست، چرا برای اجرای ابزارهای هوش مصنوعی اهمیت دارد، و برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟

رم  چیست و چه نقشی در اجرای برنامه‌ها دارد؟

رم یا حافظه دسترسی تصادفی ، یکی از اجزای اصلی هر رایانه یا لپ‌تاپ است. زمانی که یک برنامه یا ابزار را باز می‌کنید، اطلاعات مورد نیاز آن به‌طور موقت در رم ذخیره می‌شود تا سرعت اجرا و عملکرد آن بهتر باشد. در واقع، رم مانند یک میز کار برای پردازنده است. هرچه این میز بزرگ‌تر باشد، برنامه‌های بیشتری را می‌توان هم‌زمان و بدون کندی اجرا کرد.

برخلاف حافظه‌هایی مانند هارد یا SSD که اطلاعات را به‌صورت دائمی ذخیره می‌کنند، رم اطلاعات را فقط زمانی نگه می‌دارد که سیستم روشن باشد. به محض خاموش شدن دستگاه، اطلاعات موجود در رم پاک می‌شود.

هرچه یک برنامه پیچیده‌تر باشد یا نیاز به پردازش داده‌های بیشتری داشته باشد، مقدار بیشتری از رم را اشغال می‌کند. ابزارهای هوش مصنوعی، به دلیل حجم زیاد داده‌هایی که پردازش می‌کنند، معمولاً به رم بیشتری نسبت به برنامه‌های معمولی نیاز دارند. به همین دلیل، دانستن مقدار رم مناسب و اینکه برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم؟ برای این ابزارها اهمیت زیادی دارد.

چرا رم در اجرای ابزارهای هوش مصنوعی مهم است؟

سیستم های هوش مصنوعی برای انجام وظایف خود به مقدار زیادی داده نیاز دارند. این داده‌ها باید به‌سرعت پردازش، تحلیل و گاهی ذخیره شوند. رم به‌عنوان حافظه‌ای که دسترسی به آن سریع است، نقش کلیدی در این فرایند ایفا می‌کند. زمانی که یک ابزار هوش مصنوعی فعال می‌شود، داده‌ها به‌صورت موقت در رم بارگذاری می‌شوند تا پردازنده بتواند با سرعت بیشتری آن‌ها را بررسی کند.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

اگر رم سیستم شما کم باشد، اجرای ابزارهای هوش مصنوعی با کندی یا حتی اختلال مواجه خواهد شد. ممکن است برنامه باز نشود، به‌درستی اجرا نشود، یا هنگام انجام پردازش متوقف شود. از سوی دیگر، رم بیشتر به سیستم اجازه می‌دهد تا چندین برنامه یا فرایند را به‌صورت هم‌زمان و بدون کاهش سرعت اجرا کند.

همچنین، بسیاری از ابزارهای هوش مصنوعی، به‌ویژه در زمینه پردازش تصویر، ویدئو یا مدل‌های زبانی بزرگ، حجم زیادی از رم را مصرف می‌کنند. به همین دلیل، انتخاب مقدار مناسب رم برای نوع ابزاری که می‌خواهید اجرا کنید و اینکه برای اجرای ابزارهای هوش مصنوعی چه مقدار رَم (RAM) نیاز داریم، موضوع بسیار مهمی است.

میزان رم مورد نیاز برای اجرای ابزارهای مختلف هوش مصنوعی

نیاز به رم در اجرای ابزارهای هوش مصنوعی به نوع و پیچیدگی آن‌ها بستگی دارد. برخی از این ابزارها به‌صورت آنلاین و ساده اجرا می‌شوند، در حالی که برخی دیگر، برای اجرای درست به سخت‌افزارهای قدرتمند و رم بالا نیاز دارند. در ادامه، این ابزارها را در سه سطح بررسی می‌کنیم.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

  • ابزارهای ساده و آنلاین

ابزارهایی مانند نسخه آنلاین ChatGPT، مترجم‌های مبتنی بر هوش مصنوعی، ابزارهای تولید متن یا تصویر ساده، معمولاً به سخت‌افزار قوی نیاز ندارند. این ابزارها بیشتر بر پایه اینترنت کار می‌کنند و پردازش اصلی روی سرورهای ابری انجام می‌شود.

رم پیشنهادی: ۴ تا ۸ گیگابایت

ویژگی‌ها: قابل استفاده در سیستم‌های معمولی یا لپ‌تاپ‌های دانشجویی

مثال‌ها: ChatGPT، Google Translate با هوش مصنوعی، ابزارهای نوشتن محتوا یا تولید کپشن آنلاین

  • ابزارهای نیمه‌حرفه‌ای

این دسته شامل برنامه‌هایی است که باید روی سیستم نصب شوند و برای پردازش‌های سنگین‌تر طراحی شده‌اند. ابزارهایی مانند نرم‌افزارهای پردازش تصویر یا صدا که از هوش مصنوعی استفاده می‌کنند، به رم بیشتری نیاز دارند.

رم پیشنهادی: ۸ تا ۱۶ گیگابایت

ویژگی‌ها: مناسب برای کاربران حرفه‌ای‌تر، تولیدکنندگان محتوا، طراحان یا پژوهشگران

مثال‌ها: نرم‌افزارهای ویرایش عکس با هوش مصنوعی، برنامه‌های تولید صدا یا حذف نویز با الگوریتم‌های هوشمند

  • ابزارهای پیشرفته و حرفه‌ای

مدل‌های زبانی بزرگ، ابزارهای یادگیری عمیق، برنامه‌هایی که نیاز به آموزش مدل دارند یا خروجی‌هایی با کیفیت بسیار بالا تولید می‌کنند، در این گروه قرار می‌گیرند. اجرای این ابزارها نیازمند سیستم قدرتمند، رم بالا و گاهی کارت گرافیک پیشرفته است.

رم پیشنهادی: ۱۶ تا ۳۲ گیگابایت (یا بیشتر)

ویژگی‌ها: مناسب برای پژوهشگران حوزه هوش مصنوعی، توسعه‌دهندگان مدل‌های یادگیری ماشین، یا کسانی که با مدل‌های مولد بزرگ کار می‌کنند

مثال‌ها: اجرای مدل GPT به‌صورت محلی، Stable Diffusion، آموزش مدل با کتابخانه‌های TensorFlow یا PyTorch

آیا داشتن رم بیشتر همیشه به معنای عملکرد بهتر است؟

در نگاه اول ممکن است تصور شود که هرچه میزان رم بیشتر باشد، عملکرد سیستم نیز بهتر خواهد بود. این موضوع تا حدی درست است، اما همیشه به این سادگی نیست. رم بیشتر، زمانی مفید است که سیستم بتواند از آن استفاده کند. اگر از ابزارهای ساده یا نیمه‌حرفه‌ای استفاده می‌کنید، داشتن رم بیش از حد معمول، لزوماً تاثیری در سرعت یا کیفیت اجرا نخواهد داشت.

D:\digibino\posts\برای اجرای ابزارهای هوش مصنوعی چه مقدار رم نیاز داریم

همچنین باید توجه داشت که رم باید با سایر اجزای سیستم هماهنگ باشد. اگر پردازنده (CPU) یا کارت گرافیک (GPU) ضعیف باشند، رم بیشتر نمی‌تواند به‌تنهایی باعث افزایش چشمگیر سرعت شود. به‌عبارت دیگر، تمام اجزای سیستم باید به‌صورت متعادل ارتقا یابند تا بهترین کارایی را ارائه دهند.

در برخی موارد نیز، سیستم‌عامل یا نرم‌افزارهای مورد استفاده، محدودیتی برای استفاده از رم دارند. برای مثال، برخی نسخه‌های سیستم‌عامل‌های ۳۲ بیتی نمی‌توانند از بیش از ۴ گیگابایت رم استفاده کنند.

در نتیجه، پیش از افزایش رم، بهتر است نیاز واقعی خود و توان سخت‌افزار سیستم را بررسی کنید. گاهی اوقات بهینه‌سازی نرم‌افزاری یا بستن برنامه‌های غیرضروری می‌تواند تأثیر بیشتری نسبت به ارتقای رم داشته باشد.

راه‌کارهایی برای استفاده بهتر و بهینه از رم

حتی اگر سیستم شما رم بالایی ندارد، با رعایت چند نکته ساده می‌توان عملکرد آن را تا حد زیادی بهبود داد. بسیاری از کاربران بدون نیاز به ارتقای سخت‌افزاری، فقط با بهینه‌سازی استفاده از رم، تجربه روان‌تری در کار با ابزارهای هوش مصنوعی خواهند داشت.

  • بستن برنامه‌های اضافی

هر برنامه‌ای که در پس‌زمینه باز است، بخشی از رم را اشغال می‌کند. بهتر است هنگام کار با ابزارهای هوش مصنوعی، سایر برنامه‌های غیرضروری را ببندید تا رم آزاد شود.

  • استفاده از سیستم‌عامل سبک‌تر

سیستم‌عامل‌های سبک‌تر مانند نسخه‌های بهینه‌سازی‌شده ویندوز یا توزیع‌های ساده لینوکس، رم کمتری مصرف می‌کنند و فضای بیشتری برای اجرای ابزارهای هوش مصنوعی باقی می‌گذارند.

  • ارتقای رم در صورت امکان

اگر سیستم شما امکان ارتقای رم دارد، این کار یکی از مؤثرترین روش‌ها برای افزایش سرعت و توانایی در اجرای برنامه‌های سنگین‌تر است.

  • استفاده از حافظه مجازی

در ویندوز و برخی دیگر از سیستم‌عامل‌ها می‌توان با تنظیم حافظه مجازی (یا فایل Swap)، بخشی از حافظه هارد را به‌عنوان رم استفاده کرد. این کار به‌ویژه در زمان‌هایی که رم واقعی پر شده است، کمک می‌کند سیستم از کار نیفتد.

  • استفاده از سرویس‌های ابری یا رایانش ابری

برای اجرای ابزارهای بسیار سنگین، می‌توان از سرورهای ابری مانند Google Colab، Microsoft Azure یا Amazon Web Services استفاده کرد. در این سرویس‌ها، پردازش و مصرف رم روی سرور انجام می‌شود و نیازی به سخت‌افزار قدرتمند در سیستم شخصی نخواهد بود.

جمع‌بندی

ابزارهای هوش مصنوعی برای اجرای درست و روان، به سخت‌افزار مناسب نیاز دارند و رم یکی از مهم‌ترین اجزای آن است. میزان رم مورد نیاز بستگی به نوع ابزاری دارد که از آن استفاده می‌کنید؛ از ابزارهای ساده‌ی آنلاین گرفته تا مدل‌های پیشرفته‌ی یادگیری ماشین.

اگرچه رم بالا می‌تواند به عملکرد بهتر کمک کند، اما تنها عامل تعیین‌کننده نیست. هماهنگی میان رم، پردازنده، و کارت گرافیک، و همچنین استفاده درست از منابع سیستم، تأثیر زیادی در نتیجه نهایی دارد.
پیش از ارتقای رم یا خرید سیستم جدید، بهتر است نیاز خود را بررسی کنید. گاهی با چند تنظیم ساده یا استفاده از خدمات ابری می‌توان بدون هزینه زیاد، از هوش مصنوعی بهره‌برداری کرد.