یادگیری عمیق

یادگیری عمیق چیست؟

امروزه هوش مصنوعی در بخش‌های مختلف زندگی ما حضور دارد؛ از دستیارهای صوتی گرفته تا خودروهای خودران و ترجمه ماشینی. در قلب بسیاری از این فناوری‌ها، مفهومی به نام «یادگیری عمیق» قرار دارد. یادگیری عمیق یا Deep Learning به سیستم‌هایی گفته می‌شود که می‌توانند با استفاده از داده‌های زیاد، الگوهای پیچیده را شناسایی کرده و مانند مغز انسان یاد بگیرند.

این روش از مدل‌هایی استفاده می‌کند که به نام «شبکه‌های عصبی» شناخته می‌شوند و به کامپیوتر های مخصوص هوش مصنوعی کمک می‌کنند تا توانایی‌هایی مثل دیدن، شنیدن، صحبت کردن و تصمیم‌گیری را به‌دست بیاورند. اگر تا امروز شنیده‌اید که یک برنامه می‌تواند تصاویر را تشخیص دهد یا به‌طور طبیعی با شما گفت‌وگو کند، به احتمال زیاد DEEP LEARNING پشت صحنه آن بوده است.

در این مقاله، به زبان ساده توضیح می‌دهیم یادگیری عمیق چیست، چگونه کار می‌کند، چه تفاوتی با سایر روش‌های هوش مصنوعی دارد و چرا آن‌قدر مهم شده است.

یادگیری عمیق چیست؟

یادگیری عمیق، یکی از شاخه‌های “یادگیری ماشین” است که بر پایه شبکه‌های عصبی مصنوعی ساخته شده. این روش تلاش می‌کند نحوه کار مغز انسان را شبیه‌سازی کند؛ یعنی از داده‌ها یاد بگیرد، الگوها را تشخیص دهد و تصمیم بگیرد.

در یادگیری ماشین معمولی، الگوریتم‌ها ممکن است به کمک داده‌های مشخصی آموزش ببینند، اما DEEP LEARNING با استفاده از چندین لایه پردازشی (که به آن‌ها لایه‌های پنهان گفته می‌شود) اطلاعات را مرحله‌به‌مرحله بررسی و تحلیل می‌کند. هرچه این لایه‌ها بیشتر باشند، مدل می‌تواند مفاهیم پیچیده‌تری را درک کند.

به‌طور ساده، DEEP LEARNING مثل یک فیلتر چندمرحله‌ای عمل می‌کند. مثلاً وقتی به یک عکس نگاه می‌کند، در مراحل اول شکل‌ها و خطوط ساده را می‌بیند، در مراحل بعد چهره‌ها یا اشیاء را تشخیص می‌دهد، و در نهایت تصمیم می‌گیرد که تصویر چیست.


یادگیری عمیق

تفاوت یادگیری عمیق با یادگیری ماشین

یادگیری ماشین و یادگیری عمیق هر دو زیرمجموعه هوش مصنوعی هستند، اما تفاوت‌هایی دارند.

 ۱. ساختار مدل‌ها

در یادگیری ماشین، مدل‌ها معمولاً ساده‌تر هستند و با ویژگی‌هایی که انسان تعیین می‌کند آموزش می‌بینند. اما در DEEP LEARNING ، مدل‌ها از شبکه‌های عصبی با چندین لایه ساخته شده‌اند و خودشان ویژگی‌های مهم را از داده‌ها استخراج می‌کنند.

۲. نیاز به داده

مدل‌های MACHINE LEARNING با مقدار کمتری داده هم می‌توانند کار کنند. اما یادگیری عمیق برای عملکرد خوب، به حجم زیادی از داده نیاز دارد.

۳. قدرت پردازشی

یادگیری عمیق به سخت‌افزار قوی‌تری مثل GPU نیاز دارد، چون محاسباتش پیچیده‌تر است. در حالی که مدل‌های یادگیری ماشین سبک‌تر هستند و روی سیستم‌های ساده‌تر هم اجرا می‌شوند.

۴. دقت و عملکرد

مدل‌های یادگیری عمیق معمولاً دقت بیشتری دارند، مخصوصاً در کارهایی مثل تشخیص تصویر، گفتار، یا ترجمه زبان. البته این دقت بیشتر، با هزینه زمان و منابع همراه است.

بطور کلی اگر پروژه‌ شما ساده است و داده زیادی ندارید، یادگیری ماشین کافی است. اما اگر با تصاویر، ویدیو یا زبان طبیعی کار می‌کنید و به دقت بالا نیاز دارید، DEEP LEARNING بهترین گزینه است.

شبکه‌های عصبی مصنوعی چیست؟

شبکه‌های عصبی مصنوعی، الهام‌گرفته از مغز انسان هستند. همان‌طور که مغز از نورون‌ها تشکیل شده، این مدل‌ها هم از “نورون‌های مصنوعی” ساخته می‌شوند. این نورون‌ها به‌صورت لایه‌لایه در کنار هم قرار می‌گیرند و اطلاعات را پردازش می‌کنند.

یادگیری عمیق

هر شبکه عصبی سه بخش اصلی دارد:

  • لایه ورودی:

داده‌ها از اینجا وارد شبکه می‌شوند. مثلاً عکس، متن یا صدا.

  • لایه‌های پنهان:

این لایه‌ها اطلاعات را تجزیه و تحلیل می‌کنند. تعداد و عمق این لایه‌ها، قدرت یادگیری مدل را تعیین می‌کند. هرچه لایه‌های بیشتری داشته باشد، شبکه “عمیق‌تر” می‌شود.

  • لایه خروجی:

نتیجه نهایی از این لایه بیرون می‌آید. مثلاً تشخیص اینکه در عکس، گربه هست یا نه.

هر نورون در این لایه‌ها یک مقدار عددی را دریافت، پردازش و به نورون‌های بعدی منتقل می‌کند. این انتقال بر اساس وزن‌ها و توابع ریاضی انجام می‌شود که مدل در طول آموزش یاد می‌گیرد.

شبکه‌های عصبی پایه DEEP LEARNING هستند. آن‌ها به مدل اجازه می‌دهند بدون دخالت انسان، الگوهای پیچیده را از داده‌ها استخراج کند.

چرا به آن یادگیری “عمیق” می‌گویند؟

دلیل اینکه به این روش “یادگیری عمیق” گفته می‌شود، به تعداد زیاد لایه‌های پنهان در شبکه‌های عصبی مربوط می‌شود. در گذشته، شبکه‌های عصبی ساده فقط یک یا دو لایه پنهان داشتند. اما در DEEP LEARNING، این لایه‌ها ممکن است ده‌ها یا حتی صدها لایه داشته باشند.

هر لایه اطلاعات را به‌صورت مرحله‌ای پردازش می‌کند. مثلاً در یک مدل تشخیص تصویر:

  • لایه اول لبه‌ها و خطوط را تشخیص می‌دهد.
  • لایه دوم شکل‌های ساده را از روی آن‌ها می‌سازد.
  • لایه‌های بعدی جزئیات بیشتری مثل چشم یا دهان را تشخیص می‌دهند.
  • لایه آخر تصمیم می‌گیرد که تصویر مربوط به انسان است یا حیوان.

این فرایند مرحله‌به‌مرحله باعث می‌شود مدل بتواند مفاهیم پیچیده را یاد بگیرد، درست مثل مغز انسان. هرچه تعداد این مراحل (یا لایه‌ها) بیشتر باشد، “عمق” مدل بیشتر است، و بنابراین به آن یادگیری عمیق می‌گویند.

کاربردهای یادگیری عمیق در دنیای واقعی

یادگیری عمیق در سال‌های اخیر به سرعت رشد کرده و وارد بخش‌های مختلف زندگی ما شده. در ادامه چند نمونه از کاربردهای مهم آن را ببینیم:
یادگیری عمیق

۱. تشخیص تصویر و چهره

مدل‌های یادگیری عمیق در پشت‌صحنه سیستم‌هایی مثل تشخیص چهره در موبایل، دوربین‌های امنیتی، یا حتی فیلترهای چهره در شبکه‌های اجتماعی قرار دارند.

۲. ترجمه خودکار زبان

سرویس‌هایی مثل Google Translate یا ترجمه همزمان در چت‌بات‌ها از DEEP LEARNING برای درک زبان و ترجمه دقیق‌تر استفاده می‌کنند.

۳. خودروهای خودران

ماشین‌هایی مثل تسلا از شبکه‌های عصبی عمیق برای تشخیص علائم رانندگی، خودروهای دیگر، عابران پیاده و تصمیم‌گیری در لحظه استفاده می‌کنند.

۴. پزشکی و تشخیص بیماری

مدل‌های یادگیری عمیق می‌توانند عکس‌های پزشکی (مثل MRI یا X-ray) را بررسی کرده و بیماری‌ها را با دقت بالا تشخیص دهند.

۵. دستیارهای صوتی و چت‌بات‌ها

الکسا، سیری و حتی چت‌جی‌پی‌تی از یادگیری عمیق برای درک زبان طبیعی، تولید پاسخ و یادگیری از مکالمات استفاده می‌کنند.

۶. ساخت تصویر، صدا و ویدیو

مدل‌های مولد مثل DALL·E، Midjourney یا Sora با کمک DEEP LEARNING می‌توانند از متن، تصاویر یا ویدیوهای جدید بسازند.

مزایا و محدودیت‌های DEEP LEARNING

در ادامه برخی مزایا و محدودیت های مدل های یادگیری عمیق را با هم بررسی می کنیم.

مزایا:

در ابتدا مزایا و محاسن این مدل را نام میبریم.

  • دقت بالا:

مدل‌های یادگیری عمیق در کارهایی مثل تشخیص تصویر، درک زبان و ترجمه عملکرد بسیار دقیقی دارند. آن‌ها می‌توانند الگوهای پیچیده‌ای را پیدا کنند که مدل‌های سنتی قادر به تشخیص آن‌ها نیستند.

  • یادگیری خودکار ویژگی‌ها:

برخلاف مدل‌های یادگیری ماشین که نیاز به تعیین ویژگی توسط انسان دارند، یادگیری عمیق خودش ویژگی‌های مهم را از داده‌ها استخراج می‌کند.

  • مقیاس‌پذیری بالا:

یادگیری عمیق می‌تواند با افزایش داده و قدرت سخت‌افزاری، بهبود یابد و پروژه‌های بسیار بزرگ را مدیریت کند.

  • سازگاری با انواع داده:

از تصاویر و صدا گرفته تا متن و ویدیو، مدل‌های یادگیری عمیق با انواع داده کار می‌کنند و نتایج قابل‌اعتمادی ارائه می‌دهند.

محدودیت‌ها:

برخی از محدودیت های الگوریتم های DEEP LEARNING شامل موارد زیر می باشد.

  • نیاز به داده زیاد:

برای آموزش درست، مدل‌های DEEP LEARNING به حجم زیادی از داده نیاز دارند. در پروژه‌هایی با داده کم، عملکرد آن‌ها ضعیف‌تر است.

  • نیاز به سخت‌افزار قوی:

این مدل‌ها برای اجرا و آموزش، به GPUهای قدرتمند و منابع پردازشی بالا نیاز دارند.

  • زمان آموزش بالا:

آموزش شبکه‌های عمیق ممکن است ساعت‌ها یا حتی روزها طول بکشد، به‌خصوص روی داده‌های بزرگ.

  • عدم شفافیت (جعبه سیاه بودن):

فهمیدن اینکه دقیقاً مدل چگونه به یک نتیجه رسیده، سخت است. این موضوع در موارد حساس مثل پزشکی یا امنیت می‌تواند مشکل‌ساز باشد.

نتیجه‌گیری

یادگیری عمیق یکی از مهم‌ترین شاخه‌های هوش مصنوعی مدرن است که نقش بزرگی در پیشرفت‌های فناوری ایفا کرده. از تشخیص چهره گرفته تا خودروهای خودران و دستیارهای هوشمند، همه‌جا ردپای DEEP LEARNING دیده می‌شود.

در این مقاله دیدیم که یادگیری عمیق چگونه با استفاده از شبکه‌های عصبی و لایه‌های متعدد، می‌تواند داده‌ها را تحلیل کند و تصمیم‌های هوشمند بگیرد. همچنین به مزایا و محدودیت‌های این روش پرداختیم تا دید بهتری نسبت به کاربردها و چالش‌های آن داشته باشیم.

با گسترش داده‌ها، افزایش توان پردازنده‌ها و توسعه الگوریتم‌ها، یادگیری عمیق روزبه‌روز قوی‌تر می‌شود. آینده‌ی هوش مصنوعی، بدون شک به شدت وابسته به همین مدل‌های “عمیق” خواهد بود. در صورتی که شما هم در زمینه الگوریتم های هوش مصنوعی و یادگیری عمیق فعالیت می کنید قطعا به سیستم هایی نیاز خواهید داشت که از پس اجرای این الگوریتم ها بر بیاد. دیجی بینو با سالها تجربه در زمینه اسمبل سیستم های رندرینگ و شبیه سازی میتونه در این زمینه بهترین سیستم های مخصوص کارهای گرافیکی سنگین و هوش مصنوعی رو به شما پیشنهاد و اسمبل کنه
سرورهای CHATGPT

سرورهای CHATGPT از چه سخت افزاری استفاده میکند؟

چت جی‌پی‌تی (ChatGPT) یکی از معروف‌ترین ابزارهای مبتنی بر هوش مصنوعی در دنیاست. این مدل توسط شرکت OpenAI توسعه داده شده و می‌تواند به سؤالات پاسخ دهد، متن تولید کند، ترجمه انجام دهد و حتی در موضوعات فنی یا خلاقانه کمک کند. اما پشت این عملکرد چشمگیر، تنها یک نرم‌افزار ساده نیست.

برای اجرای چنین مدلی، نیاز به زیرساخت سخت‌افزاری بسیار قدرتمندی وجود دارد. پردازش میلیون‌ها داده در زمان واقعی، آموزش مدل‌های زبانی بسیار بزرگ و پاسخ‌گویی سریع به کاربران، همگی به کمک سخت‌افزارهای پیشرفته امکان‌پذیر شده‌اند.

در این مقاله بررسی می‌کنیم که سرورهای ChatGPT از چه سخت‌افزاری استفاده می‌کنند و چرا این سخت‌افزارها نقش مهمی در قدرت و دقت این مدل دارند.

چرا سخت‌افزار در مدل‌های هوش مصنوعی مهم است؟

مدل‌های هوش مصنوعی، به‌ویژه مدل‌های زبانی مانند ChatGPT، برای کار کردن به سخت‌افزارهای بسیار قدرتمند نیاز دارند. برخلاف برنامه‌های معمولی که روی یک لپ‌تاپ یا گوشی هم اجرا می‌شوند، این مدل‌ها باید حجم زیادی از داده‌ها را به‌سرعت تحلیل و پردازش کنند.

هر پاسخ کوتاهی که ChatGPT می‌دهد، نتیجه هزاران محاسبه ریاضی و تحلیل زبانی پیچیده در پشت صحنه است. این محاسبات به توان پردازشی بسیار بالا نیاز دارند. به همین دلیل، استفاده از سخت‌افزار قوی مانند پردازنده‌های گرافیکی پیشرفته (GPU) ضروری است.


سخت‌افزار قوی باعث می‌شود:

  • مدل سریع‌تر پاسخ دهد.
  • دقت پاسخ‌ها بیشتر شود.
  • هم‌زمان هزاران کاربر بتوانند از مدل استفاده کنند.
  • مصرف انرژی بهینه‌تر باشد.

در واقع، بدون سخت‌افزار مناسب، حتی بهترین الگوریتم‌های هوش مصنوعی هم نمی‌توانند عملکرد خوبی داشته باشند. پس برای اجرای درست و سریع مدل‌هایی مانند ChatGPT، سخت‌افزار یکی از اصلی‌ترین بخش‌هاست. سیستم های هوش مصنوعی از سخت افزار های مختلفی بهره می گیرند اما مهمترین قطعه در این بین پردازنده های گرافیکی می باشند که سریعترین عملکرد را برای اجرای الگوریتم های هوش مصنوعی و یادگیری ماشین دارند.


سرورهای CHATGPT

پردازنده‌های گرافیکی (GPU): قلب سرورهای هوش مصنوعی

وقتی صحبت از اجرای مدل‌های بزرگ هوش مصنوعی مثل ChatGPT می‌شود، پردازنده‌های گرافیکی یا همان GPU نقش اصلی را دارند. این قطعات، برخلاف پردازنده‌های معمولی (CPU)، می‌توانند هزاران عملیات محاسباتی را به‌صورت هم‌زمان انجام دهند. این توانایی باعث شده تا GPUها بهترین انتخاب برای آموزش و اجرای مدل‌های “یادگیری عمیق” باشند.

چرا از GPU استفاده می‌شود؟

مدل‌های هوش مصنوعی به‌ویژه مدل‌های زبانی، شامل میلیاردها پارامتر هستند. برای آموزش این مدل‌ها و پاسخ‌گویی سریع به کاربر، نیاز به پردازش موازی بسیار زیاد داریم. GPUها دقیقاً همین کار را انجام می‌دهند:

  • اجرای هم‌زمان هزاران محاسبه.
  • افزایش سرعت آموزش مدل‌ها.
  • اجرای سریع‌تر هنگام پاسخ‌گویی.
  • پشتیبانی از کتابخانه‌ها و فریم‌ورک‌های تخصصی هوش مصنوعی مانند TensorFlow و PyTorch

در واقع، بدون GPU، اجرای مدل‌هایی مثل GPT-4 عملاً غیرممکن یا بسیار کند و پرهزینه می‌شود.

شرکت‌های سازنده GPU برای هوش مصنوعی

NVIDIA پیشروترین شرکت در زمینه ساخت GPU برای هوش مصنوعی است. محصولات این شرکت مثل سری A100، H100 و RTX، در دیتاسنترها و پروژه‌های بزرگ استفاده می‌شوند.

AMD نیز در سال‌های اخیر وارد رقابت شده و با تولید کارت‌هایی مانند MI100، جایگاهی در بازار پیدا کرده است. اما همچنان پشتیبانی نرم‌افزاری برای AMD به اندازه NVIDIA گسترده نیست.

در حال حاضر، بیشتر زیرساخت‌های هوش مصنوعی پیشرفته مانند ChatGPT از کارت‌های گرافیکی ساخت NVIDIA استفاده می‌کنند.


ChatGPT از چه GPUهایی استفاده می‌کند؟

مدل‌های بزرگ زبان مانند ChatGPT برای اجرا به سخت‌افزاری در سطح دیتاسنتر نیاز دارند، نه یک کارت گرافیک ساده‌ی دسکتاپی. بر اساس اطلاعات منتشرشده از سوی OpenAI و مایکروسافت، زیرساخت مورد استفاده برای سرورهای CHATGPT، مجموعه‌ای از قوی‌ترین پردازنده‌های گرافیکی مخصوص هوش مصنوعی دنیاست: NVIDIA A100 و NVIDIA H100.

سرورهای CHATGPT

NVIDIA A100

کارت گرافیکی A100 یکی از پرکاربردترین GPUها در زمینه‌ی هوش مصنوعی است. این کارت بر پایه معماری Ampere ساخته شده و ویژگی‌هایی مثل پردازش موازی گسترده، حافظه زیاد و پشتیبانی از عملیات یادگیری عمیق را دارد. A100 در آموزش مدل‌های زبانی بزرگ، عملکرد فوق‌العاده‌ای دارد.


  • حافظه بالا (تا ۸۰ گیگابایت)
  • پشتیبانی از Tensor Core برای محاسبات سریع‌تر
  • استفاده گسترده در مراکز داده و پروژه‌های AI

NVIDIA H100

انویدیا H100 نسل جدیدتر A100 است و بر پایه معماری Hopper طراحی شده. این GPU نه تنها قدرتمندتر است، بلکه از فناوری‌های پیشرفته‌تری برای یادگیری ماشین پشتیبانی می‌کند. بسیاری از زیرساخت‌های جدید ChatGPT (مخصوصاً GPT-4 و نسخه‌های پیشرفته‌تر) با H100 اجرا می‌شوند.

  • قدرت محاسباتی بیشتر نسبت به A100
  • مصرف انرژی بهینه‌تر
  • سرعت بالاتر در آموزش و پاسخ‌گویی


چرا از این کارت‌ها استفاده می‌شود؟

چون ChatGPT یک مدل بسیار بزرگ است، به هزاران GPU نیاز دارد که به‌صورت شبکه‌ای در کنار هم کار کنند. کارت‌های A100 و H100 این امکان را فراهم می‌کنند که مدل با سرعت بالا و پایداری مناسب اجرا شود و هم‌زمان به میلیون‌ها کاربر پاسخ دهد.


مشخصات فنی سرورهای ChatGPT

برای اجرای مدل‌های سنگینی مثل GPT-4، فقط داشتن یک کارت گرافیک قدرتمند کافی نیست. این مدل‌ها روی هزاران GPU اجرا می‌شوند که در سرورهای بسیار پیشرفته قرار گرفته‌اند. هر کدام از این سرورها باید توان پردازشی، حافظه، شبکه و سیستم خنک‌کننده بسیار بالایی داشته باشند. در ادامه، نگاهی می‌اندازیم به برخی ویژگی‌های فنی این سرورها.

سرورهای CHATGPT

قدرت پردازشی بالا

سرورهایی که برای ChatGPT استفاده می‌شوند، معمولاً چندین GPU مثل NVIDIA A100 یا H100 دارند که به‌صورت موازی کار می‌کنند. این یعنی ده‌ها تریلیون عملیات در ثانیه انجام می‌شود. این سطح از قدرت برای آموزش و اجرای مدل‌های بسیار بزرگ ضروری است.


حافظه زیاد

هر GPU معمولاً بین ۴۰ تا ۸۰ گیگابایت حافظه پرسرعت (VRAM) دارد. در کنار آن، هر سرور دارای حافظه رم بسیار بالاست (گاهی تا چند ترابایت)، تا بتواند داده‌های حجیم را بدون تأخیر پردازش کند.


مصرف انرژی بالا

هر GPU مصرفی در حد ۳۰۰ تا ۷۰۰ وات دارد. وقتی چندین GPU در یک سرور نصب می‌شوند، مصرف کل ممکن است به چند کیلووات برسد. بنابراین دیتاسنترهایی مثل Azure باید زیرساخت برقی بسیار قدرتمندی داشته باشند.


سیستم‌های خنک‌کننده

چنین سطحی از مصرف انرژی، گرمای زیادی تولید می‌کند. به همین دلیل، این سرورها نیاز به خنک‌کننده‌های صنعتی، سیستم تهویه‌ی مداوم، و حتی گاهی خنک‌سازی با مایع دارند تا دما همیشه در حد مناسب باقی بماند.


شبکه پرسرعت

برای اتصال هزاران GPU به یکدیگر، باید شبکه‌ای بسیار سریع با تأخیر کم وجود داشته باشد. معمولاً از شبکه‌های NVLink یا InfiniBand استفاده می‌شود تا تبادل داده بین GPUها سریع و بی‌وقفه انجام شود.


نقش Microsoft Azure در میزبانی ChatGPT

ChatGPT روی کامپیوترهای شخصی اجرا نمی‌شود، بلکه به زیرساختی بسیار بزرگ و قدرتمند نیاز دارد. شرکت OpenAI برای اجرای سرورهای CHATGPT، از خدمات ابری Microsoft Azure استفاده می‌کند. Azure یکی از بزرگ‌ترین پلتفرم‌های رایانش ابری در دنیاست و امکانات مورد نیاز برای اجرای مدل‌های سنگین هوش مصنوعی را فراهم می‌کند.

سرورهای CHATGPT

همکاری OpenAI و مایکروسافت

مایکروسافت یکی از بزرگ‌ترین سرمایه‌گذاران در OpenAI است و چندین میلیارد دلار در این شرکت سرمایه‌گذاری کرده است. این همکاری باعث شده که OpenAI بتواند از قدرت زیرساخت ابری Azure برای آموزش و اجرای مدل‌های GPT استفاده کند.


دیتاسنترهای مجهز

Azure دیتاسنترهای بسیار بزرگ و پیشرفته‌ای در سراسر جهان دارد. این مراکز از هزاران سرور مجهز به GPUهای A100 و H100 استفاده می‌کنند. این یعنی ChatGPT می‌تواند هم‌زمان به میلیون‌ها درخواست پاسخ دهد، بدون اینکه سرعت یا کیفیت پاسخ‌ها کاهش پیدا کند.


امنیت و پایداری

یکی از دلایل اصلی استفاده از Azure در سرورهای CHATGPT، امنیت بالا و قابلیت اطمینان آن است. داده‌ها در شرایط کنترل‌شده و امن ذخیره و پردازش می‌شوند. همچنین، Azure امکان مقیاس‌پذیری دارد، یعنی با افزایش کاربران، می‌توان سرورها را به‌سرعت افزایش داد تا عملکرد مدل حفظ شود.


اتصال بین GPUها

مایکروسافت با استفاده از فناوری‌های خاص مثل InfiniBand، ارتباط بین GPUها را سریع و بدون تأخیر نگه می‌دارد. این ویژگی باعث می‌شود که مدل‌های پیچیده مثل GPT-4 بتوانند در مقیاس بزرگ و با سرعت بالا اجرا شوند.

سرورهای CHATGPT

چند GPU برای اجرای ChatGPT استفاده می‌شود؟

مدل‌های زبانی بزرگ مثل GPT-4، ساختاری بسیار پیچیده دارند. این مدل‌ها شامل صدها میلیارد پارامتر هستند و برای اجرای آن‌ها فقط یک یا دو GPU کافی نیست. اجرای ChatGPT نیازمند هزاران GPU است که با هم و به‌صورت هماهنگ در سرورهای CHATGPT کار می‌کنند.

آموزش مدل:

نیاز به هزاران GPU

در مرحله‌ی آموزش، مدل باید میلیاردها داده را بررسی کرده و یاد بگیرد. برای این کار، به بیش از ۱۰ هزار GPU نیاز است. این GPUها به‌صورت خوشه‌ای (cluster) در کنار هم قرار گرفته‌اند و با سرعت بالا داده‌ها را بین هم رد و بدل می‌کنند.

مثلاً آموزش نسخه‌های بزرگ GPT ممکن است هفته‌ها طول بکشد، حتی با استفاده از هزاران GPU. در این مرحله، سرعت و هماهنگی بین GPUها بسیار حیاتی است.

اجرای مدل:

مقیاس بالا برای پاسخ‌گویی به کاربران

پس از آموزش، مدل آماده استفاده است. اما برای اینکه میلیون‌ها کاربر به‌صورت هم‌زمان بتوانند از سرورهای CHATGPT استفاده کنند، نیاز به تعداد زیادی GPU در مرحله اجرا (Inference) هم وجود دارد. این GPUها مدل را در حافظه نگه می‌دارند و درخواست‌های کاربران را با سرعت پردازش می‌کنند.

OpenAI از سیستم‌های مقیاس‌پذیر استفاده می‌کند تا بتواند با افزایش تعداد کاربران، GPUهای بیشتری به مدل اختصاص دهد. این موضوع باعث می‌شود ChatGPT همیشه در دسترس و سریع باقی بماند.

نتیجه‌گیری

اجرای مدل‌های هوش مصنوعی پیشرفته مثل ChatGPT، فقط به الگوریتم‌های پیچیده وابسته نیست. بخش مهمی از موفقیت این مدل‌ها به زیرساخت سخت‌افزاری قدرتمند آن‌ها برمی‌گردد. در قلب این زیرساخت، هزاران پردازنده گرافیکی (GPU) قرار دارند که با توان پردازشی بالا، امکان آموزش و اجرای سریع مدل‌ها را فراهم می‌کنند.

استفاده از GPUهایی مانند NVIDIA A100 یا H100 در سرورهای CHATGPT باعث می‌شود که مدل‌هایی با میلیاردها پارامتر بتوانند در زمان کوتاه آموزش ببینند و به میلیون‌ها کاربر پاسخ دهند. شرکت OpenAI نیز برای مدیریت این حجم عظیم از پردازش، از دیتاسنترهای ابری Microsoft Azure استفاده می‌کند. این زیرساخت امن و مقیاس‌پذیر، امکان اجرای پایدار و هم‌زمان ChatGPT را برای کاربران سراسر دنیا فراهم کرده است.

در نهایت، هوش مصنوعی بدون سخت‌افزار قوی نمی‌تواند عملکردی قابل قبول داشته باشد. پردازنده‌های گرافیکی، شبکه‌های پرسرعت، حافظه زیاد و سیستم خنک‌کننده حرفه‌ای، همگی نقش حیاتی در زنده نگه‌داشتن مدلی مثل ChatGPT دارند. این موضوع نشان می‌دهد که موفقیت در دنیای هوش مصنوعی، ترکیبی از علم داده و قدرت سخت‌افزار است.

پردازنده‌های گرافیکی مناسب برای هوش مصنوعی

معرفی پردازنده‌های گرافیکی مناسب برای هوش مصنوعی

در سال‌های اخیر، سیستم های هوش مصنوعی رشد زیادی کرده و در بخش‌های مختلفی مثل خودروهای خودران، ترجمه زبان، تشخیص چهره و حتی گفت‌وگو با ربات‌ها استفاده می‌شود. برای انجام این کارها، سیستم‌ها نیاز دارند حجم زیادی از اطلاعات را خیلی سریع پردازش کنند. اینجاست که پردازنده‌های گرافیکی یا GPU وارد می‌شوند.

برخلاف پردازنده‌های معمولی (CPU) که برای کارهای عمومی طراحی شده‌اند، GPUها می‌توانند همزمان هزاران کار کوچک را انجام دهند و همین ویژگی آن‌ها را برای آموزش مدل‌های هوش مصنوعی بسیار مناسب کرده است. در این مقاله قصد داریم با GPUهای مناسب برای کارهای هوش مصنوعی آشنا شویم، ویژگی‌های مهم آن‌ها را بررسی کنیم و چند مدل قوی و پرکاربرد را معرفی کنیم.

نقش GPU در هوش مصنوعی

پردازنده گرافیکی یا GPU، یکی از مهم‌ترین بخش‌های سخت‌افزار در هوش مصنوعی است. دلیلش ساده است: GPU می‌تواند تعداد زیادی داده را همزمان پردازش کند. این ویژگی باعث می‌شود مدل‌های هوش مصنوعی خیلی سریع‌تر آموزش ببینند.

در مقایسه با CPU، که فقط چند هسته دارد و کارها را پشت‌سر‌هم انجام می‌دهد، GPU هزاران هسته کوچک دارد. این هسته‌ها به صورت موازی کار می‌کنند. یعنی چند کار را با هم انجام می‌دهند. این موضوع برای آموزش شبکه‌های عصبی، که نیاز به محاسبات زیاد دارند، بسیار مفید است.


GPU در مراحل مختلف هوش مصنوعی استفاده می‌شود

آموزش مدل‌ها: وقتی یک مدل باید از داده‌ها یاد بگیرد.

استفاده از مدل: وقتی مدل آموزش‌دیده روی داده‌های جدید اجرا می‌شود.

پس اگر سرعت، دقت و عملکرد بهتر را در پروژه‌های هوش مصنوعی می‌خواهید، استفاده از GPU ضروری است.


معیارهای انتخاب GPU برای هوش مصنوعی

انتخاب پردازنده گرافیکی مناسب برای هوش مصنوعی، به چند عامل مهم بستگی دارد. این عوامل به شما کمک می‌کنند بهترین GPU را متناسب با نیاز و بودجه‌تان پیدا کنید.

پردازنده‌های گرافیکی مناسب برای هوش مصنوعی

۱. تعداد هسته‌ها (CUDA Cores / Tensor Cores)

هسته‌های GPU مانند مغز آن هستند. پردازنده گرافیکی هرچه هسته‌های بیشتری داشته باشد، می‌تواند کارهای بیشتری را به طور همزمان انجام دهد.

CUDA cores:

در GPUهای انویدیا، مسئول پردازش موازی هستند. در واقع هسته های کودا هسته های لوجیکالی می باشند که برای انجام انواع پردازش های موازی سنگین گرافیکی از آنها استفاده می شود. تمامی پردازنده های گرافیکی جدید انویدیا شامل تعداد زیادی هسته کودا می شوند. یکی از المان های مهم برای پردازنده‌های گرافیکی برای هوش مصنوعی وجود هسته های لوجیکال زیاد مانند cuda cores می باشد.

Tensor cores:

tpu یا واحد پردازشی تنسور برای پردازش‌های یادگیری عمیق بهینه شده‌اند و سرعت محاسبات را بسیار افزایش می‌دهند. این واحد های پردازشی بر روی پردازنده های tpu که توسط شرکت گوگل تولید و گسترش داده شده اند قرار دارند و این شرکت برای مصارف مختلفی مانند هوش مصنوعی و پردازش الگوریتم های یادگیری ماشین از این پردازنده ها بهره می برد. از این هسته های لوجیکال در پردازنده‌های گرافیکی برای هوش مصنوعی نیز استفاده می شود.


۲. حجم و نوع حافظه (VRAM)

حافظه ویدئویی (VRAM) مسئول ذخیره داده‌ها و مدل‌ها است.برای مدل‌های بزرگ و داده‌های پیچیده، حافظه بیشتر لازم است.

حداقل ۸ گیگابایت VRAM برای پروژه‌های معمولی هوش مصنوعی مناسب است، اما مدل‌های سنگین‌تر به ۱۶ یا حتی ۲۴ گیگابایت نیاز دارند.


۳. پشتیبانی از نرم‌افزار و کتابخانه‌ها

GPU باید با نرم‌افزارهای هوش مصنوعی سازگار باشد. انویدیا با CUDA، cuDNN و TensorRT محبوب‌ترین گزینه‌ها هستند.AMD هم در حال پیشرفت است اما هنوز پشتیبانی گسترده‌ای ندارد.


۴. مصرف انرژی و سیستم خنک‌کننده

مصرف برق بالا یعنی نیاز به منبع تغذیه قوی‌تر و خنک‌کننده بهتر. این موضوع به خصوص در سیستم‌های بزرگ اهمیت دارد.


۵. قیمت و بودجه

قیمت GPUها بسیار متفاوت است. مدل‌های حرفه‌ای ممکن است قیمت‌های چند هزار دلاری داشته باشند. مدل‌های مناسب برای کارهای متوسط قیمت مناسب‌تری دارند. با این معیارها می‌توان بهترین GPU را متناسب با پروژه هوش مصنوعی انتخاب کرد.

معرفی پردازنده‌های گرافیکی برتر برای هوش مصنوعی

پردازنده‌های گرافیکی یا GPUها، نقش بسیار مهمی در انجام پروژه‌های هوش مصنوعی دارند. اما انواع مختلفی از این پردازنده‌ها وجود دارد که هرکدام برای نوع خاصی از کارها مناسب هستند. در اینجا چند نمونه از بهترین GPUها را برای هوش مصنوعی معرفی می‌کنیم.

پردازنده‌های گرافیکی مناسب برای هوش مصنوعی


  • پردازنده‌های قوی و حرفه‌ای برای پروژه‌های بزرگ

از این پردازنده‌های گرافیکی برای هوش مصنوعی در سرور ها و دیتاسنتر های عظیم مخصوص تحلیل داده های هوش مصنوعی و یادگیری ماشین استفاده می شود.


پردازنده گرافیکی هوش مصنوعی NVIDIA A100:

کارت گرافیک nvidia a100 یکی از قوی‌ترین پردازنده‌های گرافیکی برای هوش مصنوعی است که برای کارهای بسیار سنگین هوش مصنوعی طراحی شده است. برای شرکت‌ها و مراکز تحقیقاتی بزرگ که می‌خواهند مدل‌های پیچیده و بزرگی آموزش دهند، بسیار مناسب است.


پردازنده گرافیکی هوش مصنوعیNVIDIA H100:

نسل جدیدتر و قوی‌تر از A100 است که سرعت بیشتری دارد و امکانات بیشتری برای هوش مصنوعی فراهم می‌کند. این کارت بیشتر برای پروژه‌های بسیار بزرگ و دیتاسنترها استفاده می‌شود.


پردازنده گرافیکی هوش مصنوعی NVIDIA RTX 6000 Ada Generation:

این کارت گرافیک قدرت بالایی دارد و برای کسانی که به دنبال ترکیبی از قدرت و قابلیت استفاده در مقیاس متوسط هستند، مناسب است.


  • پردازنده‌های مناسب برای کاربران حرفه‌ای و توسعه‌دهندگان شخصی

از این پردازنده‌های گرافیکی برای هوش مصنوعی میتوان در پروژه های کوچکتر و یا مصارف خانگی و روزمره هوش مصنوعی بهره برد.


کارت گرافیک های NVIDIA RTX 4090 و RTX 4080:

این کارت‌ها برای محققان و توسعه‌دهندگانی که پروژه‌های هوش مصنوعی را روی کامپیوترهای شخصی انجام می‌دهند بسیار مناسب‌اند. قدرت پردازش بالا و حافظه کافی این کارت‌ها باعث می‌شود مدل‌ها سریع‌تر آموزش ببینند.


کارت گرافیک های NVIDIA RTX 3090 و RTX 3080:

نسل قبلی این کارت‌ها هنوز هم قدرتمند هستند و گزینه‌ای اقتصادی‌تر نسبت به مدل‌های جدیدتر محسوب می‌شوند. مناسب برای پروژه‌های متوسط و حتی پیشرفته.


پردازنده گرافیکی AMD Radeon Instinct MI100:

این کارت گرافیک از شرکت AMD است و برای پروژه‌های خاص هوش مصنوعی استفاده می‌شود. هرچند بازار بیشتر به سمت کارت‌های NVIDIA است، اما AMD هم در حال رشد است.

مقایسه کلی پردازنده‌های گرافیکی مناسب برای هوش مصنوعی

حالا که با چند مدل معروف پردازنده‌های گرافیکی برای هوش مصنوعی آشنا شدیم، بهتر است آن‌ها را با هم مقایسه کنیم و ببینیم کدام‌یک برای چه کسی مناسب است.

پردازنده‌های گرافیکی مناسب برای هوش مصنوعی


اگر در حال اجرای پروژه‌ای بزرگ هستید، مثلاً یک مدل یادگیری عمیق با داده‌های بسیار زیاد، به کارت‌هایی مثل NVIDIA A100 یا H100 نیاز دارید. این کارت‌ها مخصوص مراکز داده، شرکت‌های بزرگ، و پروژه‌های صنعتی هستند. قیمتشان بالا است ولی در عوض، سرعت و قدرت بی‌نظیری دارند.

اگر شما یک توسعه‌دهنده حرفه‌ای هستید که روی پروژه‌های متوسط یا حتی سنگین کار می‌کنید، اما نمی‌خواهید هزینه بسیار زیادی پرداخت کنید، RTX 4090 یا 4080 گزینه‌های بسیار خوبی هستند. این کارت‌ها سرعت بالایی دارند، حافظه کافی دارند و بیشتر نیازهای هوش مصنوعی را روی سیستم‌های شخصی برطرف می‌کنند.

برای افرادی که بودجه محدودتری دارند یا پروژه‌های کوچک‌تری انجام می‌دهند، RTX 3090 یا 3080 انتخاب‌های مناسبی هستند. این کارت‌ها هنوز هم بسیار قدرتمند هستند و بسیاری از مدل‌های یادگیری ماشین و یادگیری عمیق را به‌خوبی اجرا می‌کنند.

اگر به دلایلی نمی‌خواهید از محصولات انویدیا استفاده کنید، برخی از کارت‌های AMD مثل MI100 هم می‌توانند مفید باشند. البته هنوز بیشتر نرم‌افزارهای هوش مصنوعی با کارت‌های NVIDIA سازگارتر هستند.

در نهایت، انتخاب GPU باید بر اساس این سه عامل باشد:

اندازه و پیچیدگی پروژه

بودجه‌ای که در اختیار دارید

میزان دانش فنی و منابع نرم‌افزاری

نتیجه‌گیری

در دنیای امروز که هوش مصنوعی به سرعت در حال رشد است، انتخاب درست پردازنده‌های گرافیکی برای هوش مصنوعی می‌تواند تفاوت بزرگی در عملکرد و سرعت پروژه‌ها ایجاد کند. GPUها با قدرت پردازش موازی بالا، نقش کلیدی در آموزش و اجرای مدل‌های یادگیری ماشین و یادگیری عمیق دارند.

در این مقاله با معیارهای مهم انتخاب GPU آشنا شدیم، مدل‌های مختلف را بررسی کردیم و پیشنهادهایی برای کاربران مبتدی تا حرفه‌ای ارائه دادیم. اگر پروژه‌ای سبک دارید، کارت‌هایی مانند RTX 3080 یا 3090 کافی هستند. اما اگر به دنبال آموزش مدل‌های پیچیده‌تر یا اجرای پروژه‌های سنگین هستید، مدل‌هایی مثل RTX 4090، A100 یا H100 انتخاب‌های بهتری هستند.

در نهایت، بهترین GPU برای هوش مصنوعی همان مدلی است که با نیاز پروژه، بودجه شما و سطح دانش فنی‌تان هماهنگ باشد. با یک انتخاب هوشمندانه، می‌توانید نتایج بهتر، سریع‌تر و با دقت بیشتر به‌دست بیاورید.

tpu

TPU چیست؟

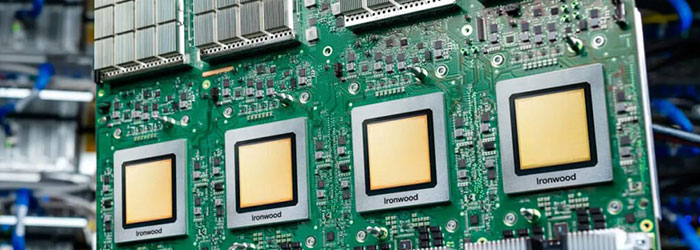
TPU یا واحد پردازش تنسور، یک تراشه‌ی پردازشی است که توسط شرکت گوگل طراحی شده است. این تراشه به‌طور خاص برای انجام محاسبات مربوط به یادگیری ماشین و شبکه‌های عصبی مصنوعی طراحی شده است. برخلاف پردازنده‌های عمومی مانند CPU (واحد پردازش مرکزی) یا GPU (واحد پردازش گرافیکی)، TPU برای اجرای عملیات سنگین ریاضی و الگوریتم‌های خاص یادگیری عمیق بهینه‌سازی شده است.


این تراشه به‌گونه‌ای ساخته شده که بتواند در مقیاس‌های بزرگ و با سرعت بالا داده‌ها را تحلیل و پردازش کند.

یکی از مفاهیم کلیدی در عملکرد این تراشه، «تنسور» است. تنسور در واقع آرایه‌ای چندبعدی از داده‌هاست که ساختار اصلی ورودی و خروجی در مدل‌های یادگیری ماشین به‌شمار می‌آید. TPU، همان‌گونه که از نام آن پیداست، برای انجام سریع و مؤثر محاسبات مربوط به این تنسورها طراحی شده است. با دیجی بینو همراه باشید تا بیشتر با این پردازنده جدید آشنا بشید.


tpu


چرا گوگل تصمیم به ساخت TPU گرفت؟

در میانه‌ی دهه‌ی ۲۰۱۰، گوگل با رشد فزاینده‌ی نیاز به پردازش مدل‌های یادگیری ماشین در سرویس‌های مختلف خود روبه‌رو شد. در آن زمان، استفاده از CPU و GPU برای اجرای این مدل‌ها، پاسخگوی حجم بالا و سرعت مورد نیاز گوگل نبود. سرویس‌هایی مانند Google Translate، جستجوی گوگل، پیشنهادهای مبتنی بر هوش مصنوعی در Google Photos و همچنین سیستم‌های تشخیص صدا و تصویر، همگی به پاسخ‌گویی سریع و دقیق نیاز داشتند.


مشکل اصلی این بود که CPUها برای وظایف عمومی طراحی شده بودند و اگرچه GPUها در پردازش موازی عملکرد خوبی داشتند، اما همچنان محدودیت‌هایی در توان مصرفی و مقیاس‌پذیری داشتند. گوگل به این نتیجه رسید که برای حفظ کیفیت خدمات و توسعه‌ی آینده‌ی خود، به یک پردازنده‌ی اختصاصی نیاز دارد؛ پردازنده‌ای که به‌طور خاص برای یادگیری ماشین طراحی شده باشد. این نیاز، سرآغاز شکل‌گیری TPU بود.


تاریخچه و توسعه TPU


گوگل نخستین نسل TPU را در سال ۲۰۱۵ معرفی کرد. هدف اصلی از طراحی این تراشه، پاسخ‌گویی سریع به نیازهای یادگیری ماشین در مقیاس گسترده بود. این نسل اولیه تنها از اجرای مدل‌های آموزش‌دیده پشتیبانی می‌کرد و قابلیت آموزش مدل‌ها را نداشت. با این حال، در همان مراحل نخست، توانست عملکردی به‌مراتب بهتر از سخت‌افزارهای موجود ارائه دهد.


موفقیت نسل اول، گوگل را به توسعه‌ی نسل‌های بعدی TPU ترغیب کرد. در سال‌های بعد، نسخه‌های جدیدتری از این تراشه معرفی شد که هر یک قابلیت‌های پیشرفته‌تری داشتند. از جمله ویژگی‌های نسخه‌های بعدی می‌توان به افزایش توان پردازشی، پشتیبانی از حافظه‌های سریع‌تر، بهبود سیستم خنک‌کننده و افزایش قابلیت استفاده در سرویس‌های ابری اشاره کرد.


شروع کار گوگل با TPU


نخستین کاربرد TPU در سرویس‌هایی مانند Google Translate و Google Photos بود. گوگل با استفاده از این تراشه توانست سرعت و دقت ترجمه‌ی زنده، پیشنهاد تصاویر مشابه و حتی جستجوی هوشمند را به‌طرز چشمگیری افزایش دهد. عملکرد خوب این پردازنده‌ها باعث شد که گوگل به‌تدریج آن را در سایر بخش‌ها و محصولات خود نیز به‌کار گیرد.


به‌ویژه در بخش «جستجوی صوتی» و سیستم‌های «پیشنهاد محتوا»، TPU به گوگل این امکان را داد که اطلاعات ورودی کاربران را به‌سرعت تحلیل کند و خروجی‌های مرتبط و دقیق ارائه دهد. این ویژگی‌ها نقش قابل توجهی در ارتقاء تجربه‌ی کاربری ایفا کردند.


نسل‌های مختلف TPU


هر نسل از TPU با پیشرفت‌هایی همراه بوده است. در ادامه، نگاهی مختصر به ویژگی‌های اصلی هر نسل می‌اندازیم:


TPU v1: نسل نخست، تنها برای اجرای مدل‌های یادگیری ماشین طراحی شده بود و قابلیت آموزش نداشت. تمرکز اصلی آن بر عملیات استنتاج بود.


TPU v2: در این نسل، امکان آموزش مدل‌ها نیز فراهم شد. همچنین حافظه‌ی پرسرعت HBM (حافظه‌ی پهنای باند بالا) به آن افزوده شد و توان پردازشی کلی افزایش یافت.


TPU v3: بهبود بیشتر در توان مصرفی و عملکرد، به‌همراه استفاده از سیستم خنک‌کننده‌ی مایع، از جمله ویژگی‌های برجسته‌ی این نسل بود.


TPU v4: نسل چهارم، برای استفاده در دیتاسنترهای بزرگ بهینه شد. این نسل از قدرت پردازشی بیشتری برخوردار است و یکپارچگی بالاتری با سرویس Google Cloud دارد.


tpu


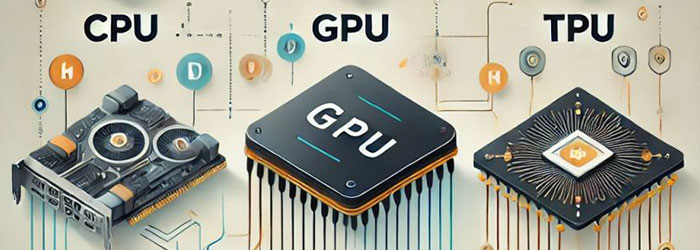
تفاوت TPU با CPU و GPU


برای درک بهتر عملکرد TPU، لازم است آن را با دو پردازنده‌ی رایج دیگر یعنی CPU و GPU مقایسه کنیم:


CPU برای پردازش‌های عمومی طراحی شده است. این پردازنده معمولاً هسته‌های محدودی دارد اما در انجام کارهای متنوع انعطاف‌پذیر است.


GPU  در اصل برای پردازش‌های گرافیکی ساخته شده اما به دلیل توانایی بالا در انجام عملیات موازی، در یادگیری ماشین نیز مورد استفاده قرار می‌گیرد.


TPU اما به‌طور اختصاصی برای انجام محاسبات خاص یادگیری ماشین مانند ضرب ماتریس‌ها و پردازش تنسورها طراحی شده است. این تخصص‌گرایی باعث می‌شود که سرعت آن در برخی از وظایف یادگیری عمیق، از GPU و CPU نیز بیشتر باشد.


مقایسه سرعت، مصرف انرژی و کاربرد


در اجرای مدل‌های یادگیری ماشین، TPU به‌طور معمول سرعت بالاتری نسبت به CPU و حتی بسیاری از GPUها دارد. این تفاوت در مواقعی که حجم داده زیاد است و نیاز به پاسخ‌گویی بلادرنگ وجود دارد، اهمیت بیشتری پیدا می‌کند. از سوی دیگر، TPU مصرف انرژی کمتری دارد و این موضوع در دیتاسنترها که هزاران پردازنده هم‌زمان فعال‌اند، مزیتی قابل‌توجه به‌حساب می‌آید.


در مجموع، TPU انتخابی مناسب برای اجرای مدل‌های یادگیری عمیق در مقیاس بالا است. البته در پروژه‌های کوچک یا نیازهای عمومی، GPU یا حتی CPU می‌تواند گزینه‌ی منطقی‌تری باشد.

tpu

کاربردهای اصلی TPU


از TPU بیش‌تر در حوزه‌های زیر استفاده می‌شود:


یادگیری عمیق (Deep Learning)

شبکه‌های عصبی مصنوعی

بینایی ماشین (Computer Vision)

پردازش زبان طبیعی (NLP)

تحلیل داده‌های بزرگ (Big Data Analysis)

سیستم‌های توصیه‌گر و رتبه‌بندی محتوا

به‌ویژه در پروژه‌هایی که با TensorFlow طراحی شده‌اند (که خود محصول گوگل است)، TPU به‌خوبی قابل استفاده است و عملکرد بسیار خوبی ارائه می‌دهد.


مزایا و معایب TPU


در کنار مزایای قابل توجه، TPU محدودیت‌هایی نیز دارد. در ادامه به برخی از مزایا و معایب این تراشه اشاره می‌کنیم:

مزایا:

سرعت پردازش بسیار بالا در مدل‌های یادگیری ماشین

مصرف انرژی پایین نسبت به عملکرد

بهینه‌سازی کامل برای TensorFlow

مناسب برای اجرای مدل‌های بسیار بزرگ و سنگین

معایب:

محدود به اکوسیستم گوگل

قابلیت استفاده‌ی محدود در دستگاه‌های شخصی یا خارج از Google Cloud

وابستگی شدید به ساختار خاص طراحی‌شده توسط گوگل

نقش TPU در Google Cloud


یکی از راه‌هایی که گوگل برای در دسترس‌ قرار دادن TPU ارائه داده، استفاده از آن در بستر ابری Google Cloud است. از آن‌جا که کاربران عادی یا حتی شرکت‌های متوسط، امکان خرید و راه‌اندازی TPUهای فیزیکی را ندارند، گوگل این سرویس را به‌صورت اجاره‌ای و مبتنی بر زمان در اختیار آن‌ها می‌گذارد.

در Google Cloud، کاربران می‌توانند بدون نیاز به تهیه‌ی سخت‌افزار فیزیکی، مدل‌های یادگیری ماشین خود را آموزش دهند یا اجرا کنند و از مزایای سرعت بالای TPU بهره‌مند شوند. این ویژگی باعث شده که پژوهشگران، دانشگاه‌ها و شرکت‌های نوپا نیز بتوانند به فناوری پیشرفته‌ی گوگل دسترسی داشته باشند.

نتیجه‌گیری

TPU یکی از نوآوری‌های مهم در حوزه‌ی سخت‌افزارهای هوش مصنوعی به‌شمار می‌رود. این تراشه با تمرکز بر سرعت، مصرف انرژی پایین و عملکرد بالا، توانسته است نقش مؤثری در توسعه‌ی سرویس‌های گوگل و دیگر پروژه‌های مبتنی بر یادگیری ماشین ایفا کند.

با توجه به رشد روزافزون کاربردهای هوش مصنوعی، پیش‌بینی می‌شود که TPUها در آینده‌ی نزدیک، جایگاه مهم‌تری در سیستم‌های پردازشی پیدا کنند. همچنین، گسترش زیرساخت‌های ابری و توسعه‌ی نسخه‌های جدیدتر این پردازنده، استفاده از آن را برای طیف وسیع‌تری از کاربران و سازمان‌ها ممکن خواهد کرد.


کیس گیمینگ

نکات مهم در انتخاب کیس مناسب برای سیستم های گیمینگ

بهینه سازی سیستم گیمینگ

چگونه سیستم گیمینگ خود را برای بازی های جدید بهینه سازی کنیم