ترکیب cluade با higgsfield

نحوه ترکیب cluade با higgsfield برای تولید محتوای ویدیویی حرفه‌ای

ترکیب cluade با higgsfield یکی از هوشمندانه‌ترین روش‌ها برای تولید محتوای ویدیویی باکیفیت، سریع و حرفه‌ای است. در سال‌های اخیر ابزارهای هوش مصنوعی به‌سرعت پیشرفت کرده‌اند و امروز دیگر برای تولید ویدیوهای تبلیغاتی، آموزشی، شبکه‌های اجتماعی یا حتی تیزرهای تجاری، نیازی به انجام تمام مراحل به‌صورت دستی نیست. اگر بدانید چگونه از قدرت تحلیل و نگارش Claude در کنار قابلیت‌های تولید ویدیو در Higgsfield استفاده کنید، می‌توانید محتوایی تولید کنید که هم از نظر کیفیت بصری و هم از نظر داستان‌پردازی در سطح بالایی قرار داشته باشد.

در این مقاله به‌صورت کاملاً کاربردی بررسی می‌کنیم که ترکیب cluade با higgsfield چگونه انجام می‌شود، چه مزایایی دارد، چه مراحلی باید طی شود و چگونه می‌توان بهترین نتیجه را از این دو ابزار هوش مصنوعی دریافت کرد.

 Claude و Higgsfield چه ابزارهایی هستند؟

قبل از اینکه وارد مراحل کار شویم، بهتر است با نقش هر ابزار آشنا شویم.

Claude  یک مدل هوش مصنوعی زبانی است که توسط شرکت Anthropic توسعه یافته است. این مدل در زمینه‌های مختلفی مانند تولید متن، سناریونویسی، ایده‌پردازی، تحلیل اطلاعات، خلاصه‌سازی و طراحی پرامپت عملکرد بسیار خوبی دارد.

در مقابل، Higgsfield یکی از ابزارهای نوظهور تولید ویدیو با هوش مصنوعی است که امکان ساخت ویدیوهای سینمایی، تبلیغاتی و شبکه‌های اجتماعی را تنها با استفاده از متن یا پرامپت فراهم می‌کند. این پلتفرم تمرکز ویژه‌ای روی حرکت طبیعی دوربین، کیفیت تصویر و تولید ویدیوهای واقع‌گرایانه دارد.

به همین دلیل، زمانی که این دو ابزار در کنار هم قرار می‌گیرند، یک زنجیره کامل تولید محتوا شکل می‌گیرد؛ از ایده اولیه و سناریو گرفته تا تولید ویدیوی نهایی.

ترکیب cluade با higgsfield

چرا ترکیب cluade با higgsfield بهترین انتخاب برای تولید ویدیو است؟

بزرگ‌ترین مزیت این روش، تقسیم وظایف بین دو هوش مصنوعی است. همچنین شما رو از نرم افزار های ویرایش ویدیو ، تولید محتوا و سیستم های قدرتمند هوش مصنوعی بی نیاز میکنه.

Claude در زمینه تولید متن، طراحی داستان، شخصیت‌پردازی و نوشتن پرامپت‌های دقیق عملکرد بسیار قدرتمندی دارد. از طرف دیگر Higgsfield همان متن را به یک ویدیوی حرفه‌ای تبدیل می‌کند.

مزایای این ترکیب عبارت‌اند از:

  • تولید سریع سناریو
  • ساخت استوری‌بورد دقیق
  • تولید پرامپت‌های حرفه‌ای
  • کاهش زمان ساخت ویدیو
  • افزایش کیفیت خروجی
  • کاهش هزینه تولید محتوا
  • امکان تولید ویدیو برای شبکه‌های اجتماعی
  • مناسب برای تبلیغات، آموزش و معرفی محصول

به همین دلیل بسیاری از تولیدکنندگان محتوا به سمت ترکیب cluade با higgsfield حرکت کرده‌اند.

مراحل اتصال  cluade به higgsfield برای تولید محتوای ویدیویی

برای اتصال cluade به higgsfield ابتدا می بایست اشتراک پولی هردو سایت رو خریداری کنید سپس مراحل زیر را انجام دهید:

  1. وارد تنظیمات Claude شوید.
  2. به بخش Settings → Connectors بروید.
  3. روی Add Custom Connector کلیک کنید.
  4. نام Connector را Higgsfield قرار دهید.
  5. آدرس زیر را وارد کنید:

https://mcp.higgsfield.ai/mcp

  1. روی Add یا Connect کلیک کنید.
  2. صفحه ورود Higgsfield باز می‌شود؛ با حساب Higgsfield خود وارد شوید.
  3. پس از تأیید دسترسی، اتصال برقرار می‌شود و می‌توانید مستقیماً داخل Claude از مدل‌های تصویر و ویدیوی Higgsfield استفاده کنید.4

بعد از اتصال می‌توانید در Claude دستوراتی مثل دستورات زیر را اجرا کنید:

Create a cinematic video of a dragon flying over snowy mountains

یا

Generate a photorealistic portrait with studio lighting

Claude درخواست را از طریق Higgsfield اجرا می‌کند و خروجی تصویر یا ویدیو را برمی‌گرداند.

ترکیب cluade با higgsfield

چگونه با ترکیب cluade با higgsfield پرامپت حرفه‌ای تولید کنیم؟

یکی از نقاط قوت Claude تولید پرامپت‌های دقیق برای ابزارهای تولید تصویر و ویدیو است.

به جای نوشتن یک جمله ساده مانند:

مردی در حال راه رفتن.

می‌توان از Claude خواست پرامپتی مانند نمونه زیر تولید کند:

مردی حدود ۳۰ ساله با کت مشکی در خیابانی بارانی هنگام غروب قدم می‌زند، نورهای نئون روی آسفالت خیس منعکس شده‌اند، دوربین با حرکت آرام تراکینگ از روبه‌رو حرکت می‌کند، فضای سینمایی، نورپردازی دراماتیک، کیفیت 4K، عمق میدان کم.

چنین پرامپتی اطلاعات بسیار بیشتری در اختیار Higgsfield قرار می‌دهد و نتیجه نهایی طبیعی‌تر خواهد بود.

کاربردهای ترکیب cluade با higgsfield در کسب‌وکارها

امروزه شرکت‌ها از این روش برای تولید انواع محتوا استفاده می‌کنند.

برخی کاربردهای مهم عبارت‌اند از:

  • ساخت تبلیغات اینستاگرامی
  • تولید محتوای آموزشی
  • ساخت ویدیوهای معرفی محصول
  • تولید تیزرهای تبلیغاتی
  • ساخت ویدیوهای یوتیوب
  • طراحی ویدیوهای برندینگ
  • تولید محتوای فروشگاهی
  • معرفی خدمات سازمانی
  • ساخت ویدیوهای نمایشگاهی

یکی از مزیت‌های مهم ترکیب cluade با higgsfield این است که تیم‌های کوچک نیز می‌توانند بدون تجهیزات فیلم‌برداری گران‌قیمت، ویدیوهای حرفه‌ای تولید کنند.

نکات مهم برای افزایش کیفیت خروجی در ترکیب cluade با   higgsfield

اگر می‌خواهید خروجی حرفه‌ای داشته باشید، رعایت چند نکته ضروری است.

ابتدا سناریو را کامل بنویسید و سپس آن را به سکانس‌های کوتاه تقسیم کنید.

برای هر سکانس اطلاعات زیر را مشخص کنید:

  • محل فیلم‌برداری
  • زمان روز
  • شرایط آب‌وهوا
  • شخصیت‌ها
  • احساس صحنه
  • حرکت دوربین
  • سبک تصویربرداری
  • رنگ غالب
  • نوع نورپردازی

همچنین بهتر است در پایان هر پرامپت، کیفیت موردنظر مانند 4K یا Cinematic Style را نیز ذکر کنید.

Claude در این بخش می‌تواند کمک زیادی به استانداردسازی پرامپت‌ها کند و همین موضوع باعث می‌شود ترکیب cluade با higgsfield نتایج بسیار بهتری نسبت به استفاده جداگانه از هر ابزار داشته باشد.

اشتباهات رایج هنگام استفاده از ترکیب cluade با higgsfield

برخی کاربران تصور می‌کنند نوشتن یک جمله کوتاه برای تولید ویدیو کافی است، اما این تصور معمولاً باعث افت کیفیت خروجی می‌شود.

اشتباهات رایج شامل موارد زیر است:

  • پرامپت‌های بسیار کوتاه
  • مشخص نکردن زاویه دوربین
  • ننوشتن احساس صحنه
  • تعیین نکردن سبک تصویربرداری
  • تغییر ناگهانی شخصیت‌ها بین سکانس‌ها
  • استفاده از توضیحات مبهم
  • نداشتن سناریوی منسجم
  • بی‌توجهی به ترتیب منطقی سکانس‌ها

اگر این موارد رعایت شوند، خروجی نهایی بسیار حرفه‌ای‌تر خواهد بود.

ترکیب cluade با higgsfield

آیا ترکیب cluade با higgsfield جایگزین تیم تولید محتوا می‌شود؟

پاسخ کوتاه این است که خیر.

این ابزارها فرآیند تولید محتوا را سرعت می‌بخشند، اما همچنان خلاقیت، تجربه و تصمیم‌گیری انسانی نقش مهمی در موفقیت پروژه دارند. هوش مصنوعی می‌تواند در ایده‌پردازی، نگارش سناریو، طراحی پرامپت و تولید ویدیو کمک کند، اما انتخاب پیام مناسب، شناخت مخاطب، تدوین نهایی و استراتژی انتشار همچنان به تخصص انسان وابسته است.

بهترین نتیجه زمانی حاصل می‌شود که متخصصان تولید محتوا از هوش مصنوعی به‌عنوان یک دستیار قدرتمند استفاده کنند، نه جایگزین کامل.

بهترین گردش کار برای تولید ویدیو با Claude و Higgsfield

اگر بخواهید یک فرآیند استاندارد داشته باشید، می‌توانید از این ترتیب استفاده کنید:

  1. تعیین هدف و مخاطب ویدیو.
  2. تولید ایده و ساختار اولیه با
  3. نگارش سناریو، دیالوگ و متن گویندگی.
  4. طراحی استوری‌بورد و پرامپت هر سکانس.
  5. انتقال پرامپت‌ها به
  6. تولید نسخه اولیه ویدیو.
  7. بازبینی، اصلاح پرامپت‌ها و تولید مجدد در صورت نیاز.
  8. افزودن موسیقی، زیرنویس، لوگو و تدوین نهایی.

این روند باعث می‌شود کیفیت خروجی افزایش یابد و زمان تولید پروژه نیز کاهش پیدا کند.

سخن آخر

هوش مصنوعی شیوه تولید محتوای ویدیویی را متحول کرده است و ترکیب cluade با higgsfield یکی از کاربردی‌ترین روش‌ها برای بهره‌گیری از این تحول به شمار می‌رود. Claude با توانایی بالا در ایده‌پردازی، سناریونویسی و تولید پرامپت‌های دقیق، پایه‌ای محکم برای تولید محتوا فراهم می‌کند و Higgsfield همان ایده‌ها را به ویدیوهای حرفه‌ای و چشم‌نواز تبدیل می‌کند.

اگر هدف شما تولید سریع‌تر، کاهش هزینه‌ها و افزایش کیفیت ویدیوهای تبلیغاتی، آموزشی یا شبکه‌های اجتماعی است، یادگیری ترکیب cluade با higgsfield می‌تواند یک مزیت رقابتی مهم برای شما باشد. با تمرین در نوشتن پرامپت‌های دقیق و بهینه‌سازی مراحل تولید، می‌توانید از این دو ابزار حداکثر بهره را ببرید و ویدیوهایی خلق کنید که هم از نظر فنی استاندارد باشند و هم بتوانند مخاطبان را به‌خوبی جذب کنند.
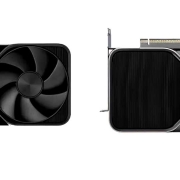
Nvidia NGC

معرفی Nvidia NGC

Nvidia DSX platform در سال‌های اخیر به یکی از مهم‌ترین زیرساخت‌های سازمانی برای اجرای پروژه‌های هوش مصنوعی و پردازش‌های سنگین تبدیل شده است. در کنار این زیرساخت قدرتمند، Nvidia NGC به‌عنوان اکوسیستم نرم‌افزاری رسمی شرکت NVIDIA نقش کلیدی در توسعه، آموزش، استقرار و مدیریت مدل‌های هوش مصنوعی ایفا می‌کند. این پلتفرم مجموعه‌ای از کانتینرهای بهینه‌شده، مدل‌های از پیش آموزش‌دیده، SDKهای تخصصی، فریم‌ورک‌های محبوب و ابزارهای حرفه‌ای را در اختیار توسعه‌دهندگان قرار می‌دهد تا بدون درگیر شدن با پیچیدگی‌های نصب و پیکربندی، پروژه‌های خود را با حداکثر کارایی اجرا کنند.
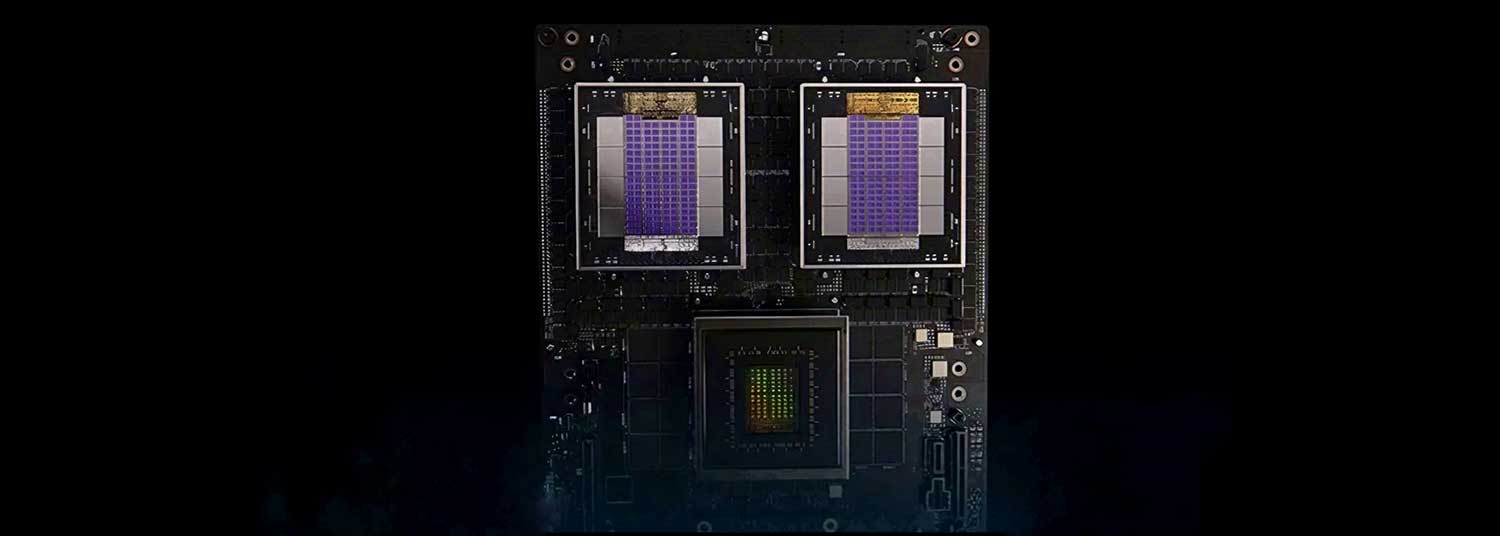
امروزه سازمان‌ها برای آموزش مدل‌های زبانی بزرگ (LLM)، بینایی ماشین، پردازش زبان طبیعی، تحلیل داده‌های حجیم و شبیه‌سازی‌های علمی به زیرساختی نیاز دارند که علاوه بر قدرت پردازشی بالا، از نظر نرم‌افزاری نیز کاملاً بهینه باشد. Nvidia NGC دقیقاً با همین هدف طراحی شده است. زمانی که این پلتفرم در کنار Nvidia DSX platform قرار می‌گیرد، محیطی یکپارچه برای توسعه پروژه‌های هوش مصنوعی ایجاد می‌شود که هم از نظر عملکرد و هم از نظر مقیاس‌پذیری، پاسخگوی نیاز شرکت‌های بزرگ و مراکز تحقیقاتی است.

 Nvidia NGC چیست و چرا اهمیت زیادی دارد؟

NVIDIA GPU Cloud  یا همان Nvidia NGC  یک پلتفرم نرم‌افزاری مبتنی بر فضای ابری است که توسط شرکت NVIDIA توسعه یافته تا فرآیند ساخت، آموزش و استقرار مدل‌های هوش مصنوعی را ساده‌تر کند. این پلتفرم در حقیقت یک مخزن دانلود ساده نیست، بلکه اکوسیستمی کامل از ابزارهای تخصصی هوش مصنوعی محسوب می‌شود.

در گذشته توسعه‌دهندگان مجبور بودند نسخه‌های مختلف  CUDA، cuDNN، TensorRT، PyTorch، TensorFlow  و سایر کتابخانه‌ها را به‌صورت دستی نصب و هماهنگ کنند. این فرآیند علاوه بر زمان‌بر بودن، احتمال بروز خطا و ناسازگاری را نیز افزایش می‌داد. Nvidia NGC این مشکل را با ارائه کانتینرهای آماده برطرف کرده است.

از طرف دیگر، بسیاری از سازمان‌هایی که از Nvidia DSX platform  استفاده می‌کنند، به محیطی نیاز دارند که بتواند حداکثر توان  GPUهای حرفه‌ای مانند سری H100 ، B200، RTX PRO و Blackwell را در اختیار آن‌ها قرار دهد. Nvidia NGC  دقیقاً برای همین منظور طراحی شده و تمامی ابزارهای موجود در آن توسط مهندسان NVIDIA تست و بهینه‌سازی شده‌اند.

قابلیت‌های Nvidia NGC در کنار Nvidia DSX platform

یکی از مهم‌ترین دلایل محبوبیت  Nvidia NGC، تنوع بالای ابزارها و سرویس‌هایی است که در اختیار کاربران قرار می‌دهد. این پلتفرم تقریباً تمام نیازهای توسعه‌دهندگان سیستم های هوش مصنوعی را پوشش می‌دهد و باعث می‌شود تیم‌های فنی بتوانند با سرعت بیشتری پروژه‌های خود را توسعه دهند.

Nvidia NGC

مهم‌ترین امکانات Nvidia NGC عبارت‌اند از:

  • کانتینرهای Docker کاملاً بهینه‌شده برای  GPU
  • مدل‌های آماده هوش مصنوعی
  • فریم‌ورک‌های  TensorFlow، PyTorch، MXNet و RAPIDS
  • کتابخانه‌های CUDA و cuDNN
  • TensorRT  برای افزایش سرعت استنتاج
  • Triton Inference Server  برای استقرار مدل‌ها
  • NVIDIA NeMo  برای توسعه مدل‌های زبانی بزرگ
  •  NVIDIA TAO Toolkit برای آموزش مدل‌ها بدون نیاز به کدنویسی پیچیده
  • ابزارهای مانیتورینگ GPU
  • SDKهای تخصصی پردازش تصویر، ویدئو و گفتار

زمانی که این مجموعه نرم‌افزاری روی Nvidia DSX platform ا جرا می‌شود، کاربران می‌توانند بدون نیاز به نصب دستی نرم‌افزارها، تنها در چند دقیقه محیط توسعه خود را آماده کنند. این موضوع زمان آماده‌سازی پروژه را به شکل محسوسی کاهش می‌دهد.
مزایای استفاده از Nvidia NGC روی Nvidia DSX platform

ترکیب Nvidia NGC با Nvidia DSX platform  مزایای فراوانی برای شرکت‌ها، دانشگاه‌ها و مراکز تحقیقاتی دارد. مهم‌ترین مزیت این راهکار، یکپارچگی کامل سخت‌افزار و نرم‌افزار است.

از مهم‌ترین مزایای این ترکیب می‌توان به موارد زیر اشاره کرد:

  • راه‌اندازی سریع محیط توسعه
  • حذف مشکلات ناسازگاری نسخه‌های نرم‌افزاری
  • بهره‌برداری حداکثری از توان GPU
  • بهینه‌سازی برای آموزش مدل‌های بسیار بزرگ
  • پشتیبانی از اجرای هم‌زمان چندین پروژه
  • امنیت بالا در سطح سازمانی
  • بروزرسانی منظم کانتینرها
  • استقرار آسان روی Kubernetes
  • امکان اجرا در دیتاسنتر یا فضای ابری
  • کاهش هزینه‌های نگهداری زیرساخت

به کمک این مزایا، سازمان‌ها می‌توانند پروژه‌های پیچیده هوش مصنوعی را با سرعت بیشتر و هزینه کمتر توسعه دهند. همچنین توسعه‌دهندگان زمان خود را به جای رفع مشکلات نرم‌افزاری، صرف طراحی مدل‌ها و بهینه‌سازی الگوریتم‌ها می‌کنند.
کاربردهای Nvidia NGC در پروژه‌های سازمانی با Nvidia DSX platform

Nvidia NGC  در صنایع مختلف کاربرد دارد و تقریباً هر پروژه‌ای که به پردازش GPU نیاز داشته باشد، می‌تواند از این پلتفرم بهره ببرد.
Nvidia NGC

برخی از مهم‌ترین کاربردها عبارت‌اند از:

  • آموزش مدل‌های یادگیری عمیق
  • توسعه مدل‌ها ی مولد هوش مصنوعی (Generative AI)
  • پردازش زبان طبیعی (NLP)
  • بینایی ماشین
  • تشخیص اشیا
  • تحلیل تصاویر پزشکی
  • خودروهای خودران
  • رباتیک
  • پردازش داده‌های مالی
  • تحلیل داده‌های بزرگ
  • شبیه‌سازی‌های علمی
  • مدل‌سازی آب‌وهوا
  • تحقیقات دانشگاهی
  • محاسبات HPC

در تمامی این کاربردها، Nvidia DSX platform نقش موتور پردازشی را بر عهده دارد و Nvidia NGC ابزارهای مورد نیاز برای آموزش و استقرار مدل‌ها را فراهم می‌کند.

چرا سازمان‌های بزرگ از Nvidia NGC استفاده می‌کنند؟

امروزه بسیاری از شرکت‌های فعال در حوزه هوش مصنوعی، مراکز تحقیقاتی و ارائه‌دهندگان خدمات ابری از Nvidia NGC استفاده می‌کنند. دلیل اصلی این موضوع، کاهش زمان توسعه پروژه‌ها و افزایش بهره‌وری تیم‌های فنی است.

پشتیبانی رسمی   NVIDIA، بروزرسانی مداوم، امنیت بالا، عملکرد پایدار و سازگاری کامل با جدیدترین معماری‌های GPU باعث شده است Nvidia NGC  به انتخاب اول بسیاری از سازمان‌ها تبدیل شود.

از سوی دیگر، زمانی که این پلتفرم روی  Nvidia DSX platform اجرا می‌شود، مدیران زیرساخت می‌توانند منابع پردازشی را به‌صورت متمرکز مدیریت کرده و پروژه‌های مختلف را بدون افت عملکرد اجرا کنند. این ویژگی برای شرکت‌هایی که چندین تیم توسعه هوش مصنوعی دارند، اهمیت بسیار زیادی دارد.

تفاوت Nvidia NGC با نصب سنتی ابزارهای هوش مصنوعی

در روش سنتی، توسعه‌دهندگان باید هر یک از ابزارهای موردنیاز مانند  CUDA، cuDNN، TensorFlow، PyTorch  و سایر کتابخانه‌ها را جداگانه نصب و پیکربندی کنند. این فرآیند علاوه بر صرف زمان زیاد، احتمال بروز ناسازگاری میان نسخه‌ها را نیز افزایش می‌دهد.

Nvidia NGC

اما در Nvidia NGC، تمامی این ابزارها به‌صورت یکپارچه و از پیش بهینه‌سازی‌شده در قالب کانتینرهای آماده ارائه می‌شوند. این رویکرد نه‌تنها سرعت راه‌اندازی پروژه را افزایش می‌دهد، بلکه عملکرد مدل‌ها را نیز بهبود می‌بخشد. هنگامی که این کانتینرها روی Nvidia DSX platform  اجرا می‌شوند، توسعه‌دهندگان می‌توانند بدون نگرانی از تنظیمات پیچیده، از حداکثر توان پردازشی GPUها بهره ببرند.

سخن آخر

Nvidia NGC یکی از کامل‌ترین اکوسیستم‌های نرم‌افزاری برای توسعه، آموزش و استقرار پروژه‌های هوش مصنوعی است. این پلتفرم با ارائه کانتینرهای آماده، مدل‌های از پیش آموزش‌دیده، SDKهای تخصصی و ابزارهای بهینه‌شده، فرآیند توسعه را سریع‌تر، ساده‌تر و مطمئن‌تر می‌کند.

در کنار آن، Nvidia DSX platform  به‌عنوان زیرساخت سخت‌افزاری قدرتمند، بستری مناسب برای اجرای پروژه‌های سنگین هوش مصنوعی، یادگیری عمیق و محاسبات HPC فراهم می‌آورد. ترکیب این دو راهکار، محیطی یکپارچه، پایدار و مقیاس‌پذیر ایجاد می‌کند که پاسخگوی نیاز شرکت‌های فناوری، مراکز داده، دانشگاه‌ها و سازمان‌های بزرگ است.

اگر هدف شما ایجاد زیرساختی حرفه‌ای برای پروژه‌های هوش مصنوعی، مدل‌های زبانی بزرگ، پردازش تصویر یا تحلیل داده‌های حجیم است، استفاده از Nvidia NGC در کنار Nvidia DSX platform  یکی از بهترین و آینده‌نگرانه‌ترین انتخاب‌های موجود خواهد بود.

Nvidia DSX platform

معرفی Nvidia DSX platform

 Nvidia DSX platform یکی از جدیدترین راهکارهای انویدیا برای توسعه و استقرار زیرساخت‌های هوش مصنوعی در مقیاس سازمانی است که با هدف ساده‌سازی آموزش، استنتاج (Inference) و مدیریت مدل‌های هوش مصنوعی طراحی شده است.

با افزایش تقاضا برای مدل‌های زبانی بزرگ (LLM)، سیستم‌های مولد هوش مصنوعی و پردازش داده‌های عظیم، شرکت‌ها به بستری نیاز دارند که علاوه بر قدرت پردازشی بالا، امکان مدیریت آسان منابع سخت‌افزاری و نرم‌افزاری را نیز فراهم کند. Nvidia DSX  platform  دقیقاً با همین رویکرد توسعه یافته و ترکیبی از سخت‌افزار، نرم‌افزار، شبکه و ابزارهای مدیریتی را در قالب یک اکوسیستم یکپارچه ارائه می‌دهد.

در سال‌های اخیر، بسیاری از سازمان‌ها به دنبال ساخت مراکز داده تخصصی برای هوش مصنوعی هستند. اما راه‌اندازی چنین زیرساختی تنها به خرید پردازنده‌های گرافیکی محدود نمی‌شود؛ بلکه نیازمند طراحی صحیح شبکه، ذخیره‌سازی، سیستم‌عامل، ابزارهای توسعه و مدیریت منابع است.

Nvidia DSX platform  این پیچیدگی‌ها را تا حد زیادی کاهش داده و بستری آماده برای اجرای پروژه‌های سنگین هوش مصنوعی در اختیار سازمان‌ها قرار می‌دهد.

Nvidia DSX platform چیست؟

پلتفرم Nvidia DSX یک پلتفرم جامع برای ایجاد زیرساخت هوش مصنوعی در مقیاس دیتاسنتر و سیستم های هوش مصنوعی است که مجموعه‌ای از فناوری‌های پیشرفته انویدیا را در کنار یکدیگر قرار می‌دهد. این پلتفرم با هدف اجرای سریع‌تر مدل‌های یادگیری عمیق، مدل‌های مولد، تحلیل داده و پردازش‌های HPC طراحی شده است.

این راهکار معمولاً شامل پردازنده‌های گرافیکی قدرتمند، شبکه‌های پرسرعت، ذخیره‌سازی بهینه، نرم‌افزارهای مدیریت کلاستر، کتابخانه‌های CUDA، TensorRT، NCCL، NVIDIA AI Enterprise و ابزارهای مانیتورینگ است. نتیجه این یکپارچگی، کاهش زمان استقرار پروژه‌ها و افزایش بهره‌وری تیم‌های توسعه خواهد بود.

Nvidia DSX platform

یکی از ویژگی‌های مهم Nvidia DSX platform، قابلیت توسعه‌پذیری آن است. سازمان‌ها می‌توانند از چند GPU آغاز کرده و در آینده بدون ایجاد تغییرات اساسی، ظرفیت پردازشی خود را تا هزاران GPU افزایش دهند.

مزایای Nvidia DSX platform برای سازمان‌ها

مهم‌ترین دلیل محبوبیت Nvidia DSX platform، کاهش پیچیدگی طراحی زیرساخت هوش مصنوعی است. بسیاری از شرکت‌ها زمان زیادی را صرف انتخاب تجهیزات سازگار، طراحی شبکه و بهینه‌سازی نرم‌افزار می‌کنند، اما این پلتفرم بسیاری از این مراحل را از پیش آماده کرده است.

از مهم‌ترین مزایای این پلتفرم می‌توان به موارد زیر اشاره کرد:

  • مقیاس‌پذیری بسیار بالا
  • سازگاری کامل با GPUهای جدید انویدیا
  • پشتیبانی از مدل‌های زبانی بزرگ
  • مدیریت متمرکز منابع
  • کاهش زمان استقرار پروژه
  • امنیت مناسب برای محیط‌های سازمانی
  • بهره‌وری بالا در مصرف انرژی نسبت به توان پردازشی
  • پشتیبانی از Kubernetes و کانتینرها
  • امکان استفاده از نرم‌افزارهای NVIDIA AI Enterprise
  • عملکرد پایدار در بارهای پردازشی سنگین

یکی دیگر از مزایای  Nvidia DSX platform امکان اجرای هم‌زمان چندین پروژه هوش مصنوعی روی یک زیرساخت مشترک است. این قابلیت باعث استفاده بهینه از منابع سخت‌افزاری و کاهش هزینه‌های عملیاتی می‌شود.

معماری Nvidia DSX platform چگونه کار می‌کند؟

معماری Nvidia DSX platform  بر پایه یک اکوسیستم یکپارچه شکل گرفته است. در پایین‌ترین لایه، پردازنده‌های گرافیکی قدرتمند انویدیا قرار دارند که مسئول پردازش مدل‌های یادگیری عمیق هستند.

این GPUها از طریق شبکه‌های پرسرعت مانند InfiniBand یا Ethernet با پهنای باند بالا به یکدیگر متصل می‌شوند تا انتقال داده با کمترین تأخیر انجام شود.

Nvidia DSX platform

در لایه نرم‌افزار، کتابخانه‌هایی مانند CUDA، cuDNN، NCCL  و TensorRT  وظیفه بهینه‌سازی پردازش‌ها را بر عهده دارند. همچنین ابزارهای ارکستراسیون مانند Kubernetes امکان مدیریت خودکار بارهای کاری را فراهم می‌کنند.

در بخش مدیریت نیز داشبوردهای مانیتورینگ، کنترل مصرف منابع، گزارش‌گیری و مدیریت کاربران در اختیار مدیران زیرساخت قرار می‌گیرد. این ساختار باعث می‌شود Nvidia DSX platform  برای پروژه‌های کوچک و بسیار بزرگ به یک اندازه کارآمد باشد.

کاربردهای Nvidia DSX platform

امروزهNvidia DSX platform  در صنایع مختلف مورد استفاده قرار می‌گیرد. مهم‌ترین کاربردهای آن عبارت‌اند از:

  • آموزش مدل‌های زبانی بزرگ (LLM)
  • توسعه هوش مصنوعی مولد
  • بینایی ماشین
  • پردازش تصویر پزشکی
  • تحلیل ویدئو
  • خودروهای خودران
  • رباتیک
  • شبیه‌سازی‌های علمی
  • تحلیل داده‌های مالی
  • پردازش داده‌های ژنوم

شرکت‌هایی که نیاز به پردازش میلیون‌ها رکورد داده یا آموزش مدل‌های چندصد میلیارد پارامتری دارند، می‌توانند از Nvidia DSX platform  برای کاهش زمان آموزش مدل‌ها استفاده کنند.

علاوه بر این، دانشگاه‌ها، مراکز تحقیقاتی و آزمایشگاه‌های علمی نیز از این پلتفرم برای انجام پروژه‌های تحقیقاتی پیشرفته بهره می‌برند.

سخت‌افزارهای سازگار با Nvidia DSX platform

یکی از نقاط قوت Nvidia DSX platform پشتیبانی از جدیدترین سخت‌افزارهای انویدیا است. این پلتفرم معمولاً با GPUهای سری دیتاسنتری مانند H100، H200، B200، Blackwell و نسل‌های جدید سازگاری کامل دارد.

در کنار GPUها، استفاده از پردازنده‌های قدرتمند x86 یا ARM ، حافظه‌ها DDR5، شبکه‌های پرسرعت InfiniBand ، سوئیچ‌های NVIDIA Spectrum و ذخیره‌سازی NVMe باعث افزایش عملکرد کلی سیستم می‌شود.

همچنین استفاده از فناوری NVLink موجب افزایش سرعت ارتباط میان GPUها شده و زمان آموزش مدل‌های بزرگ را کاهش می‌دهد.

Nvidia DSX platform

تفاوت Nvidia DSX platform با زیرساخت‌های سنتی

در زیرساخت‌های سنتی، مدیران فناوری اطلاعات باید تمامی اجزای سخت‌افزاری و نرم‌افزاری را به‌صورت جداگانه انتخاب، نصب و پیکربندی کنند. این فرآیند زمان‌بر بوده و احتمال بروز ناسازگاری میان تجهیزات را افزایش می‌دهد.

در مقابل، Nvidia DSX platform  یک معماری از پیش اعتبارسنجی‌ شده ارائه می‌دهد که تمامی اجزا برای همکاری با یکدیگر بهینه شده‌اند. این موضوع باعث کاهش زمان راه‌اندازی، افزایش پایداری سیستم و ساده‌تر شدن فرآیند نگهداری می‌شود.

همچنین عملکرد این پلتفرم در اجرای بارهای کاری مرتبط با هوش مصنوعی نسبت به بسیاری از زیرساخت‌های عمومی بالاتر است؛ زیرا تمامی اجزا با تمرکز بر پردازش‌های AI طراحی شده‌اند.

چرا Nvidia DSX platform برای آینده هوش مصنوعی اهمیت دارد؟

رشد سریع مدل‌های هوش مصنوعی باعث شده نیاز به زیرساخت‌های قدرتمند بیش از هر زمان دیگری احساس شود. مدل‌هایی با صدها میلیارد پارامتر به هزاران GPU و شبکه‌هایی با پهنای باند بسیار بالا نیاز دارند.   Nvidia DSX platform  دقیقاً برای پاسخ به این نیازها توسعه یافته است.

پشتیبانی از آموزش توزیع‌شده، استنتاج با تأخیر کم، مدیریت هوشمند منابع و قابلیت توسعه در مقیاس بسیار بزرگ، این پلتفرم را به گزینه‌ای مناسب برای سازمان‌هایی تبدیل کرده که قصد سرمایه‌گذاری بلندمدت روی هوش مصنوعی دارند.

با توجه به مسیر حرکت صنعت، انتظار می‌رود Nvidia DSX platform نقش مهمی در نسل آینده دیتاسنترهای هوش مصنوعی، رایانش ابری و پردازش مدل‌های مولد ایفا کند.

سخن آخر

Nvidia DSX platform  تنها یک مجموعه سخت‌افزاری نیست؛ بلکه یک اکوسیستم کامل برای توسعه، آموزش، استقرار و مدیریت پروژه‌های هوش مصنوعی در سطح سازمانی محسوب می‌شود. این پلتفرم با ترکیب GPUهای قدرتمند، شبکه‌های پرسرعت، ابزارهای نرم‌افزاری و قابلیت مدیریت متمرکز، بسیاری از چالش‌های راه‌اندازی زیرساخت‌های AI را برطرف می‌کند.

اگر سازمان شما قصد توسعه مدل‌های هوش مصنوعی، اجرای پروژه‌های یادگیری عمیق یا ایجاد یک دیتاسنتر تخصصی AI را دارد، Nvidia DSX platform  می‌تواند یکی از بهترین گزینه‌های موجود باشد. با توجه به روند رو به رشد فناوری‌های هوش مصنوعی، سرمایه‌گذاری روی زیرساخت‌هایی مانند این پلتفرم، می‌تواند زمینه‌ساز توسعه سریع‌تر، کاهش هزینه‌های عملیاتی و افزایش بهره‌وری در سال‌های آینده باشد.

معماری Blackwell

معرفی معماری Black well

معماری Blackwell نقطه عطف جدیدی در دنیای پردازش‌های هوش مصنوعی و محاسبات سنگین محسوب می‌شود و انویدیا با معرفی این معماری، فصل تازه‌ای در توسعه مراکز داده، مدل‌های زبانی بزرگ و پردازش‌های گرافیکی پیشرفته آغاز کرده است. در سال‌های اخیر رشد سریع هوش مصنوعی باعث شده نیاز به سخت‌افزارهای قدرتمندتر از همیشه احساس شود و به همین دلیل معماری Black well با هدف ارائه توان پردازشی بیشتر، مصرف انرژی بهینه‌تر و عملکرد بالاتر طراحی شده است.

این معماری که جانشین نسل Hopper محسوب می‌شود، نه تنها در زمینه آموزش مدل‌های هوش مصنوعی عملکرد فوق‌العاده‌ای ارائه می‌دهد، بلکه برای استنتاج (Inference)، تحلیل داده‌های عظیم و پردازش‌های علمی نیز گزینه‌ای ایده‌آل به شمار می‌رود. بسیاری از شرکت‌های فعال در حوزه هوش مصنوعی، رایانش ابری و مراکز داده اکنون توجه ویژه‌ای به معماری Blackwell دارند.

معماری Blackwell چیست؟

معماری Blackwell جدیدترین معماری پردازشی شرکت انویدیا است که برای پاسخگویی به نیازهای نسل آینده هوش مصنوعی توسعه یافته است. این معماری به افتخار ریاضیدان برجسته آمریکایی «دیوید بلک‌ول» نام‌گذاری شده و تمرکز اصلی آن بر افزایش توان پردازش مدل‌های هوش مصنوعی در مقیاس بسیار بزرگ است.

در معماری Blackwell از فناوری‌های پیشرفته‌ای استفاده شده که امکان پردازش تریلیون‌ها پارامتر را فراهم می‌کند. این موضوع برای مدل‌های زبانی بزرگ، سیستم‌های مولد محتوا، پردازش تصویر، بینایی ماشین و تحلیل داده اهمیت بسیار زیادی دارد.

معماری Blackwell

یکی از مهم‌ترین ویژگی‌های این معماری، استفاده از طراحی چند تراشه‌ای یا Multi-Die است. در این ساختار، چندین بخش پردازشی از طریق ارتباطات فوق سریع به یکدیگر متصل می‌شوند و مانند یک پردازنده واحد عمل می‌کنند. این روش باعث افزایش چشمگیر کارایی و بهره‌وری می‌شود.

علاوه بر این، معماری Blackwell از نسل جدید Tensor Core ها بهره می‌برد که برای پردازش عملیات مرتبط با هوش مصنوعی طراحی شده‌اند. این هسته‌ها عملکرد مدل‌های یادگیری عمیق را به شکل قابل توجهی افزایش می‌دهند و زمان آموزش مدل‌ها را کاهش می‌دهند.

ویژگی‌های مهم معماری Blackwell

یکی از دلایل اهمیت معماری Blackwell مجموعه‌ای از قابلیت‌های فنی پیشرفته آن است که نسبت به نسل قبل پیشرفت چشمگیری دارند.

اولین ویژگی مهم، افزایش توان پردازشی است. پردازنده‌های مبتنی بر این معماری قادر هستند حجم عظیمی از داده‌ها را در زمان بسیار کوتاه پردازش کنند. این موضوع برای مراکز داده و شرکت‌های فعال در حوزه هوش مصنوعی اهمیت حیاتی دارد.

دومین ویژگی، پشتیبانی از محاسبات FP4 است. این فناوری امکان اجرای مدل‌های هوش مصنوعی را با دقت مناسب و سرعت بسیار بالاتر فراهم می‌کند. نتیجه این موضوع کاهش هزینه پردازش و افزایش بهره‌وری مراکز داده خواهد بود.

سومین ویژگی، ارتباط فوق سریع میان تراشه‌ها است. فناوری NVLink در این نسل ارتقا یافته و پهنای باند بسیار بیشتری نسبت به نسل Hopper ارائه می‌دهد. این مسئله باعث می‌شود چندین پردازنده گرافیکی بتوانند به‌صورت هماهنگ روی پروژه‌های عظیم هوش مصنوعی فعالیت کنند.

ویژگی دیگر معماری Blackwell کاهش مصرف انرژی در مقایسه با قدرت پردازشی ارائه شده است. شرکت‌ها اکنون می‌توانند با مصرف انرژی کمتر، مدل‌های بزرگ‌تر و پیچیده‌تری را اجرا کنند که از نظر اقتصادی اهمیت فراوانی دارد.

D:\digibino\posts\معرفی معماری Black well

معماری Black well و نقش آن در توسعه هوش مصنوعی

امروزه رشد سریع هوش مصنوعی باعث شده نیاز به سخت‌افزارهای قدرتمند به شدت افزایش پیدا کند. معماری Blackwell دقیقاً برای پاسخ به این نیاز طراحی شده است.

مدل‌های زبانی مدرن مانند سیستم‌های تولید متن، تصویر و ویدئو به میلیاردها یا حتی تریلیون‌ها پارامتر نیاز دارند. پردازش چنین مدل‌هایی بدون استفاده از سخت‌افزارهای قدرتمند تقریباً غیرممکن است. معماری Blackwell با ارائه قدرت پردازشی فوق‌العاده، امکان آموزش و اجرای این مدل‌ها را فراهم می‌کند.

یکی دیگر از مزایای مهم این معماری، بهبود فرآیند استنتاج است. بسیاری از سرویس‌های هوش مصنوعی روزانه میلیون‌ها درخواست کاربران را پردازش می‌کنند. هرچه سرعت استنتاج بیشتر باشد، کاربران پاسخ سریع‌تری دریافت می‌کنند و هزینه‌های عملیاتی کاهش می‌یابد.

همچنین معماری Blackwell در حوزه‌هایی مانند خودروهای خودران، پزشکی، امنیت سایبری، شبیه‌سازی‌های علمی و تحلیل داده‌های کلان نیز کاربرد گسترده‌ای دارد. این معماری می‌تواند حجم عظیمی از داده‌ها را در مدت زمان کوتاهی پردازش کند و تصمیم‌گیری هوشمند را بهبود دهد.

کارشناسان معتقدند معماری Blackwell یکی از مهم‌ترین زیرساخت‌های نسل آینده هوش مصنوعی خواهد بود و بسیاری از فناوری‌های نوظهور بر پایه توان پردازشی آن توسعه پیدا خواهند کرد.

مقایسه معماری Blackwell با معماری Hopper

برای درک بهتر ارزش معماری Blackwell باید آن را با نسل قبلی یعنی Hopper مقایسه کنیم.

معماری Hopper در زمان معرفی خود تحول بزرگی در صنعت پردازش هوش مصنوعی ایجاد کرد، اما افزایش ابعاد مدل‌های زبانی باعث شد نیاز به نسل جدیدی از پردازنده‌ها به وجود آید. معماری Blackwell دقیقاً برای رفع این محدودیت‌ها توسعه پیدا کرده است.

در بخش قدرت پردازش، نسل جدید چندین برابر عملکرد بالاتری ارائه می‌دهد. همچنین استفاده از فناوری FP4 باعث افزایش سرعت پردازش مدل‌های هوش مصنوعی شده است.

در زمینه ارتباط میان پردازنده‌ها نیز NVLink جدید پهنای باند بیشتری فراهم می‌کند. این موضوع برای خوشه‌های پردازشی بزرگ اهمیت بسیار زیادی دارد.

از نظر مصرف انرژی نیز معماری Blackwell عملکرد بهینه‌تری نسبت به Hopper ارائه می‌دهد. این مزیت به شرکت‌ها کمک می‌کند هزینه‌های عملیاتی خود را کاهش دهند و بهره‌وری بیشتری داشته باشند.

معماری Blackwell

به طور کلی می‌توان گفت معماری Blackwell نه تنها یک ارتقای ساده نیست، بلکه یک جهش بزرگ در دنیای پردازش‌های مبتنی بر هوش مصنوعی محسوب می‌شود.

آینده معماری Blackwell در صنعت فناوری

بسیاری از تحلیلگران معتقدند معماری Blackwell نقش مهمی در آینده صنعت فناوری ایفا خواهد کرد. افزایش تقاضا برای سیستم های هوش مصنوعی، رایانش ابری و پردازش داده‌های عظیم باعث شده نیاز به سخت‌افزارهای قدرتمندتر هر روز بیشتر شود.

شرکت‌های فعال در حوزه فناوری به دنبال زیرساخت‌هایی هستند که بتوانند حجم بالای پردازش را با هزینه مناسب انجام دهند. معماری Black well یکی از بهترین گزینه‌ها برای پاسخ به این نیاز است.

معماری Blackwell

علاوه بر مراکز داده، انتظار می‌رود این معماری در حوزه رباتیک، خودروهای هوشمند، شبیه‌سازی صنعتی، طراحی دارو، تحقیقات علمی و پردازش‌های مالی نیز کاربرد گسترده‌ای پیدا کند.

با توجه به روند فعلی بازار، معماری Blackwell احتمالاً به یکی از مهم‌ترین استانداردهای پردازش هوش مصنوعی در سال‌های آینده تبدیل خواهد شد و نقش کلیدی در توسعه نسل بعدی فناوری‌های مبتنی بر هوش مصنوعی ایفا می‌کند.

سخن آخر

معماری Blackwell را می‌توان یکی از مهم‌ترین دستاوردهای جدید صنعت پردازش گرافیکی و هوش مصنوعی دانست. این معماری با ارائه توان پردازشی بسیار بالا، مصرف انرژی بهینه، فناوری‌های جدید Tensor Core و ارتباطات پرسرعت میان تراشه‌ها، بستری مناسب برای توسعه نسل آینده هوش مصنوعی فراهم کرده است.

با گسترش کاربردهای هوش مصنوعی در صنایع مختلف، اهمیت سخت‌افزارهای قدرتمند بیش از گذشته شده است. در این میان، معماری Blackwell می‌تواند نقش کلیدی در آموزش مدل‌های بزرگ، پردازش داده‌های پیچیده و ارائه سرویس‌های هوشمند ایفا کند. به همین دلیل بسیاری از کارشناسان آن را یکی از مهم‌ترین فناوری‌های سال‌های اخیر در حوزه پردازش پیشرفته می‌دانند.

خرید سیستم برای هوش مصنوعی

راهنمای خرید سیستم برای هوش مصنوعی

خرید سیستم برای هوش مصنوعی یکی از مهم‌ترین تصمیماتی است که برنامه‌نویسان، دانشجویان، تولیدکنندگان محتوا و فعالان حوزه فناوری با آن روبه‌رو هستند. با رشد سریع ابزارهای مبتنی بر هوش مصنوعی، انتخاب یک سیستم مناسب دیگر فقط به داشتن پردازنده قوی محدود نمی‌شود. امروزه قدرت پردازش گرافیکی، میزان حافظه رم، سرعت ذخیره‌سازی و حتی توان منبع تغذیه در عملکرد مدل‌های هوش مصنوعی نقش مهمی دارند.

بسیاری از افراد هنگام خرید کامپیوتر یا ورک‌استیشن برای پروژه‌های AI تنها به مشخصات ظاهری توجه می‌کنند و در نتیجه سیستمی تهیه می‌کنند که پس از مدتی پاسخگوی نیازهای آن‌ها نیست. در این مقاله قصد داریم مهم‌ترین نکات مربوط به خرید سیستم برای هوش مصنوعی را بررسی کنیم تا بتوانید با توجه به بودجه و نیاز خود بهترین انتخاب را داشته باشید.

چرا خرید سیستم برای هوش مصنوعی با کامپیوترهای معمولی متفاوت است؟

پروژه‌های هوش مصنوعی به حجم بالایی از پردازش نیاز دارند. هنگام آموزش مدل‌های یادگیری ماشین یا اجرای مدل‌های زبانی بزرگ، هزاران و حتی میلیون‌ها محاسبه در هر ثانیه انجام می‌شود. به همین دلیل سیستمی که برای کارهای روزمره مانند وب‌گردی یا اجرای بازی مناسب است، لزوماً برای AI عملکرد خوبی نخواهد داشت و جز سیستم های هوش مصنوعی محسوب نمی شود.

در بسیاری از پروژه‌های هوش مصنوعی، کارت گرافیک اهمیت بیشتری نسبت به پردازنده دارد. فناوری CUDA در کارت‌های گرافیک انویدیا باعث شده بیشتر فریم‌ورک‌های محبوب مانند TensorFlow و PyTorch عملکرد بهتری روی GPU داشته باشند. به همین دلیل هنگام خرید سیستم برای هوش مصنوعی باید ابتدا نوع استفاده خود را مشخص کنید.

اگر هدف شما اجرای مدل‌های آماده مانند ChatGPT Local، Stable Diffusion یا ابزارهای تولید تصویر باشد، به یک کارت گرافیک قدرتمند نیاز خواهید داشت. اما اگر قصد آموزش مدل‌های پیچیده را دارید، باید علاوه بر GPU، روی پردازنده، حافظه رم و فضای ذخیره‌سازی نیز سرمایه‌گذاری کنید.

نکته مهم دیگر این است که سیستم مناسب هوش مصنوعی باید قابلیت ارتقا داشته باشد. بسیاری از کاربران پس از چند ماه استفاده متوجه می‌شوند که به رم بیشتر یا کارت گرافیک قوی‌تر نیاز دارند. بنابراین انتخاب مادربرد و پاور مناسب از همان ابتدا اهمیت زیادی دارد.

خرید سیستم برای هوش مصنوعی

خرید سیستم برای هوش مصنوعی؛ انتخاب پردازنده مناسب

یکی از مهم‌ترین مراحل خرید سیستم برای هوش مصنوعی انتخاب CPU مناسب است. اگرچه بیشتر بار پردازشی پروژه‌های AI روی کارت گرافیک قرار می‌گیرد، اما پردازنده همچنان نقش مهمی در مدیریت داده‌ها، پیش‌پردازش اطلاعات و اجرای همزمان برنامه‌ها دارد.

در حال حاضر پردازنده‌های Intel Core i7، Intel Core i9 و سری Intel Xeon گزینه‌های محبوبی محسوب می‌شوند. از طرف دیگر پردازنده‌های AMD Ryzen 7، Ryzen 9 و Threadripper نیز عملکرد بسیار خوبی در پردازش‌های سنگین ارائه می‌کنند.

برای کاربران مبتدی که قصد یادگیری هوش مصنوعی را دارند، یک پردازنده ۸ هسته‌ای مدرن معمولاً کافی است. اما برای توسعه‌دهندگان حرفه‌ای و افرادی که روی دیتاست‌های بزرگ کار می‌کنند، پردازنده‌های ۱۲ تا ۲۴ هسته‌ای می‌توانند سرعت پردازش را به شکل محسوسی افزایش دهند.

هنگام انتخاب CPU به فرکانس کاری نیز توجه کنید. بسیاری از نرم‌افزارها علاوه بر تعداد هسته‌ها، از سرعت پردازنده نیز بهره می‌برند. به همین دلیل انتخاب یک پردازنده متعادل معمولاً نتیجه بهتری نسبت به خرید مدل‌های بسیار گران‌قیمت خواهد داشت.

در مجموع اگر بودجه محدودی دارید بهتر است بخش بیشتری از هزینه را به کارت گرافیک اختصاص دهید و یک پردازنده میان‌رده قدرتمند انتخاب کنید. این استراتژی در اغلب پروژه‌های AI بازده بیشتری دارد.

اهمیت کارت گرافیک و حافظه VRAM در خرید سیستم برای هوش مصنوعی

وقتی صحبت از خرید سیستم برای هوش مصنوعی می‌شود، کارت گرافیک مهم‌ترین قطعه سیستم است. بخش عمده عملیات آموزش و اجرای مدل‌های یادگیری عمیق توسط GPU انجام می‌شود و هرچه قدرت کارت گرافیک بیشتر باشد، سرعت پردازش نیز افزایش پیدا می‌کند.

در حال حاضر کارت‌های گرافیک NVIDIA به دلیل پشتیبانی گسترده از CUDA و Tensor Cores بهترین گزینه برای پروژه‌های هوش مصنوعی محسوب می‌شوند. مدل‌هایی مانند RTX 4060، RTX 4070، RTX 4080 و RTX 4090 در بین کاربران محبوبیت زیادی دارند.

خرید سیستم برای هوش مصنوعی

علاوه بر قدرت پردازشی، میزان حافظه VRAM نیز اهمیت بسیار بالایی دارد. بسیاری از مدل‌های زبانی و ابزارهای تولید تصویر برای اجرا به حافظه گرافیکی زیادی نیاز دارند. برای شروع کار با هوش مصنوعی حداقل ۸ گیگابایت VRAM توصیه می‌شود، اما برای اجرای مدل‌های پیشرفته بهتر است به سراغ کارت‌هایی با ۱۲ تا ۲۴ گیگابایت حافظه بروید.

اگر هدف شما تولید تصاویر با Stable Diffusion، آموزش مدل‌های سفارشی یا اجرای مدل‌های متن‌باز بزرگ باشد، انتخاب کارت گرافیک مناسب می‌تواند تفاوت چشمگیری در تجربه کاربری ایجاد کند. به همین دلیل کارشناسان معمولاً توصیه می‌کنند هنگام خرید سیستم برای هوش مصنوعی بیشترین تمرکز روی GPU باشد.

همچنین توجه داشته باشید که کارت گرافیک قدرتمند به پاور مناسب و سیستم خنک‌کننده کارآمد نیاز دارد. نادیده گرفتن این موضوع می‌تواند باعث کاهش عملکرد یا افزایش دمای سیستم شود.

برای خرید سیستم برای هوش مصنوعی چه مقدار رم و حافظه ذخیره‌سازی نیاز داریم؟

یکی دیگر از عوامل مهم در خرید سیستم برای هوش مصنوعی میزان حافظه RAM است. بسیاری از کاربران تصور می‌کنند تنها کارت گرافیک اهمیت دارد، اما کمبود رم می‌تواند باعث ایجاد گلوگاه در عملکرد سیستم شود.

خرید سیستم برای هوش مصنوعی

برای پروژه‌های آموزشی و یادگیری ماشین سبک، ۱۶ گیگابایت رم حداقل مقدار قابل قبول محسوب می‌شود. با این حال اگر قصد اجرای چند برنامه همزمان یا کار روی دیتاست‌های بزرگ را دارید، ۳۲ گیگابایت رم انتخاب مناسب‌تری خواهد بود.

کاربران حرفه‌ای و پژوهشگران حوزه هوش مصنوعی معمولاً از ۶۴ گیگابایت رم یا بیشتر استفاده می‌کنند. این میزان حافظه امکان پردازش حجم بالایی از داده‌ها را فراهم می‌کند و عملکرد سیستم را در پروژه‌های سنگین بهبود می‌بخشد.

در بخش ذخیره‌سازی نیز استفاده از SSDهای NVMe اهمیت زیادی دارد. سرعت بالای این حافظه‌ها باعث کاهش زمان بارگذاری داده‌ها و اجرای سریع‌تر نرم‌افزارها می‌شود. حداقل ظرفیت پیشنهادی برای یک سیستم هوش مصنوعی ۵۱۲ گیگابایت SSD است، اما برای استفاده حرفه‌ای بهتر است از یک ترابایت یا بیشتر استفاده کنید.

بسیاری از کاربران حرفه‌ای ترکیبی از SSD و HDD را انتخاب می‌کنند. در این حالت سیستم‌عامل و نرم‌افزارها روی SSD نصب می‌شوند و داده‌های حجیم روی هارددیسک ذخیره خواهند شد.

بهترین پیشنهادها برای خرید سیستم برای هوش مصنوعی در بودجه‌های مختلف

اگر بودجه محدودی دارید، ترکیب Ryzen 7 یا Core i7 به همراه RTX 4060 و ۱۶ گیگابایت رم می‌تواند نقطه شروع مناسبی باشد.

در رده میان‌رده، استفاده از Core i7 نسل جدید یا Ryzen 9 همراه با RTX 4070 و ۳۲ گیگابایت رم عملکرد بسیار خوبی ارائه می‌دهد و برای اکثر پروژه‌های AI کافی است.

برای کاربران حرفه‌ای، ورک‌استیشن‌هایی با پردازنده‌های قدرتمند، ۶۴ گیگابایت رم و کارت‌های RTX 4080 یا RTX 4090 انتخاب ایده‌آلی خواهند بود. این سیستم‌ها توانایی اجرای مدل‌های سنگین و پردازش‌های پیچیده را دارند.

در هنگام انتخاب قطعات، آینده‌نگری را فراموش نکنید. خرید سیستمی که امکان ارتقای رم، ذخیره‌سازی و کارت گرافیک را داشته باشد، در بلندمدت هزینه‌های شما را کاهش می‌دهد.

سخن آخر

خرید سیستم برای هوش مصنوعی نیازمند بررسی دقیق قطعات سخت‌افزاری و شناخت نیازهای واقعی کاربر است. انتخاب پردازنده مناسب، کارت گرافیک قدرتمند، حافظه رم کافی و ذخیره‌سازی پرسرعت می‌تواند تجربه کار با ابزارهای AI را به شکل چشمگیری بهبود دهد. اگر قصد دارید در زمینه یادگیری ماشین، پردازش زبان طبیعی یا تولید محتوای مبتنی بر هوش مصنوعی فعالیت کنید، بهتر است از همان ابتدا سیستمی انتخاب کنید که علاوه بر عملکرد مناسب، قابلیت ارتقا نیز داشته باشد. با رعایت این نکات می‌توانید مطمئن باشید که سرمایه‌گذاری شما برای سال‌ها پاسخگوی نیازهای حوزه هوش مصنوعی خواهد بود.

هوش مصنوعی Claude

هوش مصنوعی Claude؛ رقیب قدرتمند ChatGPT در دنیای هوش مصنوعی

هوش مصنوعی Claude یکی از پیشرفته‌ترین مدل‌های زبانی جهان است که در سال‌های اخیر توجه کاربران، توسعه‌دهندگان و کسب‌وکارهای زیادی را به خود جلب کرده است. با رشد سریع فناوری هوش مصنوعی، ابزارهای متعددی برای تولید محتوا، برنامه‌نویسی، تحلیل داده و پاسخ‌گویی به سوالات کاربران معرفی شده‌اند، اما در میان آن‌ها Claude توانسته جایگاه ویژه‌ای به دست آورد. این مدل توسط شرکت Anthropic توسعه یافته و با تمرکز بر ایمنی، دقت و تعامل طبیعی با انسان طراحی شده است.

در دنیایی که ابزارهای هوش مصنوعی هر روز قدرتمندتر می‌شوند، شناخت قابلیت‌ها و مزایای مدل‌های مختلف اهمیت زیادی دارد. بسیاری از کاربران هنگام انتخاب یک دستیار هوشمند، بین گزینه‌هایی مانند ChatGPT، Gemini و هوش مصنوعی Claude مردد هستند. به همین دلیل آشنایی کامل با ویژگی‌ها، کاربردها و تفاوت‌های این ابزار می‌تواند به تصمیم‌گیری بهتر کمک کند.

هوش مصنوعی Claude چیست؟

هوش مصنوعی Claude یک مدل زبانی پیشرفته (LLM) است که توسط شرکت Anthropic توسعه داده شده است. Anthropic در سال 2021 توسط گروهی از پژوهشگران سابق OpenAI تأسیس شد و از همان ابتدا تمرکز خود را بر توسعه هوش مصنوعی ایمن و قابل اعتماد قرار داد.

نام Claude از «Claude Shannon» پدر نظریه اطلاعات الهام گرفته شده است. هدف اصلی از طراحی این مدل، ایجاد یک دستیار هوشمند است که بتواند به شکل طبیعی با انسان ارتباط برقرار کند، اطلاعات را تحلیل کند و در عین حال از تولید پاسخ‌های خطرناک یا گمراه‌کننده تا حد امکان جلوگیری کند.

هوش مصنوعی Claude

یکی از ویژگی‌های مهم Claude توانایی درک متن‌های طولانی است. این قابلیت باعث می‌شود کاربران بتوانند اسناد بزرگ، گزارش‌ها، کتاب‌ها یا داده‌های حجیم را در اختیار مدل قرار دهند و تحلیل‌های دقیق‌تری دریافت کنند. همین موضوع باعث شده است که بسیاری از کسب‌وکارها و تیم‌های تحقیقاتی به استفاده از آن علاقه‌مند شوند.

علاوه بر این، هوش مصنوعی Claude توانایی بالایی در خلاصه‌سازی متون، تولید محتوا، ترجمه، کدنویسی و تحلیل داده دارد. این ویژگی‌ها باعث شده‌اند که Claude تنها یک چت‌بات ساده نباشد و به ابزاری حرفه‌ای برای انجام طیف گسترده‌ای از وظایف تبدیل شود.

ویژگی‌های مهم هوش مصنوعی Claude

یکی از دلایل محبوبیت هوش مصنوعی Claude مجموعه قابلیت‌های پیشرفته‌ای است که در اختیار کاربران قرار می‌دهد. این قابلیت‌ها نه تنها تجربه کاربری را بهبود می‌بخشند، بلکه باعث افزایش بهره‌وری در بسیاری از حوزه‌های کاری می‌شوند.

نخستین ویژگی مهم Claude، درک عمیق زبان طبیعی است. این مدل می‌تواند سوالات پیچیده را تحلیل کند و پاسخ‌هایی روان، دقیق و نزدیک به گفت‌وگوی انسانی ارائه دهد. به همین دلیل بسیاری از کاربران هنگام تعامل با Claude احساس می‌کنند با یک دستیار واقعی در حال گفت‌وگو هستند.

ویژگی مهم دیگر، توانایی پردازش حجم بالایی از اطلاعات است. Claude می‌تواند هزاران کلمه متن را در یک مکالمه بررسی کند و ارتباط میان بخش‌های مختلف اطلاعات را تشخیص دهد. این قابلیت برای تحلیل قراردادها، گزارش‌های مالی، مقالات علمی و مستندات فنی بسیار ارزشمند است.

از دیگر ویژگی‌های قابل توجه می‌توان به موارد زیر اشاره کرد:

  • تولید محتوای متنی با کیفیت بالا
  • کمک به برنامه‌نویسی و رفع خطاهای کد
  • خلاصه‌سازی اسناد طولانی
  • پاسخ‌گویی به سوالات تخصصی
  • تحلیل داده‌های متنی
  • ترجمه و بازنویسی محتوا
  • رعایت استانداردهای ایمنی در پاسخ‌ها

همچنین شرکت Anthropic به صورت مداوم مدل‌های جدیدی از Claude را منتشر می‌کند و عملکرد آن را بهبود می‌دهد تا کاربران بتوانند تجربه‌ای بهتر و دقیق‌تر داشته باشند.

مزایای استفاده از هوش مصنوعی Claude

استفاده از هوش مصنوعی Claude مزایای متعددی برای کاربران عادی و حرفه‌ای به همراه دارد. یکی از مهم‌ترین مزایا، صرفه‌جویی در زمان است. بسیاری از کارهایی که قبلاً ساعت‌ها زمان نیاز داشتند، اکنون در چند دقیقه انجام می‌شوند.

برای مثال تولید محتوای متنی، تهیه گزارش، خلاصه‌سازی مقالات یا تحلیل اسناد طولانی با کمک Claude بسیار سریع‌تر از گذشته انجام می‌شود. این موضوع برای تولیدکنندگان محتوا، دانشجویان، مدیران و کارشناسان کسب‌وکار اهمیت زیادی دارد.

هوش مصنوعی Claude

مزیت دیگر Claude، دقت بالا در درک مفاهیم است. این مدل تلاش می‌کند پاسخ‌هایی منسجم و مرتبط با سوال کاربر ارائه دهد. در بسیاری از موارد نیز می‌تواند اطلاعات پیچیده را به زبان ساده توضیح دهد.

از طرف دیگر، Claude برای محیط‌های سازمانی گزینه جذابی محسوب می‌شود. بسیاری از شرکت‌ها از این ابزار برای افزایش بهره‌وری کارکنان، خودکارسازی فرایندها و بهبود خدمات مشتریان استفاده می‌کنند.

مهم‌ترین مزایای Claude عبارت‌اند از:

  • افزایش سرعت انجام کارها
  • کاهش هزینه‌های عملیاتی
  • بهبود کیفیت تولید محتوا
  • کمک به تصمیم‌گیری بهتر
  • تحلیل سریع اطلاعات
  • افزایش بهره‌وری تیم‌ها
  • ارائه پاسخ‌های قابل فهم و دقیق

به همین دلیل بسیاری از متخصصان معتقدند که Claude می‌تواند نقش مهمی در تحول دیجیتال کسب‌وکارها ایفا کند.

مقایسه هوش مصنوعی Claude با ChatGPT

یکی از سوالات رایج کاربران این است که هوش مصنوعی Claude بهتر است یا ChatGPT؟ پاسخ این سوال به نوع نیاز کاربر بستگی دارد، زیرا هر دو ابزار نقاط قوت خاص خود را دارند.

ChatGPT که توسط شرکت OpenAI توسعه یافته، به دلیل محبوبیت جهانی و اکوسیستم گسترده خود شناخته می‌شود. در مقابل Claude تمرکز ویژه‌ای بر ایمنی، تحلیل متون طولانی و پاسخ‌های محتاطانه دارد.

در زمینه تحلیل اسناد بزرگ، Claude عملکرد بسیار خوبی از خود نشان داده است. بسیاری از کاربران حرفه‌ای برای بررسی قراردادها، فایل‌های تحقیقاتی و گزارش‌های چندصد صفحه‌ای از آن استفاده می‌کنند.

از سوی دیگر ChatGPT در بسیاری از حوزه‌ها مانند تولید محتوا، برنامه‌نویسی، استفاده از ابزارهای جانبی و یکپارچگی با سرویس‌های مختلف عملکرد بسیار قدرتمندی دارد.

به طور کلی می‌توان گفت:

  • Claude در تحلیل متن‌های طولانی بسیار قدرتمند است.
  • Claude تمرکز زیادی بر ایمنی پاسخ‌ها دارد.
  • ChatGPT اکوسیستم گسترده‌تر و امکانات بیشتری ارائه می‌دهد.
  • هر دو مدل در تولید محتوا و پاسخ‌گویی عملکرد بسیار خوبی دارند.

در نهایت انتخاب میان این دو ابزار به نیازها، بودجه و نوع استفاده کاربران بستگی خواهد داشت.

کاربردهای هوش مصنوعی Claude در کسب‌وکارها

امروزه هوش مصنوعی Claude در صنایع مختلف مورد استفاده قرار می‌گیرد. شرکت‌ها از این فناوری برای بهبود عملکرد، کاهش هزینه‌ها و افزایش سرعت انجام فرایندها بهره می‌برند.

در حوزه خدمات مشتریان، Claude می‌تواند به عنوان دستیار هوشمند عمل کند و به سوالات مشتریان پاسخ دهد. این موضوع باعث کاهش حجم کاری تیم پشتیبانی می‌شود.

هوش مصنوعی Claude

در بخش تولید محتوا نیز کسب‌وکارها از Claude برای نگارش مقالات، توضیحات محصولات، ایمیل‌های بازاریابی و گزارش‌های تخصصی استفاده می‌کنند. علاوه بر این، تیم‌های حقوقی می‌توانند از آن برای بررسی قراردادها و استخراج نکات مهم بهره ببرند.

در حوزه فناوری اطلاعات نیز Claude به توسعه‌دهندگان کمک می‌کند تا کدها را بررسی کرده، خطاها را شناسایی کنند و راهکارهای بهتری ارائه دهند.

برخی از مهم‌ترین کاربردهای Claude عبارت‌اند از:

  • تولید و مدیریت محتوا
  • پشتیبانی مشتریان
  • تحلیل اسناد حقوقی
  • برنامه‌نویسی و توسعه نرم‌افزار
  • آموزش و یادگیری
  • تحلیل داده‌های متنی
  • مدیریت دانش سازمانی

با توجه به این کاربردهای گسترده، انتظار می‌رود استفاده از Claude در سال‌های آینده رشد بیشتری داشته باشد.

آینده هوش مصنوعی Claude

روند پیشرفت هوش مصنوعی نشان می‌دهد که مدل‌های زبانی بزرگ در آینده نقش پررنگ‌تری در زندگی روزمره و محیط‌های کاری خواهند داشت. هوش مصنوعی Claude نیز از این قاعده مستثنا نیست و شرکت Anthropic سرمایه‌گذاری گسترده‌ای برای توسعه آن انجام داده است.

نسخه‌های جدید Claude از نظر دقت، سرعت و توانایی تحلیل اطلاعات بهبود یافته‌اند. همچنین انتظار می‌رود قابلیت‌های چندرسانه‌ای و پردازش داده‌های پیچیده‌تر نیز به این مدل اضافه شوند.

بسیاری از کارشناسان معتقدند که در آینده، Claude می‌تواند به یکی از اصلی‌ترین ابزارهای هوش مصنوعی برای سازمان‌ها، دانشگاه‌ها و کاربران حرفه‌ای تبدیل شود. افزایش قابلیت‌های امنیتی و توسعه مدل‌های پیشرفته‌تر نیز به رشد جایگاه این فناوری کمک خواهد کرد.

سخن آخر

هوش مصنوعی Claude یکی از مهم‌ترین و پیشرفته‌ترین ابزارهای هوش مصنوعی حال حاضر جهان محسوب می‌شود که توسط شرکت Anthropic توسعه یافته است. این مدل با تمرکز بر ایمنی، دقت و توانایی تحلیل متون طولانی توانسته توجه کاربران زیادی را به خود جلب کند. قابلیت‌هایی مانند تولید محتوا، خلاصه‌سازی اسناد، برنامه‌نویسی و تحلیل داده‌ها باعث شده‌اند که Claude به ابزاری کاربردی برای افراد و کسب‌وکارها تبدیل شود. اگر به دنبال یک دستیار هوشمند قدرتمند و قابل اعتماد هستید، هوش مصنوعی Claude بدون شک یکی از گزینه‌هایی است که ارزش بررسی و استفاده را دارد.

ممیز شناور FPU

Floating Point Performance چیست؟


در دنیای محاسبات دیجیتال، پردازش اعداد یکی از بنیادی‌ترین وظایف هر سامانه رایانه‌ای به شمار می‌رود. اما همه اعداد به یک شکل پردازش نمی‌شوند. اعداد صحیح با اعداد اعشاری تفاوت بنیادین دارند و این تفاوت در نحوه ذخیره‌سازی و محاسبه آن‌ها تأثیر مستقیم می‌گذارد. اصطلاح «عملکرد ممیز شناور» یا «Floating Point Performance» به توانایی یک پردازنده یا سامانه محاسباتی در انجام عملیات ریاضی روی اعداد اعشاری با دقت بالا اشاره دارد.

این عملیات شامل جمع، تفریق، ضرب، تقسیم و همچنین توابع پیچیده‌تر مانند توان، ریشه، لگاریتم و عملیات مثلثاتی می‌شود. درک این مفهوم برای متخصصان علوم کامپیوتر، مهندسان، پژوهشگران حوزه سیستم های هوش مصنوعی، گرافیک رایانه‌ای، شبیه‌سازی‌های علمی و بسیاری از رشته‌های دیگر ضروری است.

تعریف ممیز شناور FPU

برای درک عملکرد ممیز شناور، ابتدا باید بدانیم ممیز شناور چیست. ممیز شناور روشی برای نمایش اعداد حقیقی در حافظه کامپیوتر است. در این روش، یک عدد به سه بخش علامت، نما و مانتیس (قسمت کسری) تقسیم می‌شود. فرمول کلی به صورت (۱)⁺ᵗ × مانتیس × ۲^(نما) نوشته می‌شود. این روش امکان نمایش طیف بسیار وسیعی از اعداد، از اعداد بسیار کوچک تا بسیار بزرگ را با دقت نسبتاً ثابت فراهم می‌کند. استاندارد رایج برای این کار، استاندارد IEEE ۷۵۴ است که دو نوع اصلی دارد: دقت تکی (۳۲ بیتی) و دقت دوگانه (۶۴ بیتی).

ممیز شناور FPU

در دقت تکی، ۲۳ بیت برای مانتیس، ۸ بیت برای نما و یک بیت برای علامت اختصاص می‌یابد. در دقت دوگانه، ۵۲ بیت مانتیس، ۱۱ بیت نما و یک بیت علامت دارد. عملکرد ممیز شناور به سرعت و صحت انجام محاسبات روی این اعداد در واحد پردازش مرکزی یا واحد پردازش گرافیکی گفته می‌شود.

اهمیت عملکرد ممیز شناور FPU

عملکرد ممیز شناور یکی از شاخص‌های کلیدی در ارزیابی قدرت محاسباتی پردازنده‌ها به شمار می‌رود. دلیل این اهمیت آن است که بسیاری از مسائل علمی و مهندسی ذاتاً با اعداد حقیقی سروکار دارند. برای نمونه، شبیه‌سازی وضعیت آب و هوا، محاسبات دینامیک سیالات، تحلیل تنش در سازه‌های مهندسی، مدلسازی میدان‌های الکترومغناطیسی، پردازش سیگنال‌های دیجیتال، و حتی الگوریتم‌های یادگیری ماشین و شبکه‌های عصبی عمیق همه و همه به میزان زیادی به عملیات ممیز شناور وابسته هستند. در واقع، در دهه‌های اخیر، نیاز به پردازش سریع اعداد اعشاری به قدری افزایش یافته است که شرکت‌های سازنده پردازنده، واحدهای مجزایی به نام FPU (واحد ممیز شناور) را درون پردازنده‌های خود تعبیه کرده‌اند. بدون وجود چنین واحدهایی، انجام محاسبات اعشاری به روش نرم‌افزاری بسیار کند و غیرعملی خواهد بود. بنابراین، بهبود عملکرد ممیز شناور به طور مستقیم موجب افزایش سرعت اجرای برنامه‌های علمی و مهندسی می‌شود.

عوامل مؤثر بر عملکرد ممیز شناور FPU

عملکرد ممیز شناور تحت تأثیر عوامل متعددی قرار دارد. اولین و مهم‌ترین عامل، معماری خود پردازنده است. تعداد واحدهای FPU، پهنای باند حافظه، میزان حافظه نهان (کش) و فناوری ساخت ترانزیستورها نقش تعیین‌کننده‌ای دارند.

برای نمونه، پردازنده‌های مدرن ممکن است دارای چندین واحد SIMD (دستورالعمل مجرد چند داده) مانند AVX در پردازنده‌های اینتل یا SVE در معماری آرم باشند که قادرند در یک چرخه ساعت چندین عملیات ممیز شناور را به صورت موازی انجام دهند.

عامل دوم، نوع داده و دقت مورد نیاز است. محاسبات با دقت دوگانه به طور معمول دو برابر محاسبات با دقت تکی زمان می‌برند، هرچند که در برخی پردازنده‌های ویژه این تفاوت کمتر شده است.

عامل سوم، الگوی دسترسی به حافظه است. اگر داده‌ها در حافظه نهان قرار داشته باشند، سرعت محاسبات بسیار بیشتر از حالتی است که داده‌ها باید از حافظه اصلی یا حافظه مجازی بازیابی شوند.

عامل چهارم، وجود دستورالعمل‌های خاص مانند FMA (ضرب و جمع توأم) است که دو عملیات را در یک دستورالعمل انجام می‌دهد و هم سرعت را افزایش می‌دهد و هم خطای گردکردن را کاهش می‌دهد.

تفاوت عملکرد ممیز شناور FPU با عملکرد اعداد صحیح

درک تفاوت میان محاسبات ممیز شناور و محاسبات اعداد صحیح برای تحلیل عملکرد سیستم ضروری است. اعداد صحیح به صورت دقیق و بدون خطا در حافظه نمایش داده می‌شوند و عملیات روی آن‌ها مانند جمع و ضرب معمولاً در یک یا دو چرخه ساعت انجام می‌گیرد. در مقابل، اعداد ممیز شناور به دلیل ماهیت تقریبی خود، همواره با خطای گردکردن همراه هستند و عملیات روی آن‌ها به مراحل بیشتری نیاز دارد.

ممیز شناور FPU

برای مثال، جمع دو عدد ممیز شناور نیازمند همترازسازی نماها، جمع مانتیس‌ها و سپس نرمالسازی نتیجه است که ممکن است چندین چرخه ساعت طول بکشد. همچنین، تقسیم ممیز شناور یا محاسبه توابع مثلثاتی بسیار پرهزینه‌تر از عملیات ساده روی اعداد صحیح است. به همین دلیل، در پردازنده‌های همه منظوره، عملکرد ممیز شناور همواره پایین‌تر از عملکرد اعداد صحیح است.

با این حال، در پردازنده‌های تخصصی مانند واحدهای پردازش گرافیکی (GPU) که برای گرافیک و محاسبات علمی طراحی شده‌اند، تعداد بسیار زیاد واحدهای FPU موازی می‌تواند عملکرد ممیز شناور بسیار بالایی ارائه دهد، حتی بالاتر از عملکرد عدد صحیح در همان تراشه.

کاربردهای عملی عملکرد ممیز شناور FPU

برای درک بهتر اهمیت این مفهوم، برخی از مهم‌ترین کاربردهای عملی را مرور می‌کنیم. در هوش مصنوعی و یادگیری عمیق، هزاران میلیارد عملیات ممیز شناور برای آموزش یک مدل بزرگ مورد نیاز است.

به همین دلیل، تراشه‌های تخصصی مانند TPU گوگل و پردازنده‌های گرافیکی انویدیا به طور خاص برای بهینه‌سازی عملکرد ممیز شناور (اغلب با دقت کمتر مانند ۱۶ بیتی) طراحی شده‌اند. در گرافیک رایانه‌ای، هر پیکسل روی صفحه نمایش نیازمند محاسبات ممیز شناور برای تعیین رنگ، روشنایی، سایه و بافت است.

بازی‌های رایانه‌ای مدرن و نرم‌افزارهای شبیه‌سازی سه بعدی به میلیون‌ها عملیات ممیز شناور در هر فریم نیاز دارند. در علوم و مهندسی، شبیه‌سازی‌های عددی مانند پیش‌بینی وضعیت هوا، شبیه‌سازی جریان هوا بر روی بال هواپیما، مدلسازی راکتورهای هسته‌ای و تحلیل دینامیک مولکولی همگی به شدت به کارایی ممیز شناور وابسته هستند.

همچنین در مالی و اقتصاد محاسباتی، مدلسازی ریسک، قیمت‌گذاری اختیار معامله و تحلیل سری‌های زمانی نیازمند محاسبات اعشاری سریع و دقیق است.

روش‌های اندازه‌گیری عملکرد ممیز شناور FPU

برای ارزیابی و مقایسه عملکرد ممیز شناور در سامانه‌های مختلف، معیارها و بنچمارک‌های استانداردی وجود دارد. واحد اصلی سنجش، FLOPS (عملیات ممیز شناور در ثانیه) است.

ممیز شناور FPU

این واحد می‌تواند با پیشوندهای کیلو، مگا، گیگا، ترا، پتا و اکسا بیان شود. برای نمونه، یک ابررایانه مدرن ممکن است چندین اگزافلاپس عملکرد داشته باشد. بنچمارک LINPACK که برای رتبه‌بندی ابررایانه‌ها در فهرست TOP۵۰۰ استفاده می‌شود، عملکرد ممیز شناور را در حل دستگاه معادلات خطی اندازه‌گیری می‌کند.

بنچمارک‌های دیگری مانند SPECfp، Geekbench و PolyBench نیز معیارهای شناخته شده‌ای هستند. همچنین توسعه‌دهندگان نرم‌افزار می‌توانند با استفاده از ابزارهایی مانند Perf در لینوکس، VTune از اینتل یا ابزارهای ردیابی مانند Nsight برای پردازنده‌های گرافیکی، عملکرد بخش‌های مختلف کد خود را بررسی کنند. اندازه‌گیری دقیق نیازمند تکرار آزمایش‌ها و در نظر گرفتن عواملی مانند دمای پردازنده، فرکانس پویا و تداخل سایر فرایندها است.

روش‌های بهینه‌سازی و افزایش عملکرد ممیز شناور FPU

برای بهبود عملکرد ممیز شناور در یک برنامه خاص، راهکارهای گوناگونی وجود دارد. اولین راهکار، بهره‌گیری از موازی‌سازی در سطح داده با استفاده از دستورالعمل‌های SIMD است.

اگر کامپایلر به صورت خودکار نتواند کد را بهینه کند، برنامه‌نویس می‌تواند به صورت دستی از توابع داخلی یا اینترینسیک‌ها استفاده کند. راهکار دوم، کاهش تبدیل‌های غیرضروری میان انواع داده‌های صحیح و اعشاری است، زیرا هر تبدیل هزینه اضافی دارد.

راه حل سوم، استفاده از الگوریتم‌هایی با پایداری عددی بهتر است که به دقت کمتری نیاز دارند و در نتیجه خطای گردکردن را کاهش داده و گاهی باعث افزایش سرعت می‌شوند. راهکار چهارم، بهبود محلی بودن ارجاعات حافظه است تا داده‌ها تا حد امکان در حافظه نهان باقی بمانند.

راهکار پنجم، جایگزین کردن عملیات پرهزینه مانند تقسیم با عملیات ارزان‌تر مانند ضرب در معکوس عدد (در صورت وجود دقت کافی) است. همچنین، در برخی کاربردها می‌توان از دقت کمتر (مثلاً ۱۶ بیتی به جای ۳۲ بیتی) استفاده کرد که هم سرعت را افزایش می‌دهد و هم مصرف انرژی را کاهش می‌دهد.

نتیجه گیری

عملکرد ممیز شناور یکی از جنبه‌های حیاتی محاسبات مدرن است که مستقیماً بر سرعت و کارایی برنامه‌های علمی، مهندسی، گرافیکی و هوش مصنوعی تأثیر می‌گذارد. این مفهوم به توانایی پردازنده در انجام عملیات ریاضی روی اعداد اعشاری با رعایت استانداردهایی مانند IEEE ۷۵۴ اشاره دارد.

عواملی مانند معماری پردازنده، دقت داده‌ها، الگوی دسترسی به حافظه و وجود دستورالعمل‌های تخصصی همگی بر این عملکرد اثر می‌گذارند. اندازه‌گیری آن با واحد FLOPS و بنچمارک‌های استانداردی مانند LINPACK انجام می‌شود.

با توجه به رشد روزافزون نیاز به محاسبات سنگین در حوزه‌هایی مانند یادگیری عمیق، شبیه‌سازی‌های پیچیده علمی و واقعیت مجازی، بهینه‌سازی و بهبود عملکرد ممیز شناور همچنان یکی از اولویت‌های اصلی طراحان سخت افزار و توسعه‌دهندگان نرم افزار باقی خواهد ماند. درک صحیح این مفهوم به متخصصان کمک می‌کند تا معماری‌های بهتر، الگوریتم‌های کارآمدتر و کدهای سریع‌تری تولید کنند و در نتیجه گام‌های مؤثرتری در پیشبرد مرزهای دانش و فناوری بردارند.

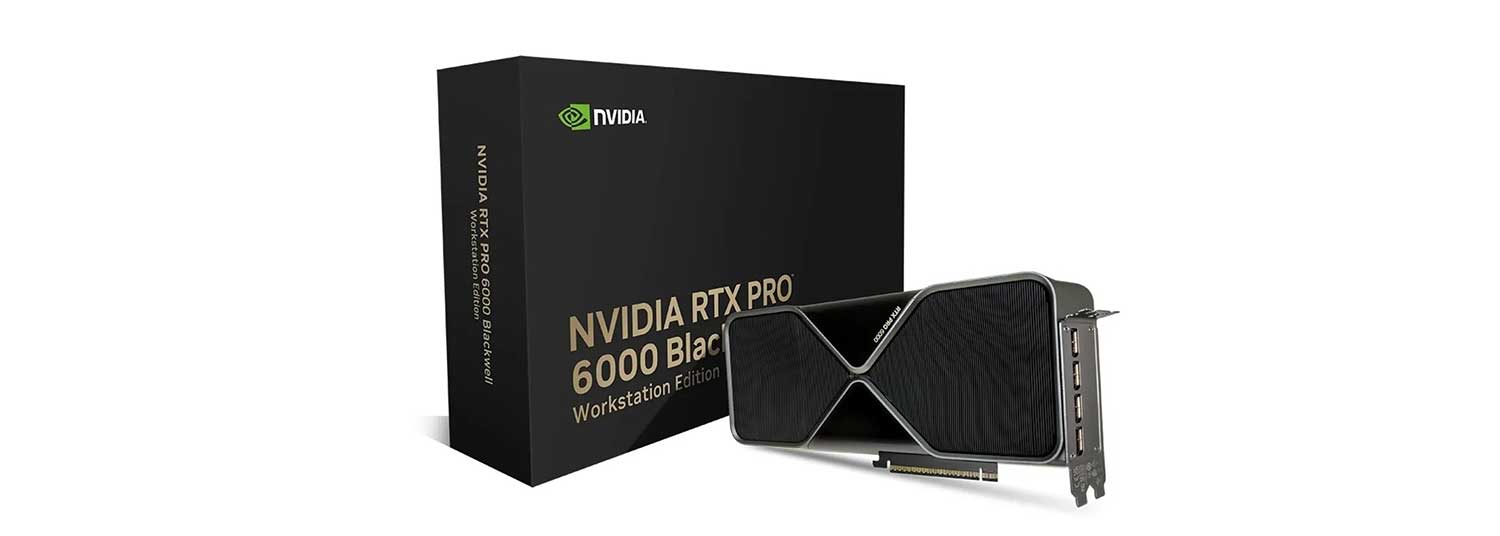
مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

پردازنده‌های گرافیکی امروزی تنها برای اجرای بازی‌های رایانه‌ای طراحی نشده‌اند. این قطعات، نقش اصلی را در پردازش‌های سنگین هوش مصنوعی، رندرینگ سه‌بعدی، شبیه‌سازی‌های علمی و تحلیل داده‌های کلان ایفا می‌کنند.

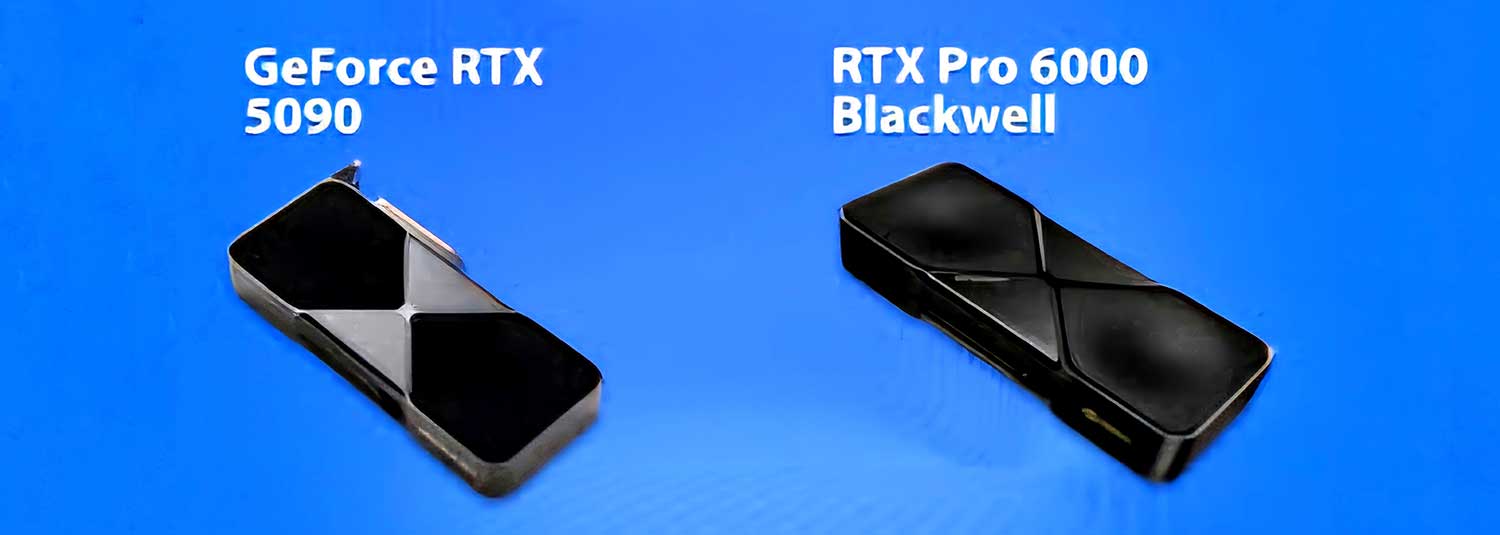
شرکت انویدیا با معرفی معماری جدید خود به نام بلک‌ول (Blackwell)، دو محصول برجسته را روانه بازار کرده است: یکی GeForce RTX 5090 که برای کاربران عادی، گیمرها و تولیدکنندگان محتوای حرفه‌ای طراحی شده، و دیگری RTX 6000 Pro Blackwell که در دسته محصولات ایستگاه‌های کاری حرفه‌ای و سرورهای سازمانی جای می‌گیرد.

بسیاری از خریداران حرفه‌ای تصور می‌کنند که RTX 5090 به دلیل قیمت پایین‌تر، گزینه منطقی‌تری است، اما واقعیت آن است که این دو محصول تفاوت‌های بنیادینی در سخت‌افزار، حافظه، قابلیت‌های محاسباتی و کاربرد نهایی دارند. در ادامه به مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 می پردازیم.

معماری یکسان، اما پیکربندی متفاوت

هر دو کارت گرافیک بر پایه همان تراشه مرکزی یعنی GB202 ساخته شده‌اند که انویدیا آن را برای نسل بلک‌ول طراحی کرده است. با این حال، شرکت انویدیا برای محصولات حرفه‌ایی خود از تمام توان این تراشه استفاده می‌کند، در حالی که در نسخه مصرفی، برخی از واحدهای محاسباتی غیرفعال می‌شوند.

به عبارت دیگر، RTX 6000 Pro Blackwell از همه هسته‌های موجود روی تراشه بهره می‌برد، در حالی که RTX 5090 با تعدادی هسته کمتر عرضه می‌شود. این تفاوت در عمل به معنای برتری محسوس مدل حرفه‌ای در عملیات موازی و محاسبات سنگین است.

اگر به اعداد دقیق توجه کنیم، RTX 6000 Pro Blackwell دارای ۲۴,۰۶۴ هسته کودا (CUDA) است. این هسته‌ها واحدهای اصلی انجام محاسبات ممیز شناور هستند. در سوی مقابل، RTX 5090 به ۲۱,۷۶۰ هسته کودا مجهز شده است. بنابراین مدل حرفه‌ای حدود ۱۰٫۵ درصد هسته بیشتر دارد. همین نسبت در مورد هسته‌های تنسور نسل پنجم و هسته‌های رهگیری پرتو نسل چهارم نیز صادق است. هسته‌های تنسور در RTX 6000 Pro Blackwell تعداد ۷۵۲ واحد و در RTX 5090 تعداد ۶۸۰ واحد است. هسته‌های رهگیری پرتو نیز به ترتیب ۱۸۸ و ۱۷۰ عدد می‌باشند. این اختلاف اگرچه در نگاه اول کوچک به نظر می‌رسد، اما در بارهای کاری حرفه‌ای که روزها یا هفته‌ها طول می‌کشند، تفاوت چشمگیری در زمان اتمام محاسبات ایجاد می‌کند.

تفاوت حیاتی در حافظه گرافیکی (VRAM)

در مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 مهم‌ترین و تعیین‌کننده‌ترین تفاوت میان این دو محصول، مقدار و نوع حافظه گرافیکی است. RTX 5090 به ۳۲ گیگابایت حافظه از نوع GDDR7 مجهز شده است. این مقدار برای اجرای بازی‌های امروزی با وضوح ۴K و حتی ۸K و همچنین برای بسیاری از کارهای حرفه‌ای مانند ویرایش ویدیو یا رندر سه‌بعدی کاملاً مناسب است. اما RTX 6000 Pro Blackwell از ۹۶ گیگابایت حافظه GDDR7 بهره می‌برد. این مقدار دقیقاً سه برابر مدل مصرفی است. افزون بر این، حافظه مدل حرفه‌ای از قابلیت تصحیح خطا (ECC) پشتیبانی می‌کند. قابلیت ECC برای محاسبات علمی و مالی که حتی یک بیت خطا می‌تواند نتیجه نهایی را به کلی تغییر دهد، ضروری است. در حالی که RTX 5090 چنین قابلیتی ندارد.

این تفاوت سه برابری در حافظه، مرز میان «می‌توانم این کار را انجام دهم» و «نمی‌توانم انجام دهم» را تعیین می‌کند. برای مثال، اگر یک مهندس یا پژوهشگر بخواهد یک مدل بزرگ زبانی با ۷۰ میلیارد پارامتر را به صورت محلی اجرا کند، مدلی مانند Llama 3 70B به حدود ۶۰ تا ۷۰ گیگابایت حافظه گرافیکی نیاز دارد. RTX 5090 با ۳۲ گیگابایت حافظه، به هیچ وجه قادر به بارگذاری کامل این مدل نیست و کاربر مجبور است از روش‌های کاهش دقت یا پارتیشن‌بندی مدل روی چند کارت استفاده کند. اما RTX 6000 Pro Blackwell به راحتی این مدل را در خود جای می‌دهد و فضای کافی برای بافرها و داده‌های میانی نیز باقی می‌گذارد. به همین دلیل، در مراکز تحقیقاتی هوش مصنوعی و شرکت‌های بزرگ فناوری، مدل حرفه‌ای تقاضای بسیار بالایی دارد.

پهنای باند حافظه گرافیکی

در مورد پهنای باند حافظه، هر دو کارت از یک نسل حافظه و یک رابط مشابه بهره می‌برند و پهنای باند هر دو به ۱,۷۹۲ گیگابایت بر ثانیه می‌رسد. یعنی سرعت انتقال داده بین حافظه و پردازنده در هر دو کارت یکسان است. اما حجم بیشتر حافظه در RTX 6000 Pro Blackwell اجازه می‌دهد که مجموعه داده‌های بزرگتر بدون نیاز به تبادل مداوم با حافظه اصلی سیستم، درون خود کارت باقی بمانند. این ویژگی به ویژه در یادگیری ماشین و شبیه‌سازی‌های علمی که با دیتاست‌های چند ترابایتی سروکار دارند، بسیار ارزشمند است.

عملکرد محاسباتی و هوش مصنوعی

در حوزه محاسبات ممیز شناور با دقت تکی (FP32) که مبنای بسیاری از الگوریتم‌های علمی و مهندسی است، RTX 6000 Pro Blackwell عملکردی در حدود ۱۲۵ ترافلاپس ارائه می‌دهد. RTX 5090 نیز با حدود ۱۰۵ ترافلاپس، همچنان بسیار قدرتمند است اما از رقیب حرفه‌ای خود عقب می‌ماند. این اختلاف حدود ۱۹ درصدی در کنار اختلاف تعداد هسته‌ها، مدل حرفه‌ای را برای محاسبات سنگین و طولانی مدت مناسب‌تر می‌سازد.

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

اما تفاوت اصلی در محاسبات مرتبط با هوش مصنوعی و به ویژه دقت FP4 پدیدار می‌شود. معماری بلک‌ول قابلیت تازه‌ای به نام FP4 را به هسته‌های تنسور افزوده است. این دقت پایین، امکان پردازش مدل‌های بسیار بزرگ با مصرف حافظه کمتر و سرعت بالاتر را فراهم می‌کند. RTX 5090 در بار FP4 حدود ۸۳۸ ترا عملیات در ثانیه (TOPS) را ثبت می‌کند. این رقم برای بسیاری از برنامه‌های هوش مصنوعی در سطح یک ایستگاه کاری شخصی عالی است. اما RTX 6000 Pro Blackwell به لطف تعداد بیشتر هسته‌های تنسور و حافظه عظیم خود، تا ۴,۰۰۰ ترا عملیات در ثانیه دست می‌یابد. این عدد تقریبا ۴٫۸ برابر مدل مصرفی است. بنابراین هر پژوهشی که با مدل‌های بزرگ زبانی یا شبکه‌های عصبی عمیق سروکار داشته باشد، مدل حرفه‌ای را بسیار برتر خواهد یافت.

مصرف انرژی و خنک‌سازی

مصرف انرژی هر دو کارت بسیار بالاست و این موضوع برای کاربران خانگی و حرفه‌ای به یک اندازه چالش‌برانگیز است. RTX 5090 دارای توان مصرفی حداکثر ۵۷۵ وات است. RTX 6000 Pro Blackwell نیز توان مصرفی حدود ۶۰۰ وات دارد. بنابراین تفاوت محسوسی در مصرف انرژی میان این دو وجود ندارد. با این حال، مدل حرفه‌ای معمولاً با طراحی حرارتی انعطاف‌پذیرتری عرضه می‌شود و می‌توان آن را در محدوده‌ای بین ۴۵۰ تا ۶۰۰ وات پیکربندی کرد. این قابلیت در سرورها که دهها کارت در کنار یکدیگر کار می‌کنند، بسیار حیاتی است. در مقابل، RTX 5090 برای نصب در کیس‌های معمولی و با فن‌های اختصاصی خود طراحی شده و قابلیت کاهش مصرف به آن شکل را ندارد. همچنین خنک‌سازی RTX 6000 Pro Blackwell اغلب از نوع بلوئر (خروج هوا از پشت کارت) است تا هوای گرم مستقیماً از محفظه سرور خارج شود، در حالی که RTX 5090 از فن‌های محوری بزرگ استفاده می‌کند که هوای گرم را درون کیس پخش می‌کنند.

قابلیت‌های ویژه مدیریت و مجازی‌سازی

یکی از ویژگی‌های انحصاری سری RTX PRO، پشتیبانی از فناوری MIG یا Multi-Instance GPU است. این فناوری اجازه می‌دهد تا یک کارت گرافیک فیزیکی به حداکثر چهار کارت مجازی و کاملاً ایزوله تقسیم شود. هر یک از این کارت‌های مجازی حافظه و هسته‌های محاسباتی اختصاصی خود را دارند و می‌توانند به طور همزمان بارهای کاری متفاوتی را اجرا کنند. این ویژگی در دیتاسنترها و محیط‌های ابری که چند کاربر یا چند ماشین مجازی باید از یک کارت گرافیک استفاده کنند، حیاتی است. در RTX 5090 چنین قابلیتی وجود ندارد و کل کارت فقط به یک سیستم میزبان اختصاص دارد. همچنین RTX 6000 Pro Blackwell از درایورهای گواهی‌شده ISV (فروشندگان نرم‌افزارهای مستقل) پشتیبانی می‌کند. این درایورها برای نرم‌افزارهای حرفه‌ای مانند سالیدورکس، اتودسک، انسیمس و کتیا تست شده‌اند و پایداری صد در صدی را تضمین می‌کنند. RTX 5090 از چنین گواهی‌هایی برخوردار نیست و ممکن است در برخی نرم‌افزارهای مهندسی دچار ناپایداری یا عملکرد ضعیف شود.

قیمت و ارزش خرید

هنگام بررسی قیمت، اختلاف بسیار زیادی دیده می‌شود. RTX 5090 که برای بازار مصرف طراحی شده، در زمان عرضه با قیمت پایه ۲,۰۰۰ دلار روانه بازار شد. اما به دلیل افزایش قیمت حافظه‌های GDDR7 و تقاضای بسیار بالا، قیمت واقعی آن در بازار آزاد اکنون بین ۲,۵۰۰ تا ۳,۵۰۰ دلار و گاهی بیشتر نوسان می‌کند. در مقابل، RTX 6000 Pro Blackwell یک محصول حرفه‌ایی است که از کانال‌های توزیع اختصاصی و با قیمتی حدود ۸,۵۰۰ دلار به فروش می‌رسد. این قیمت بیش از دو برابر گران‌ترین قیمت RTX 5090 است. آیا این تفاوت قیمت توجیه‌پذیر است؟ پاسخ بستگی کامل به کاربر دارد. برای یک گیمر یا حتی یک طراح سه‌بعدی که مدل‌های او به بیش از ۳۲ گیگابایت حافظه نیاز ندارند، پرداخت ۵,۰۰۰ دلار اضافه بیهوده است. اما برای یک شرکت فعال در زمینه هوش مصنوعی که مدل ۷۰ میلیارد پارامتری را بارها در روز اجرا می‌کند، نبود حافظه کافی یعنی توقف کار. در چنین شرایطی، ۸,۵۰۰ دلار برای یک کارت که جایگزین چندین کارت کوچک‌تر و پیچیدگی‌های نرم‌افزاری آن می‌شود، هزینه منطقی به شمار می‌رود.

کاربردهای پیشنهادی برای هر کارت

با توجه به تمام موارد گفته شده، می‌توان توصیه‌های روشنی ارائه داد. GeForce RTX 5090 مناسب گروه‌های زیر است:

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

  • گیمرهای حرفه‌ای که به دنبال بالاترین نرخ فریم در بازی‌های جدید با رهگیری پرتو و وضوح ۴K و ۸K هستند.
  • تولیدکنندگان محتوای ویدیویی که با وضوح ۸K و نرم‌افزارهایی مانند پریمیر پرو یا داوینچی ریزالو کار می‌کنند.
  • هنرمندان سه‌بعدی که صحنه‌های پیچیده با حجم بافت بالا رندر می‌کنند اما اندازه پروژه آن‌ها در ۳۲ گیگابایت حافظه جا می‌شود.
  • توسعه‌دهندگان هوش مصنوعی در سطح متوسط که با مدل‌های کوچک تا حدود ۲۰ میلیارد پارامتر کار می‌کنند.

و اما RTX 6000 Pro Blackwell برای گروه‌های زیر طراحی شده است:

مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090

  • پژوهشگران هوش مصنوعی که با مدل‌های بزرگ زبانی با بیش از ۵۰ میلیارد پارامتر به صورت محلی سروکار دارند.
  • مراکز داده و سرورهایی که نیاز به مجازی‌سازی کارت‌های گرافیک با فناوری MIG دارند.
  • مهندسان و دانشمندانی که شبیه‌سازی‌های علمی با مجموعه داده‌های بزرگتر از ۳۲ گیگابایت انجام می‌دهند.
  • شرکت‌هایی که نرم‌افزارهای مهندسی نیازمند گواهی ISV را اجرا می‌کنند و پایداری مطلق برای آن‌ها حیاتی است.
  • هر کاربری که نیاز به حافظه ECC برای جلوگیری از خطاهای محاسباتی دارد.

جمع‌بندی نهایی

در مقایسه کارت گرافیک RTX 6000 Pro Blackwell با RTX 5090 باید گفت هر دو محصولاتی شگفت‌انگیز از نسل بلک‌ول انویدیا هستند. هیچ یک از این دو به طور مطلق از دیگری بهتر نیست.

انتخاب صحیح کاملاً به نیازی بستگی دارد که کاربر دنبال می‌کند. RTX 5090 یک ابرقهرمان در دنیای بازی و تولید محتواست و قیمت مناسبی برای یک کاربر حرفه‌ای منفرد دارد.

RTX 6000 Pro Blackwell یک ابررایانه کوچک بر روی یک برد است که برای بارهای کاری سنگین علمی، مهندسی و تجاری طراحی شده و هزینه بالای آن به دلیل حافظه عظیم، قابلیت ECC، پشتیبانی از مجازی‌سازی و درایورهای معتبر است.

مصرف‌کننده نهایی باید پیش از خرید، دقیقاً محاسبه کند که آیا نرم‌افزارهای مورد استفاده او به بیش از ۳۲ گیگابایت حافظه و قابلیت‌های حرفه‌ای نیاز دارند یا خیر. اگر پاسخ منفی است، RTX 5090 انتخابی هوشمندانه خواهد بود و اگر پاسخ مثبت است، هیچ جایگزینی به جز RTX 6000 Pro Blackwell نمی‌تواند نیاز را برآورده سازد.

در هر صورت، سرمایه‌گذاری روی هر یک از این دو قطعه، تا چندین سال قدرت پردازشی بی‌نظیری را در اختیار کاربر قرار می‌دهد.

فناوری NVLink

معرفی فناوری NVLink شرکت انویدیا

در عصر کنونی که حجم داده‌های تولیدشده روزبه‌روز افزایش می‌یابد و مدل‌های هوش مصنوعی به مرزهای تریلیون‌ها پارامتر نزدیک می‌شوند، زیرساخت‌های محاسباتی سنتی با چالش‌های بنیادین مواجه هستند. یکی از حیاتی‌ترین این چالش‌ها، مسئله ارتباط بین پردازنده‌های گرافیکی یا همان GPUها در سامانه‌های چندپردازنده‌ای است.

فنّاوری NVLink که توسط شرکت انویدیا طراحی و توسعه یافته است، پاسخی نوآورانه به این نیاز رو به رشد محسوب می‌شود.

ضرورت پیدایش NVLink

به‌طور سنتی، ارتباط بین GPUها در یک سرور از طریق گذرگاه استاندارد PCI Express یا همان PCIe انجام می‌شده است. این گذرگاه از ابتدای معرفی خود در اوایل دهه ۲۰۰۰، نقش اصلی را در اتصال دستگاه‌های جانبی به پردازنده مرکزی ایفا کرده است. اگرچه نسل‌های مختلف PCIe بهبودهایی در پهنای باند داشته‌اند، اما این گذرگاه به‌عنوان یک گلوگاه اساسی در سامانه‌های سنگین محاسباتی شناخته می‌شود. برای نمونه، گذرگاه PCIe نسل پنجم حداکثر پهنای باند دوطرفه در حدود ۱۲۸ گیگابایت بر ثانیه ارائه می‌دهد. این میزان برای اجرای مدل‌های پیچیده هوش مصنوعی که نیازمند تبادل لحظه‌ای حجم عظیمی از داده میان ده‌ها یا صدها GPU هستند، کافی نیست. یک مدل زبانی بزرگ با یک تریلیون پارامتر، هنگام آموزش، نیاز دارد که هر میلی‌ثانیه، گرادیان‌ها و به‌روزرسانی‌های وزن میان تمام پردازنده‌ها مبادله شود. در چنین شرایطی، پهنای باند محدود PCIe باعث می‌شود تا بخش قابل توجهی از زمان پردازش به جای محاسبه، صرف انتظار برای انتقال داده گردد.

افزون بر محدودیت پهنای باند، معماری مبتنی بر PCIe نیازمند دخالت پردازنده مرکزی یا CPU در فرآیند انتقال داده است. در این معماری، هنگامی که دو GPU می‌خواهند داده‌ای را مبادله کنند، ابتدا داده باید از حافظه GPU مبدأ به حافظه اصلی سیستم منتقل شود، سپس CPU آن را مسیریابی کرده و در نهایت به GPU مقصد برسد. این فرآیند چندمرحله‌ای باعث افزایش تأخیر یا Latency می‌شود و همچنین بار اضافی قابل توجهی بر روی CPU تحمیل می‌کند. در سامانه‌های بزرگ، CPU که خود مسئولیت مدیریت سیستم عامل و برنامه‌ریزی فرآیندها را بر عهده دارد، نمی‌تواند به طور مؤثر از عهده مدیریت حجم عظیم ترافیک داده میان ده‌ها GPU برآید. به همین دلایل، انویدیا تصمیم به خلق یک رابط اختصاصی و کارآمد برای شبکه‌سازی درون‌راکی یا Scale-up گرفت و NVLink را برای نخستین بار در سال ۲۰۱۶ و همزمان با معماری Pascal معرفی کرد.

مفهوم و معماری NVLink

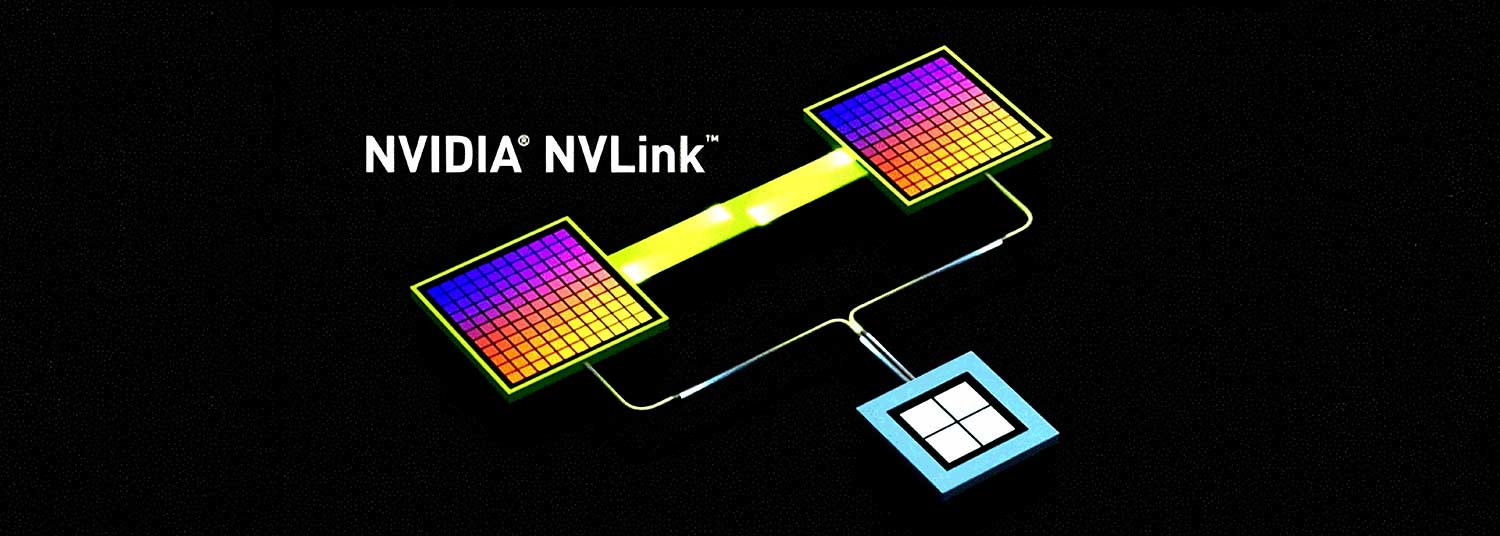
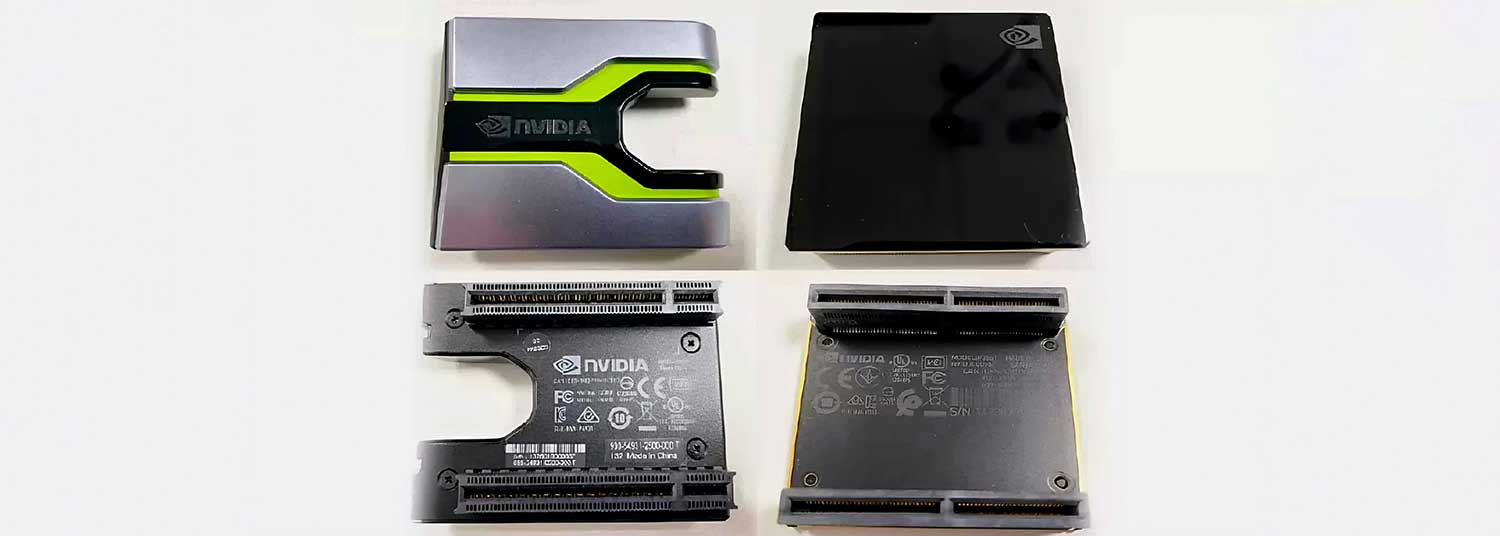
NVLink یک رابط ارتباطی پرسرعت با تأخیر بسیار پایین است که به‌طور خاص برای ارتباط مستقیم GPUها با یکدیگر و همچنین اتصال GPUها به CPUهای سازگار طراحی شده است. کلید واژه در این تعریف، کلمه «مستقیم» است. برخلاف معماری متمرکز PCIe که داده‌ها باید از پل ارتباطی چیپ‌ست و گذرگاه‌های اشتراکی عبور کنند، NVLink امکان برقراری ارتباطی مشبک یا Mesh-style را فراهم می‌آورد. این ارتباط مستقیم، مزیت دوچندان دارد: نخست آنکه پهنای باند قابل‌دسترس برای هر GPU به طور چشمگیری افزایش می‌یابد و هر جفت از GPUها می‌توانند بدون رقابت بر سر منابع مشترک با یکدیگر تبادل داده کنند. دوم آنکه تأخیر ناشی از دخالت CPU و گذر از لایه‌های نرم‌افزاری میانی حذف می‌شود. در عمل، تأخیر ارتباطی در NVLink به کمتر از یک میکروثانیه می‌رسد که در مقایسه با ده‌ها میکروثانیه PCIe، یک پیشرفت انقلابی است.

فناوری NVLink

این فناوری تنها به یک کابل ارتباطی ساده محدود نمی‌شود، بلکه یک مجموعه سخت‌افزاری و نرم‌افزاری کامل است. هسته اصلی این فناوری در سامانه‌های بزرگ، تراشه‌های NVLink Switch هستند. این تراشه‌ها با ایجاد یک شبکه تماماً متصل یا All-to-All میان GPUها، امکان می‌دهند تا هر جفت از GPUها با حداکثر سرعت ممکن با یکدیگر تبادل داده کنند. به عبارت دیگر، در یک سامانه مجهز به NVLink Switch، دیگر خبری از گلوگاه اشتراک‌گذاری پهنای باند میان چندین GPU نیست. هر GPU می‌تواند به طور همزمان با تمام GPUهای دیگر در بالاترین نرخ ممکن ارتباط برقرار کند. این قابلیت برای الگوریتم‌هایی مانند کاهش توزیع‌شده یا All-Reduce که در آموزش مدل‌های عمیق بسیار پرکاربرد هستند، حیاتی است.

تکامل نسل‌ها و پهنای باند

فناوری NVLink از زمان معرفی تاکنون دستخوش تحولات سریعی بوده است. هر نسل از این فناوری تقریباً دو برابر نسل قبل پهنای باند ارائه داده است و انویدیا را قادر ساخته تا همگام با رشد تصاعدی نیازهای محاسباتی حرکت کند.

فناوری NVLink

نسل اول NVLink که در سال ۲۰۱۶ عرضه شد، پهنای باند ۱۶۰ گیگابایت بر ثانیه به ازای هر GPU ارائه می‌داد که در آن زمان، جهشی چشمگیر نسبت به PCIe نسل سوم محسوب می‌شد.

نسل دوم با معماری Volta در سال ۲۰۱۷، این رقم را به ۳۰۰ گیگابایت بر ثانیه رساند. نسل سوم که در معماری Ampere در سال ۲۰۲۰ معرفی شد، پهنای باند ۶۰۰ گیگابایت بر ثانیه را ارائه کرد. در نسل چهارم که با معماری NVIDIA Hopper معرفی شد، پهنای باند هر GPU به ۹۰۰ گیگابایت بر ثانیه رسید.

نسل پنجم که هم‌زمان با معماری NVIDIA Blackwell عرضه شد، این رقم را به یک هزار و هشتصد گیگابایت بر ثانیه یا ۱.۸ ترابایت بر ثانیه افزایش داد. اخیراً نیز نسل ششم این فناوری برای پلتفرم NVIDIA Rubin معرفی شده است که پهنای باند استثنایی سه هزار و ششصد گیگابایت بر ثانیه یا ۳.۶ ترابایت بر ثانیه به ازای هر GPU ارائه می‌کند.

این میزان پهنای باند بیش از چهارده برابر استاندارد PCIe نسل ششم است که حداکثر ۲۵۶ گیگابایت بر ثانیه پهنای باند دوطرفه دارد.

برای درک بهتر این اعداد، باید به توان تجمیع‌شده در یک سامانه کامل توجه کرد. برای نمونه، در سامانه مرجع GB200 NVL72 که از ۷۲ GPU و ۳۶ پردازنده مرکزی Grace استفاده می‌کند، پهنای باند کل تجمیع‌شده به یکصد و سی ترابایت بر ثانیه می‌رسد. این میزان پهنای باند عظیم امکان هماهنگی لحظه‌ای میان همه پردازنده‌ها را در حین اجرای مدل‌های بزرگ هوش مصنوعی فراهم می‌سازد.

مزایای کلیدی و قابلیت‌های نرم‌افزاری

افزایش صرف پهنای باند، تنها مزیت NVLink نیست. این فناوری با ایجاد فضای آدرس حافظه یکپارچه یا Unified Memory Space میان GPUهای متصل، برنامه‌نویسی را برای توسعه‌دهندگان ساده‌تر می‌کند. در این مدل، برنامه‌نویس می‌تواند بدون نگرانی از محل فیزیکی داده، به یک آدرس حافظه واحد در سراسر همه GPUها دسترسی داشته باشد. سخت‌افزار NVLink به طور خودکار ترجمه آدرس و انتقال داده‌ها را در پس‌زمینه انجام می‌دهد. همچنین، مکانیزم‌های توکار برای تحمل خطا و Resiliency در نظر گرفته شده است که امکان تعویض قطعات بدون خاموش کردن سامانه یا Hot-swapping را فراهم می‌کند. در یک مرکز داده بزرگ، قابلیت تعویض یک ماژول معیوب بدون توقف محاسبات روی هزاران GPU دیگر، ارزش اقتصادی عظیمی دارد.

از منظر نرم‌افزاری، انویدیا کتابخانه‌های ارتباطی قدرتمندی مانند NCCL یا NVIDIA Collective Communications Library را ارائه داده است. این کتابخانه‌ها به‌طور خودکار از توپولوژی NVLink برای بهینه‌سازی عملیات جمعی مانند All-Reduce، Broadcast و Scatter-Gather بهره می‌برند. سرویس دیگری به نام IMEX یا Internode Memory Exchange نیز مدیریت حافظه اشتراکی میان گره‌های مختلف را تسهیل می‌کند. این لایه نرم‌افزاری باعث می‌شود تا برنامه‌های کاربردی بدون تغییر در کد اصلی، از مزایای پهنای باند بالای NVLink بهره‌مند شوند. در مجموع، NVLink ترکیبی از سخت‌افزار پیشرفته و نرم‌افزار هوشمند است که شکاف میان قابلیت‌های فیزیکی و کاربردپذیری عملی را پر می‌کند.

NVLink Fusion و چشم‌انداز آینده

انویدیا به تازگی توسعه فناوری جدیدی به نام NVLink Fusion را آغاز کرده است. این فناوری به شرکت‌های بزرگ فعال در حوزه ابری و ابرمقیاس یا Hyperscalerها اجازه می‌دهد تا پردازنده‌های سفارشی خود را نیز به شبکه NVLink متصل کنند.

با استفاده از استانداردهای باز مانند UCIe یا Universal Chiplet Interconnect Express، این شرکت‌ها می‌توانند پردازنده‌های اختصاصی یا XPU خود را طراحی کرده و آن‌ها را با استفاده از تراشه‌های NVLink به GPUهای انویدیا متصل نمایند.

این رویکرد، بسته‌ای بودن اکوسیستم انویدیا را تا حدی کاهش می‌دهد و امکان سفارشی‌سازی برای نیازهای خاص هر مشتری را فراهم می‌کند. در آینده، می‌توان انتظار داشت که NVLink به استانداردی واقعی برای ارتباطات درونی در مراکز داده تبدیل شود، جایگاهی که امروز InfiniBand و Ethernet برای ارتباط بین‌راکی دارند.

نتیجه‌گیری

فناوری NVLink تحولی بنیادین در نحوه ارتباط پردازنده‌های گرافیکی در مراکز داده مدرن ایجاد کرده است. این فناوری با غلبه بر محدودیت‌های ذاتی گذرگاه PCIe از طریق ارائه پهنای باند بسیار بالا، تأخیر فوق‌العاده پایین و ایجاد فضای حافظه یکپارچه، نیازهای شدید محاسباتی برنامه‌های پیشرفته برای سیستم های هوش مصنوعی و شبیه‌سازی‌های علمی را برآورده می‌سازد.

فناوری NVLink

از سامانه‌های کوچک چهار GPU تا اَبَررایانه‌های غول‌پیکر متشکل از هفتاد و دو GPU در یک شاسی، NVLink به عنوان ستون فقرات محاسباتی عمل می‌کند.

با معرفی قابلیت‌هایی مانند NVLink Fusion، این فناوری مسیر خود را به سوی آینده‌ای بازتر و قابل سفارشی‌سازی ادامه می‌دهد و نقش محوری خود را در عصر هوش مصنوعی و محاسبات با عملکرد بالا تثبیت می‌کند. بدون شک، پیشرفت‌های آینده در زمینه هوش مصنوعی، تا حد زیادی مرهون توانایی فنّاوری‌هایی مانند NVLink در هماهنگ‌سازی هزاران پردازنده به صورت یکپارچه و کارآمد خواهد بود.

LLM چیست

LLM چیست ؟

در سال‌های اخیر، پیشرفت‌های چشمگیر در حوزه هوش مصنوعی منجر به ظهور فناوری‌ای به نام «مدل زبانی بزرگ» گردیده است.
این مدل‌ها توانسته‌اند نحوه تعامل انسان با رایانه را دگرگون سازند و در زمینه‌های گوناگونی همچون آموزش، پزشکی، حقوق و تولید محتوا به کار گرفته شوند.

مدل زبانی بزرگ یا Large Language Model که به اختصار LLM نامیده می‌شود، نوعی سیستم هوش مصنوعی است که برای درک، تولید و دستکاری زبان طبیعی طراحی شده است. در ادامه از این مطلب از دیجی بینو بیشتر با این سیستم آشنا می شویم.

منظور از زبان طبیعی، زبانی است که انسان‌ها به صورت روزمره با یکدیگر گفتگو می‌کنند؛ مانند زبان فارسی، انگلیسی یا سایر زبان‌های رایج. این مدل‌ها با استفاده از حجم عظیمی از داده‌های متنی – شامل کتاب‌ها، مقاله‌های علمی، وب‌سایت‌ها، خبرنامه‌ها و سایر منابع نوشتاری – آموزش می‌بینند و قادرند بر اساس ورودی کاربر، پاسخ‌هایی منسجم، مرتبط و طبیعی تولید نمایند.
امروزه نمونه‌های متعددی از مدل‌های زبانی بزرگ در دسترس عموم قرار دارد. از مشهورترین آن‌ها می‌توان به سری مدل‌های GPT از شرکت OpenAI، مدل Gemini از گوگل، مدل Llama از متا و مدل Claude از شرکت Anthropic اشاره نمود. این مدل‌ها در پلتفرم‌های مختلفی مانند چت‌بات‌ها، دستیارهای صوتی، ابزارهای ترجمه خودکار و سامانه‌های پاسخ‌گویی هوشمند به کار رفته‌اند و روزبه‌روز بر توانمندی‌های آن‌ها افزوده می‌شود.

LLM چیست

تاریخچه مختصر مدل‌های زبانی بزرگ

برای درک بهتر مدل‌های زبانی بزرگ، آشنایی با سیر تحول آن‌ها مفید خواهد بود. ریشه این فناوری به دهه ۱۹۵۰ میلادی و تلاش‌های اولیه برای ترجمه ماشینی بازمی‌گردد.

در آن سال‌ها، پژوهشگران از روش‌های مبتنی بر قواعد دستوری و فرهنگ‌های لغت استفاده می‌کردند که کارآمدی چندانی نداشت. در دهه ۱۹۸۰ و ۱۹۹۰، رویکردهای آماری وارد این حوزه شد و مدل‌هایی مانند «n-gram» توانستند با محاسبه احتمال وقوع کلمات در کنار یکدیگر، متونی ساده تولید نمایند.
نقطه عطف اصلی در سال ۲۰۱۷ رخ داد. در این سال، گروهی از پژوهشگران شرکت گوگل معماری جدیدی به نام «ترانسفورمر» (Transformer) را معرفی کردند.

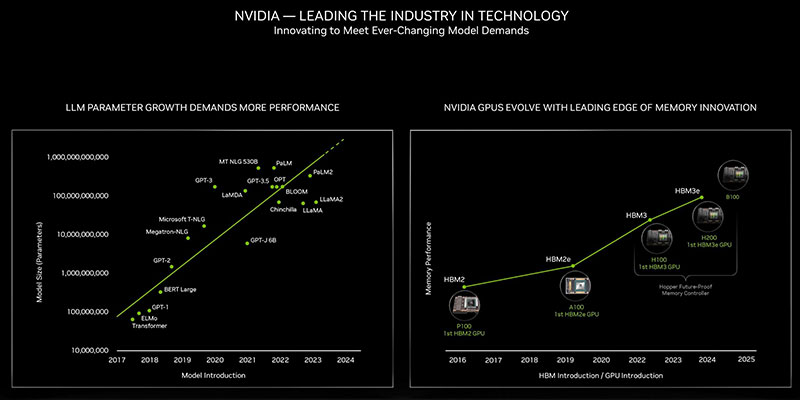
این معماری بر خلاف روش‌های پیشین که داده‌ها را به صورت ترتیبی پردازش می‌کردند، قادر بود به طور همزمان به تمام بخش‌های یک جمله توجه نماید. این قابلیت که «مکانیزم توجه» نامیده می‌شود، باعث شد مدل‌های زبانی بتوانند روابط دوربرد میان کلمات را بهتر درک کنند و متونی روان‌تر و دقیق‌تر تولید نمایند.
LLM چیست

پس از معرفی ترانسفورمر، شرکت OpenAI در سال ۲۰۱۸ اولین نسخه مدل GPT را منتشر کرد.این مدل با ۱۱۷ میلیون پارامتر توانست توجه جامعه علمی را به خود جلب نماید.

دو سال بعد، GPT-3 با ۱۷۵ میلیارد پارامتر عرضه شد و تحولی شگرف در توانایی تولید متن ایجاد کرد. از آن زمان تاکنون، مدل‌های بزرگ‌تر و پیچیده‌تری با قابلیت‌های چندوجهی – یعنی توانایی پردازش همزمان متن، تصویر، صدا و ویدئو – پا به عرصه وجود نهاده‌اند

ساختار فنی

این مدل‌ها را می‌توان به مثابه شبکه‌ای عظیم از واحدهای محاسباتی تشبیه نمود که هر یک نقش یک «نرون» ساده را ایفا می‌کند. این نرون‌ها در لایه‌های گوناگونی سازماندهی شده‌اند و با یکدیگر ارتباط دارند.
جزء اصلی و کلیدی در معماری این مدل‌ها، «مکانیزم توجه» است. فرض کنید جمله «علی کتابی را که دیروز از کتابخانه امانت گرفته بود، روی میز گذاشت» را در نظر بگیرید.

برای درک این جمله، مدل باید بداند ضمیر «بود» به کدام بخش جمله اشاره دارد و «آن» به چه چیزی تعلق می‌گیرد. مکانیزم توجه به مدل اجازه می‌دهد هنگام پردازش هر کلمه، به سایر کلمات جمله – حتی آنهایی که فاصله زیادی دارند – «توجه» کند و ارتباط میان آن‌ها را بیابد.

فرایند آموزش یک مدل زبانی بزرگ شامل دو مرحله اصلی است. مرحله نخست، «پیش‌آموزش» نام دارد. در این مرحله، مدل حجم عظیمی از متن‌های بدون برچسب را دریافت می‌کند و سعی می‌کند کلمه بعدی یک جمله را پیش‌بینی نماید.

به عنوان مثال اگر جمله ناتمام «هوا امروز بسیار …» به مدل داده شود، مدل بر اساس الگوهایی که از میلیاردها جمله مشابه دیده است، کلماتی مانند «سرد»، «گرم» یا «بارانی» را با درجاتی از احتمال پیشنهاد می‌کند. این مرحله بسیار پرهزینه است و نیاز به هزاران پردازنده گرافیکی قدرتمند و هفته‌ها زمان محاسبات دارد.
مرحله دوم «تنظیم دقیق» با نظارت انسان نامیده می‌شود. در این مرحله، مدل با استفاده از پرسش و پاسخ‌هایی که توسط انسان‌های متخصص تهیه شده است، آموزش می‌بیند تا پاسخ‌های مفید، بی‌ضرر و صادقانه ارائه دهد. همچنین از تکنیکی به نام «یادگیری تقویتی با بازخورد انسانی» استفاده می‌شود که در آن مدل با دریافت امتیاز از سوی انسان‌های ارزیاب، رفتار خود را بهبود می‌بخشد.

کاربردهای عملی مدل‌های زبانی بزرگ

دامنه کاربرد مدل‌های زبانی بزرگ بسیار گسترده است و هر روز بر تعداد زمینه‌های استفاده از آن‌ها افزوده می‌شود.

LLM چیست

اول: تولید و ویرایش متن

این مدل‌ها می‌توانند مقاله، نامه اداری، ایمیل، گزارش کاری، شعر، داستان کوتاه و حتی فیلمنامه بنویسند. همچنین قادرند متن‌های طولانی را خلاصه کرده، غلط‌های املایی و نگارشی را اصلاح نمایند و سبک نوشتار را به درخواست کاربر تغییر دهند.

دوم: پاسخ به پرسش و گفتگو

چت‌بات‌های مبتنی بر مدل‌های زبانی بزرگ می‌توانند به عنوان دستیار مجازی در وب‌سایت‌ها، اپلیکیشن‌های موبایل و دستگاه‌های هوشمند به پرسش‌های کاربران پاسخ دهند. این دستیاران قادرند در موضوعات تخصصی مانند فناوری اطلاعات، پزشکی، حقوق و روانشناسی اطلاعات نسبتاً دقیقی ارائه نمایند.

سوم: ترجمه خودکار

کیفیت ترجمه ماشینی با استفاده از مدل‌های زبانی بزرگ به طور قابل توجهی بهبود یافته است. این مدل‌ها نه تنها کلمات را معادل‌یابی می‌کنند، بلکه بافت جمله، اصطلاحات فرهنگی و لحن متن را نیز در ترجمه لحاظ می‌نمایند.

چهارم: تحلیل احساسات و نظرکاوی

کسب‌وکارها از این قابلیت برای تحلیل نظرات مشتریان در شبکه‌های اجتماعی، نظرسنجی‌ها و بخش نظرات وب‌سایت خود استفاده می‌کنند. مدل می‌تواند تشخیص دهد که یک نظر مثبت است، منفی است یا خنثی و حتی شدت احساسات را نیز اندازه‌گیری نماید.

پنجم: کمک به آموزش و پژوهش

دانشجویان و پژوهشگران می‌توانند از این مدل‌ها برای یافتن منابع مرتبط، تولید ایده اولیه برای تحقیق، بررسی ساختار مقالات و شبیه‌سازی مصاحبه‌های علمی بهره ببرند. البته باید توجه داشت که این مدل‌ها جایگزین تفکر انتقادی و پژوهش مستقل انسان نیستند.

محدودیت‌ها و چالش‌های پیش رو

با وجود توانمندی‌های چشمگیر، مدل‌های زبانی بزرگ با محدودیت‌ها و چالش‌های متعددی مواجه هستند که آگاهی از آن‌ها برای استفاده مسئولانه از این فناوری ضروری است.
LLM چیست

پدیده توهم:

یکی از مهم‌ترین چالش‌ها، «توهم» یا تولید اطلاعات نادرست با لحنی کاملاً قاطع و باورپذیر است. مدل ممکن است به پرسشی که پاسخ آن را نمی‌داند، جمله‌ای خوش‌ساخت اما کاملاً نادرست تولید نماید. برای مثال ممکن است از کتابی نقل قول کند که هرگز نوشته نشده است یا تاریخی را به اشتباه ذکر کند. این ویژگی به دلیل ماهیت آماری مدل‌های زبانی بزرگ ذاتی آن‌هاست و به طور کامل قابل حذف نمی‌باشد.

سوگیری داده‌ها:

دل‌های زبانی بزرگ بر روی متونی آموزش می‌بینند که توسط انسان‌ها نوشته شده است. این متون ناخودآگاه حامل سوگیری‌های فرهنگی، جنسیتی، نژادی و اجتماعی هستند. بنابراین مدل نیز ممکن است همان سوگیری‌ها را بازتولید کند. برای کاهش این مشکل، پژوهشگران تلاش می‌کنند داده‌های آموزشی را متوازن‌تر نمایند و در مرحله تنظیم دقیق، رفتار مدل را اصلاح کنند.

هزینه محاسباتی و مصرف انرژی:

آموزش یک مدل زبانی بزرگ با میلیاردها پارامتر نیازمند هزاران پردازنده گرافیکی و مصرف برق بسیار بالایی است. این موضوع هم از نظر اقتصادی پرهزینه است و هم نگرانی‌هایی درباره تأثیرات زیست‌محیطی آن وجود دارد. به عنوان مثال، آموزش یک مدل بزرگ می‌تواند به اندازه چندین خودروی سواری در طول عمر مفید خود، دی‌اکسید کربن تولید کند.

حریم خصوصی و امنیت داده‌ها:

مدل‌های زبانی بزرگ ممکن است اطلاعات حساسی را که در داده‌های آموزشی وجود داشته است، به خاطر بسپارند و در پاسخ به کاربران تکرار کنند. همچنین امکان استفاده از این مدل‌ها برای تولید محتوای نادرست، اخبار جعلی، ایمیل‌های فیشینگ یا هرزنامه وجود دارد. این مسائل نیازمند وضع قوانین و مقررات روشن برای توسعه و کاربرد این فناوری است.

نتیجه‌گیری

مدل‌های زبانی بزرگ یکی از تأثیرگذارترین فناوری‌های هوش مصنوعی در دهه اخیر محسوب می‌شوند. این مدل‌ها با درک عمیق از ساختار و معنای زبان طبیعی، توانسته‌اند مرزهای تعامل انسان و ماشین را جابه‌جا کنند و در حوزه‌های متنوعی از آموزش و پژوهش گرفته تا تجارت و سرگرمی کاربرد پیدا نمایند.
با این حال، استفاده مؤثر و مسئولانه از این فناوری مستلزم آگاهی از محدودیت‌های آن است. پدیده توهم، سوگیری داده‌ها، هزینه‌های بالای محاسباتی و نگرانی‌های حریم خصوصی از جمله چالش‌هایی هستند که پژوهشگران و سیاست‌گذاران باید به آن‌ها توجه ویژه داشته باشند.
چشم‌انداز آینده مدل‌های زبانی بزرگ به سمت مدل‌های چندوجهی (قادر به درک همزمان متن، تصویر، صدا و ویدئو)، کارآمدتر از نظر مصرف انرژی و قابل اعتمادتر از نظر صحت اطلاعات حرکت می‌کند. همچنین انتظار می‌رود قوانین و مقررات روشن‌تری برای توسعه و کاربرد این فناوری در سطح ملی و بین‌المللی تدوین گردد.

در نهایت، مدل‌های زبانی بزرگ نه جایگزین هوش و خلاقیت انسان، بلکه ابزاری قدرتمند در دست انسان هستند تا با بهره‌گیری هوشمندانه از آن، توانایی‌های خود را در پردازش اطلاعات و تولید دانش ارتقا بخشند.